ARTICLE · 1048842
壬远 AI 网关 UI 自动化测试实战
UI自动化测试体系建设的缘起
壬远 AI 网关(https://github.com/rainway-ai-gateway)是面向 AI 流量治理的开源网关,Web 控制台(https://github.com/rainway-ai-gateway/ai-gateway-web)模块众多、表单复杂,且模块之间存在依赖,每次发版需要回归的路径很多,靠人工逐页点验不现实。因此需要通过 UI 自动化测试将关键测试路径固定下来,在每次改动后自动回归。
我们从零搭建了一套基于 Playwright 的 UI 自动化测试体系,测试仓库 ai-gateway-web-test(https://github.com/rainway-ai-gateway/ai-gateway-web-test)也已开源,用例覆盖了全部模块。整套UI自动化测试方案落地之后,真正值得沉淀的不是测试脚本,而是利用大模型建设UI自动化测试这套方法本身。本文先说明全模块覆盖的自动化测试维护难题,再回顾业界已有的方案和我们的两次失败尝试,然后重点介绍最终走通的三步生成方法和 skill 的规则化沉淀,最后给出这套方法的适用边界和实际效果。
UI全模块覆盖的自动化测试维护难题
我们的目标是让自动化测试覆盖控制台UI的全部模块。要达到这个目标,难点不在 Playwright 本身,而在三个相互加剧的因素:
页面经常变化
按钮文案、控件位置、表单结构都会随产品演进调整,而脚本依赖的正是这些细节。
用例数量大
覆盖全部模块需要上百条用例,不是几十条。
改动牵连面广
页面每修改一处,就需要回头排查并修改一批脚本。
三个因素叠加,形成了"用例越多越依赖页面细节、页面变动越频繁维护成本越高"的局面。换句话说,真正要解决的不是"怎么写出一条脚本",而是"怎么让上百条脚本在页面持续变化的情况下维护得起"。为此,我们引入大模型来承担场景、用例、脚本的生成,把人工的主要精力放在文档上。
从这个问题出发,可行的自动化方案至少要满足三点:主链路之外的校验与完整场景也在覆盖范围内;文案、控件发生变化时,脚本不能大面积失效;修改应当集中在一处,而非几十条脚本同时改动。
业界已有的方案
UI 自动化测试发展到现在,业界已有的做法大致分为几类。
录制回放
录一次只能跑一次,页面一变即失效。
Page Object Model(POM)
把定位收拢到一处,但只是集中了脆弱性,并没有消除它,业界统计维护仍占自动化投入的三到四成。
模型驱动测试(MBT)
从状态模型生成用例,模型本身的搭建成本很高。
大模型直接生成测试例
最近一年开始流行。但直接生成的代码存在"猜测"的成分,有实测显示一次跑不通的比例超过六成,常见问题包括选择器幻觉、缺等待、断言错误。
这些方案要么解决不了页面变化带来的维护问题,要么整体成本过高。
两次失败的尝试
在上述方案之外,我们自己还尝试过两条捷径,分别止步于不同环节。
对着页面直接生成测试例
大模型生成代码的速度很快,但生成的脚本与页面细节强耦合:按钮按文案定位,控件按出现顺序查找。产品将「确定」改为「确认」时,功能本身没有任何变化,脚本却会报错;此时还需要额外排查,才能判断是产品真的出了问题,还是脚本将文案写死所致。
这并非模型能力不足,而在于生成之前没有明确测什么、怎么点、什么叫对。缺少这份说明,模型只能依据页面表象推测,偏差由此产生,这条路径也因此走不通。
过早的框架设计
我们还走过另一个极端:在尚未编写用例之前,先将框架"盖全",分层、封装、脚手架一应俱全,连当时用不上的能力也预先留好。由此产生了三个问题。
语义被切碎
分层的本意是"用例只写业务步骤、不碰页面细节",但要真正看懂一条用例测了什么,需要在多层封装之间反复跳转。业务语义被埋在层层封装之下,读一条用例要翻好几个文件。
投入时间偏长
版本环境、页面差异对比、鉴权检查都被做成了重型子系统,框架越搭越复杂,迟迟产不出用例。
为抽象而抽象
预留能力、严格类型、测试运行时的专用封装,单独看都合理,叠加在一起便形成了框架喧宾夺主、用例反而沦为配角的局面。
这条路径的根因在于分层边界没定对:分层是为了复用,不是为了抽象而抽象,过度分层反而让用例读不出语义。
走通的路径:文档先行的三步生成
针对这两个根因,我们的方法是把顺序反过来:先将说明书写清楚,再让模型照着生成。人工的主环节在文档;生成之后仍需用几条标杆用例将脚本跑通,而不是默认代码一次就能通过。分层只服务于复用,可多可少,边界由"用例能不能读得懂"来决定。
这里说的说明书,在仓库里每个模块固定两份,简称 01(场景)和 02(用例)。01 回答"测什么",02 回答"怎么点、什么叫对",第三步按 02 生成可跑的脚本。覆盖是否完整,首先取决于 01/02 是否写全:文档遗漏了场景,生成的脚本也会相应遗漏。
仓库结构速览
在看三步生成之前,先了解 ai-gateway-web-test(https://github.com/rainway-ai-gateway/ai-gateway-web-test)的目录怎么组织。仓库里每个模块都有固定的对应关系:
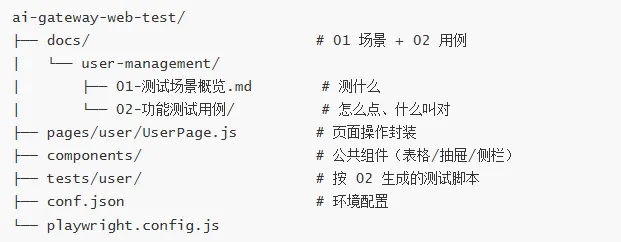
文档(docs)→ 页面封装(pages)→ 测试脚本(tests),三层一一对应。02 用例文件名与 tests 文件名编号一致,00-索引与映射.md 记录了每条用例编号对应哪个测试文件。
核心思想
全模块 UI 自动化测试的难点不在写脚本,而在页面持续变化下的维护。直接让模型生成测试代码,模型只能"猜"页面细节——按钮叫"添加"还是"新建"、字段出现在第几个位置,猜错了脚本就跑不通。过早搭建框架把语义埋进层层封装,读一条用例要翻好几个文件。
这两个问题的根因是一样的:没在生成之前把"测什么、怎么点、什么叫对"定义清楚。
反过来就是这套方法的核心思想:先把说明书写清楚,再让模型照着生成。
说明书分两层:
01(场景)按用户故事线组织,回答"测什么";
02(用例)按功能模块展开,回答"怎么点、什么叫对"。
生成代码依赖的不是模型对页面的"猜测",而是 02 文档中写死的步骤和预期。
页面交互收拢到 pages/ 层,公共控件抽到 components/ 层,脚本只调封装方法——页面变化只改一处。生成时先跑通 3~5 条 P0 标杆,再批量铺开。踩坑经验沉淀为 skill 规则,约束后续生成。
人工的主环节从逐条改脚本,前移到文档把关和标杆验证。
落到操作上,就是"先场景、再用例、再脚本"的三步:
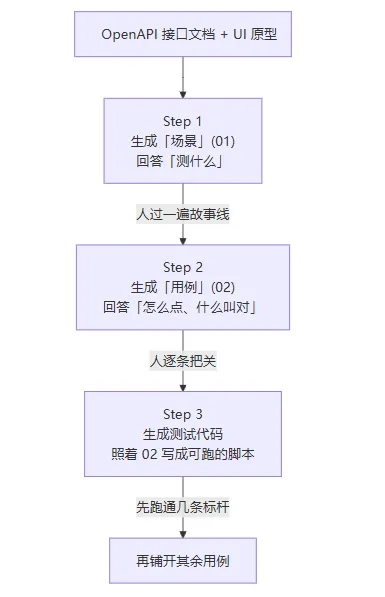
下面以"添加用户"为例,将三步完整走一遍。每一步先说明实际操作,再展示生成结果,读者可以照同样的方式为自己的模块生成。
第一步:生成场景(01)
实际操作: 让大模型读取 OpenAPI 接口文档中的字段定义、校验规则、接口语义,以及控制台的页面原型设计,据此生成按用户故事线组织的测试场景。
生成的结果如下,对应仓库文件 docs/user-management/01-测试场景概览.md(https://github.com/rainway-ai-gateway/ai-gateway-web-test/blob/main/docs/user-management/01-%E6%B5%8B%E8%AF%95%E5%9C%BA%E6%99%AF%E6%A6%82%E8%A7%88.md) :
场景一:管理员入职新员工
系统管理员为新入职的同事创建账号并分配权限,新员工首次登录系统。
步骤 操作 对应用例编号 优先级 1 管理员登录系统 UM-32 P0 2 点击「添加用户」,填写信息并提交 UM-04 P0 3 必填项校验、密码格式校验 UM-06, UM-08 P0–P1 4 搜索并确认新用户已出现在列表中 UM-02 P1 5 新员工使用新账号首次登录(复用 UM-32,换个账号即可) UM-32 P0
这里描述的是"一件完整的事":有人、有动机、有完整路径。每条步骤都对应了具体的用例编号(UM-xx),后续 02 文档就按这些编号逐条展开。这一步人工只审核故事线,需要确认故事是否真实、路径是否走得通,确认无误后进入第二步。
第二步:生成用例(02)
实际操作: 将第一步产出的 01-测试场景概览.md 给大模型,让它根据内容生成详细的测试用例,为每条用例输出前置条件、分步操作、预期结果、测试数据。生成结果按功能分文件放在 docs/user-management/02-功能测试用例/ 目录下(如 02-添加用户.md、03-修改密码.md 等)。以成功的正向用例 UM-04 为例:
仓库文件:docs/user-management/02-功能测试用例/02-添加用户.md(https://github.com/rainway-ai-gateway/ai-gateway-web-test/blob/main/docs/user-management/02-%E5%8A%9F%E8%83%BD%E6%B5%8B%E8%AF%95%E7%94%A8%E4%BE%8B/02-%E6%B7%BB%E5%8A%A0%E7%94%A8%E6%88%B7.md)
用例 UM-04 添加用户-成功场景|优先级 P0
前置:已登录并进入用户管理页面
步骤:
点击「添加用户」→ 右侧弹出抽屉面板
填入用户名(如
user_20260702203000)、密码、确认密码点击「添加」→ 抽屉关闭
搜索该用户名 → 列表中能看到新用户
测试数据:用户名
user_{时间戳},密码password123(8–128 字符、无空白)
同一文件中还有异常用例,与正向用例形成对照。以 UM-06(必填项校验)为例:
用例 UM-06 添加用户-必填项校验|优先级 P0
前置:已登录并进入用户管理页面
步骤:
点击「添加用户」→ 右侧弹出抽屉面板
不填写任何字段,直接点击「添加」→ 页面提示「用户名不能为空」「密码不能为空」
仅填写用户名,再次点击「添加」→ 页面提示「密码不能为空」
测试数据:用户名
test_user,密码留空
UM-08(密码格式校验)等其余异常用例格式相同——前置条件 + 分步操作 + 预期结果 + 测试数据。
这一步需要人工逐条把关:步骤能否照着执行、预期结果是否写清楚、是否与实际页面一致。这里把关越严格,后续生成的代码越可靠——这是整条链路中最不能省略的人工环节。
第三步:生成测试代码
实际操作: 将 02 用例文档交给大模型,让它按照 skill 规则先生成页面封装 UserPage.js,再根据用例步骤生成 Playwright 测试代码。
页面封装的思路是:脚本中不写死"去点那个叫添加的按钮"。按钮上的文字、控件的定位方式,集中收拢在 pages/user/UserPage.js(https://github.com/rainway-ai-gateway/ai-gateway-web-test/blob/main/pages/user/UserPage.js)中;各页面共用的表格、抽屉、表单,再抽取到 components/ 目录下的公共组件。这样,当产品将「添加用户」改为「新建用户」时,只需修改 UserPage.js 中一处;倘若几十条脚本中都写着点「添加用户」,文案一变便会一起失效。
页面封装(UserPage.js)暴露的方法大致如下——定位和交互细节藏在这里,脚本只做调用:
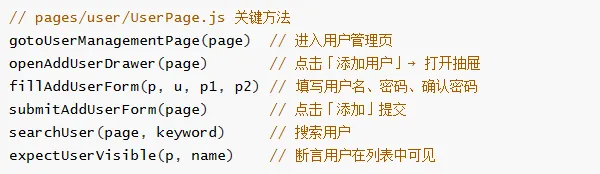
页面封装就绪后,以 UM-04 为例,生成的测试文件 tests/user/test_02_user_add.spec.js(https://github.com/rainway-ai-gateway/ai-gateway-web-test/blob/main/tests/user/test_02_user_add.spec.js)只做三件事——标注用例编号、按 02 步骤分组、调 UserPage 方法:
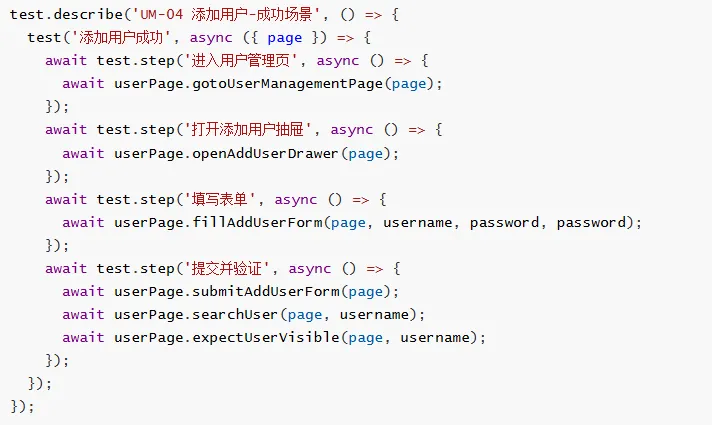
UM-06(必填校验)等异常用例同样按 02 逐条生成,结构一致——describe 挂用例编号、step 对应操作步骤。脚本只描述业务步骤,不自行查找按钮;页面文案变更时只改 UserPage.js 一处即可。
测试代码生成的几条经验
在生成代码这一步,我们积累了以下经验。
先生成并跑通标杆用例,再批量铺开
不要一开始就按 02 铺满整个模块,先挑选 3~5 条主干用例(能进入页面、能创建成功、必填校验能正确拦截),确认全部跑通后再批量生成。标杆未跑通便全面铺开,等于把同一个错误复制到每条用例上。以用户管理为例,
test_02_user_add.spec.js先跑通 UM-04/UM-06/UM-08 三条之后再展开其余用例。公共控件先封装成一份
表格用 PageTable,抽屉用 IvuDrawerComponent,弹窗用 IvuModalComponent,侧栏用 AppSidebarComponent——这些公共组件若不提前收拢到
components/目录,每条脚本就得各自对着页面摸索一遍;收拢成一份之后,修改一处,各页面便一并更新。环境异常尽早中止,失败信息要对上用例编号
开跑前先确认能够登录(
global-setup.js统一处理),连不上就结束整轮。失败时先定位是哪条用例、卡在哪一步——借助test.describe('... - UM-06 ...')的编号和test.step的分步描述,可以直接看到「添加用户-必填项校验(UM-06),卡在:不填写任何字段直接提交」,而不是一长串堆栈。
Skill:踩坑经验的规则化沉淀
三步生成解决的是"这一次怎么生成"。要让方法覆盖整个控制台、并且在下一次仍然有效,还需要一层机制:把这次踩过的坑沉淀下来,反过来约束下一次生成。
skill 就是这样一份规则清单,仓库文件 .trae/skills/ai-gateway-test-generation/SKILL.md(https://github.com/rainway-ai-gateway/ai-gateway-web-test/blob/main/.trae/skills/ai-gateway-test-generation/SKILL.md),在每次生成前自动加载,上述经验(先跑通标杆再铺开、动态命名、公共控件优先)都收录其中。模型在生成前就能读到它,须照此执行,而不是生成之后再由人工逐条修正。
文档与 skill 是这套方法的两个侧面:文档是说明书,skill 是踩坑之后沉淀下来的约束。
这套方法的适用边界
这套方法并非适用于所有场景,这里按模块形态分两类说明。
适用:登录后可独立完成增删改查的管理模块
如用户、角色、配置等。这类模块文档易于编写、断言清晰、复用度高,是投入产出最高的场景。
需要权衡:强交互、跨模块强耦合、依赖时序或实时状态的长链路场景
这类场景的 01/02 编写成本更高,宜先跑通主干用例、再按需铺开,不宜追求全量覆盖。
另有一条边界与模块形态无关:01/02 的质量上限就是生成结果的上限。接口文档与原型不准确,人工基于文档的把关同样会出现偏差。
总结
回顾整个过程:全模块 UI 自动化的难点不在脚本编写,而在页面持续变化下的维护;直接让大模型生成、过早搭建框架这两条路都走不通,根因分别是缺少"测什么"的说明书和分层边界失当。走通的路径是把人工把关从代码前移到文档,按场景、用例、脚本三步生成,用标杆用例验证,并把踩坑经验沉淀进 skill,反过来约束后续生成。文档的质量上限就是生成结果的上限,这也是这套方法不能省略人工的原因。
从效果来看,纯手写约需 2~3 个月的工作被压缩到 3~4 周,其中包含文档把关、标杆验证和 skill 沉淀,并非一键生成即可。目前壬远控制台 9 个模块已全部实现自动化覆盖,测试仓库共 64 个测试文件;页面文案变更只需集中修改一处定位,发版时可一键跑全量,确认本次改动是否影响已有路径。上述实践的完整代码与文档均已开源。
作者简介
郑玉叠,瑛菲网络全栈开发工程师。
BFE 项目(2021 年起):加入后主要负责前端开发
瑛菲网络(2023 年至今):参与前端和后端开发;在壬远 AI 网关项目中负责 Web 控制台前端开发与 UI 自动化测试