ARTICLE · 1048837
百度公布天池超节点架构设计文档:一文读懂供电系统设计
一项大模型训练任务,可能连续运行数天。64张GPU通过高速网络组成一个计算整体,其中一路电源发生故障,如果保护和冗余没有接住,整项任务都可能中断。
所以,超节点的供电不能只看“总功率够不够”。它还要适应不同数据中心的输入条件,在某个电源模块退出后维持运行,并且尽早发现母排接点的异常发热。
百度最新开放的《天池超节点技术架构设计规范》,把这些问题写进了一套64卡整柜方案。文档中提出,天池超节点已经在百度百舸AI计算平台完成大规模部署验证,并实现主流大模型推理单卡吞吐提升数倍。
这套供电设计面向实际运行环境,已经走过了单纯样机展示的阶段。
需要完整版《百度天池超节点技术架构设计规范》的朋友,可以私信后台,领取完整PDF文档。
01|四种输入解决的是存量机房怎么接入
假设同一款天池机柜需要部署到两个数据中心:一个机房提供三相380V交流,另一个机房已经建设240V直流。如果整柜只接受一种输入,第二个项目就要改造前端供配电,部署周期和成本都会上升。
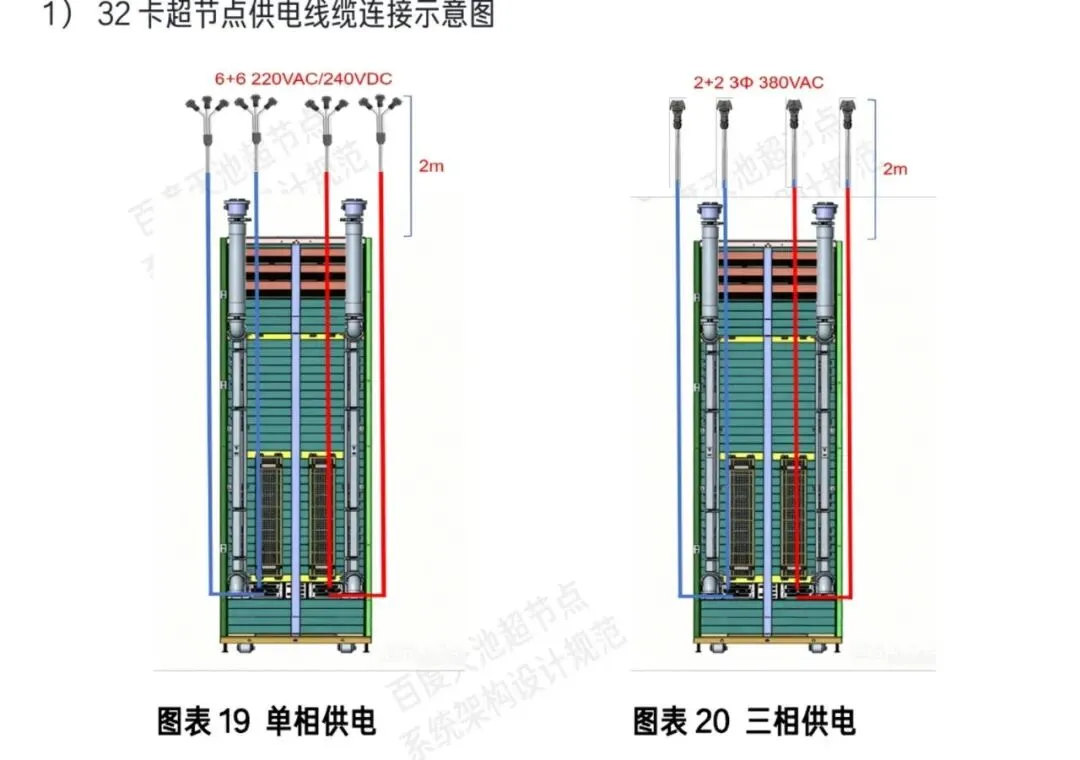
百度把这部分差异交给Power Shelf处理。规范列出了四种输入组合:单相交流双路、240V直流双路、单相交流与240V直流混合,以及三相交流双路。
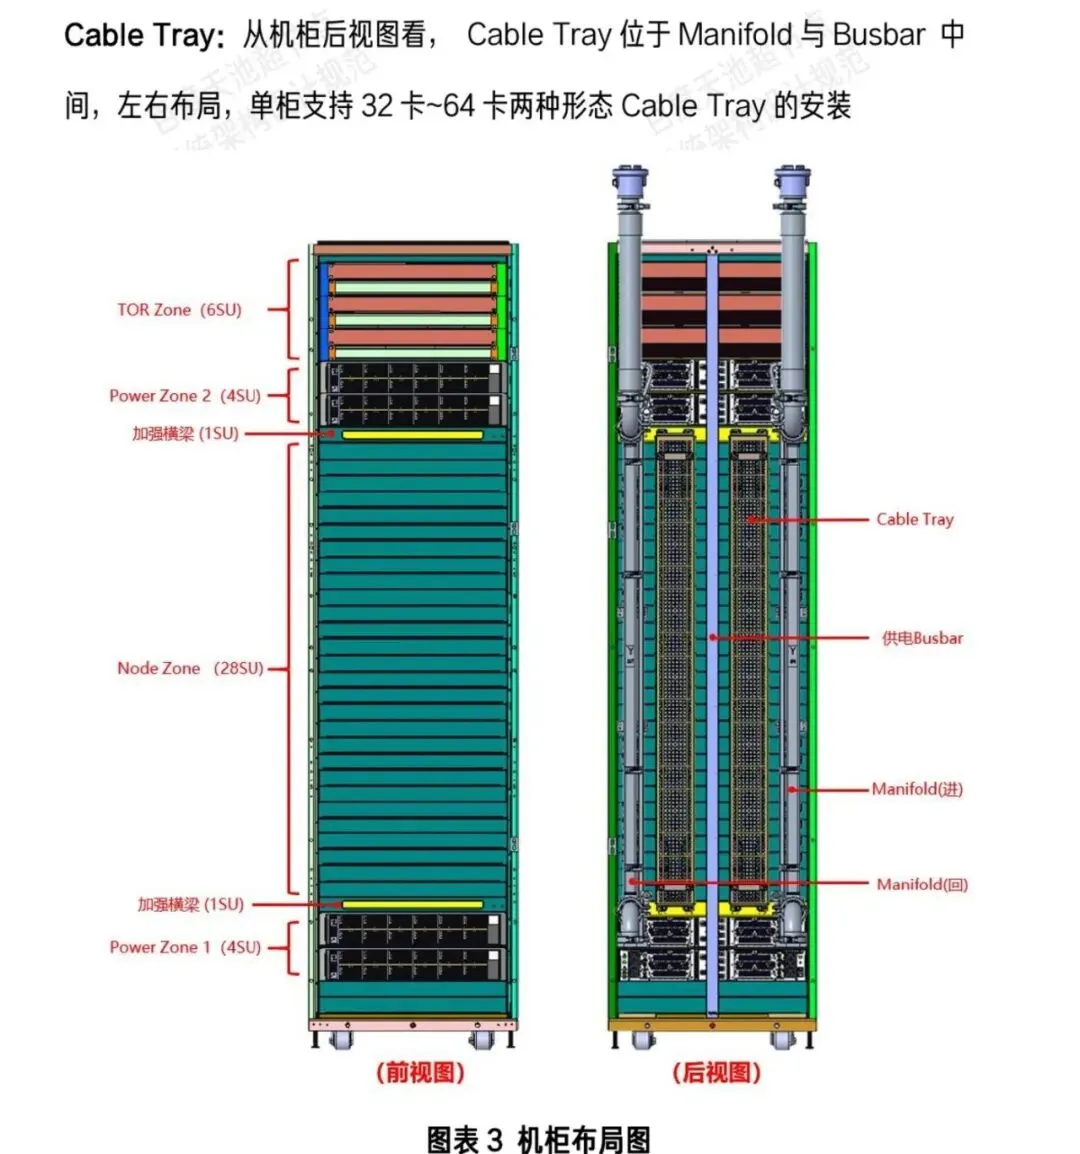
机房电源通过Power Whip进入Power Shelf,经过电源模块转换后统一形成54V输出,再由整柜Busbar给GPU计算节点和高速交换节点供电。无论前端接入交流还是240V直流,计算节点看到的都是同一套54V接口。
可以把Power Shelf理解成机房电源与计算节点之间的适配层。存量数据中心不必为了引入一款超节点,把原有供电路线全部推倒重建。项目现场主要调整Power Whip和输入配置,后面的计算节点、母排和管理逻辑可以继续复用。
这项设计也有代价。
兼容的输入类型越多,电源模块需要覆盖的工作范围越复杂,混合输入场景还要验证两路电源在动态切换、保护定值和故障恢复上的一致性。规格写着“支持”只是起点,现场能否稳定切换还要靠整柜测试。
02|一路电源掉线训练任务不能跟着停
天池每台Power Shelf安装12个3.3kW电源模块。每个模块都配有A、B两路独立输入,并集成ATS自动切换功能。
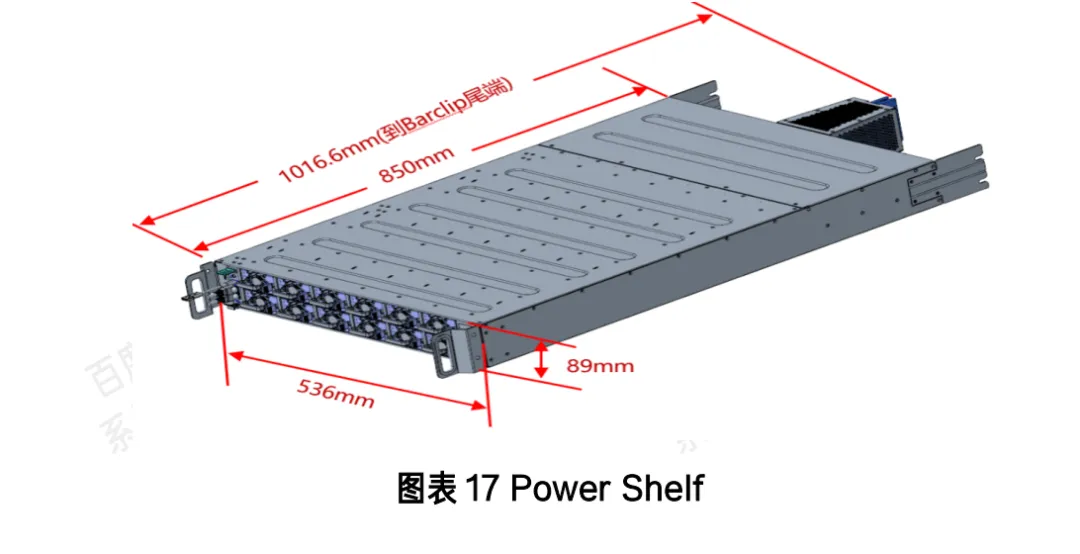
正常运行时,电源模块从默认回路取电。主回路失电后,模块自动切到备用回路;主回路恢复后再自动切回。规范要求整个过程中54V输出保持在±5%范围。
这项指标落到业务层面很好理解。机房一路电源发生波动时,GPU不应该察觉到明显的供电中断。切换过程中如果54V母线跌落过大,计算节点可能复位,运行了几天的训练任务就要重新开始。
百度还给业务交换机和ILO带外管理交换机安排了独立交流供电。Power Shelf后部提供3+3路冗余C13插座,这些管理设备不从算力54V母线取电。
发生算力供电故障时,带外管理通道仍有机会保持在线。运维人员可以远程查看告警、读取日志并定位故障。如果管理交换机和GPU共用同一故障域,机柜一旦失电,运维人员看到的往往只剩下“设备离线”。
03|N+1和N+2买到的是不同程度的保险
32卡天池配置一台Power Shelf,12个3.3kW电源模块全部装满。按照N+1运行,需要预留一个模块应对故障,可用功率为11×3.3kW,也就是36.3kW。整柜散热设计功耗为33kW,两者之间留有约10%的余量。
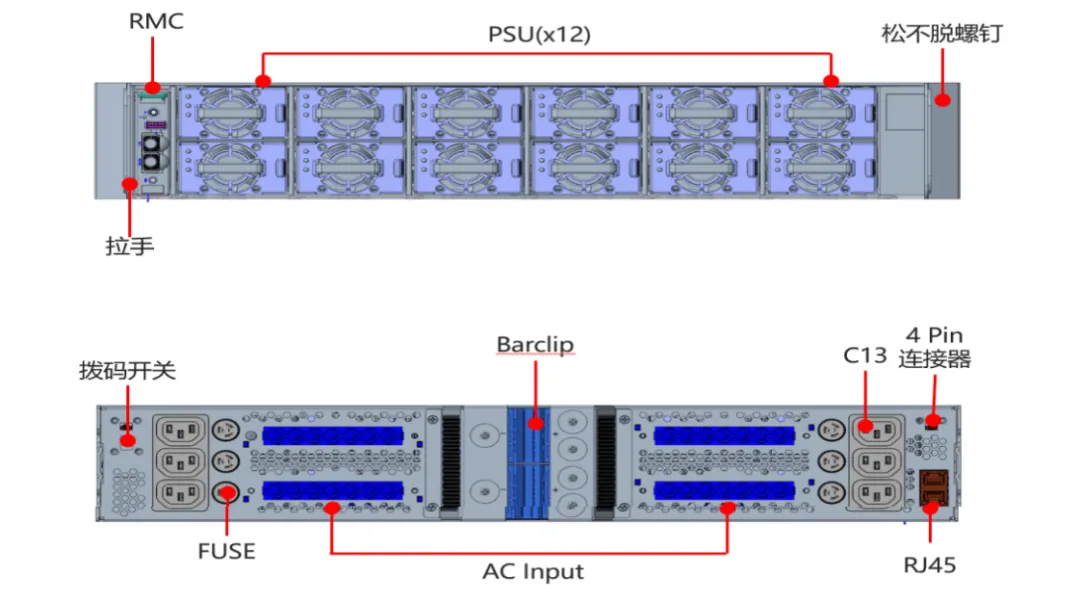
64卡版本使用两台Power Shelf。按照文档给出的22个可用模块计算,总功率为72.6kW,整柜散热设计功耗为66kW。
如果选择N+2,每台Power Shelf需要预留两个模块,可用功率会降到33kW;两台合计66kW。多留一个备份模块,相当于用3.3kW可用容量换取更强的故障容忍能力。
这笔账对用户很重要。宣传材料常把N+1、N+2和最大功率放在同一张参数表里,容易让人以为它们能够同时达到。实际项目必须明确采用哪一种冗余模式,并写清楚对应的持续功率、峰值时间和高温降额条件。
规范中还有一个需要百度进一步解释的数字。Busbar章节写到单柜最大支持150kW,但母排电流规格为1400A。按照54V计算,一条1400A电流路径对应的理论功率约为75.6kW,与64卡方案72.6kW的可用功率基本吻合。
150kW若要成立,需要双路母排、两条独立电流路径或其他扩展设计。当前文档没有交代这些条件。现阶段可以确认的是72.6kW配置,150kW更适合视为待补充边界条件的平台指标。
04|两台Power Shelf一起供电,还要避免一边累死
64卡方案把两台Power Shelf分别放在机柜顶部和底部,两路54V输出通过Busbar并联。功率简单相加并不困难,难点是让两台设备合理分担电流。
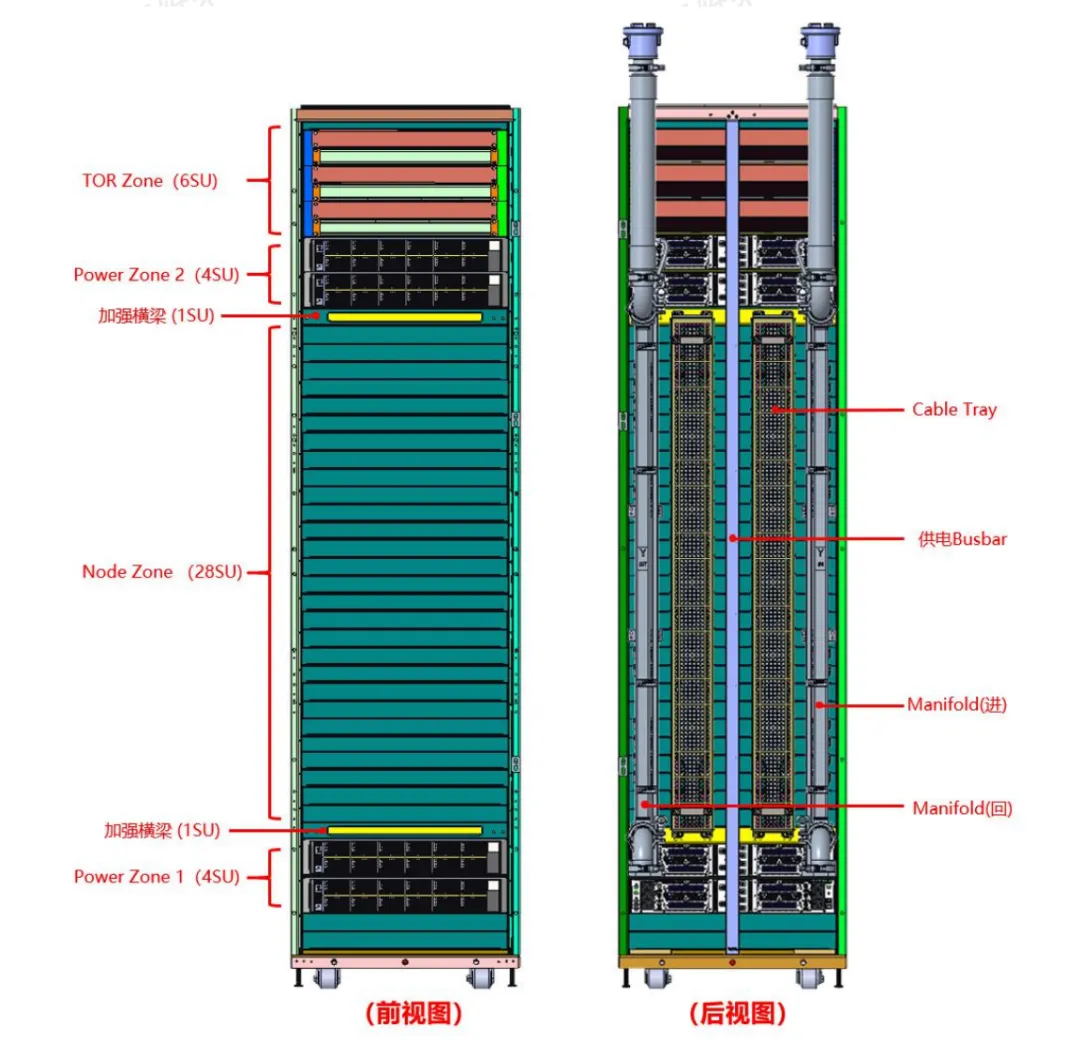
这有点像两个人一起抬重物。两个人的力量总和足够,如果重心偏向一侧,其中一个人仍可能先撑不住。电源并联也是如此:均流出现偏差时,一台Power Shelf可能提前过载,另一台还有不少余量。
百度在每台Power Shelf中配置独立RMC,通过拨码开关确定主从关系,再用RJ45接口连接两台RMC,完成电流均衡、状态交换和统一调度。
实际验收不能只看正常工况下的均流曲线。主从通信中断、单台RMC重启、一个电源框退出、某个PSU突然失效,这些场景都要逐项测试。双Power Shelf能否构成有效冗余,取决于故障发生后负载是否能够平稳转移。
05|一个50微欧的接点,可以变成72W热源
在66kW负载下,54V母线电流约为1222A。千安级电流经过Busbar Clip时,接触电阻的一点变化都会被迅速放大。
假设某个接点因为松动、氧化或装配偏差,接触电阻增加50微欧。在1200A电流下,这个接点产生的热量约为72W。可以想象成把一只老式70W灯泡产生的热量,集中塞进一个很小的连接界面。
局部温升会加快镀层和接触面的老化,接触电阻继续增加,发热也会随之上升。等到整台Power Shelf报告过温,连接位置可能已经出现明显损伤。
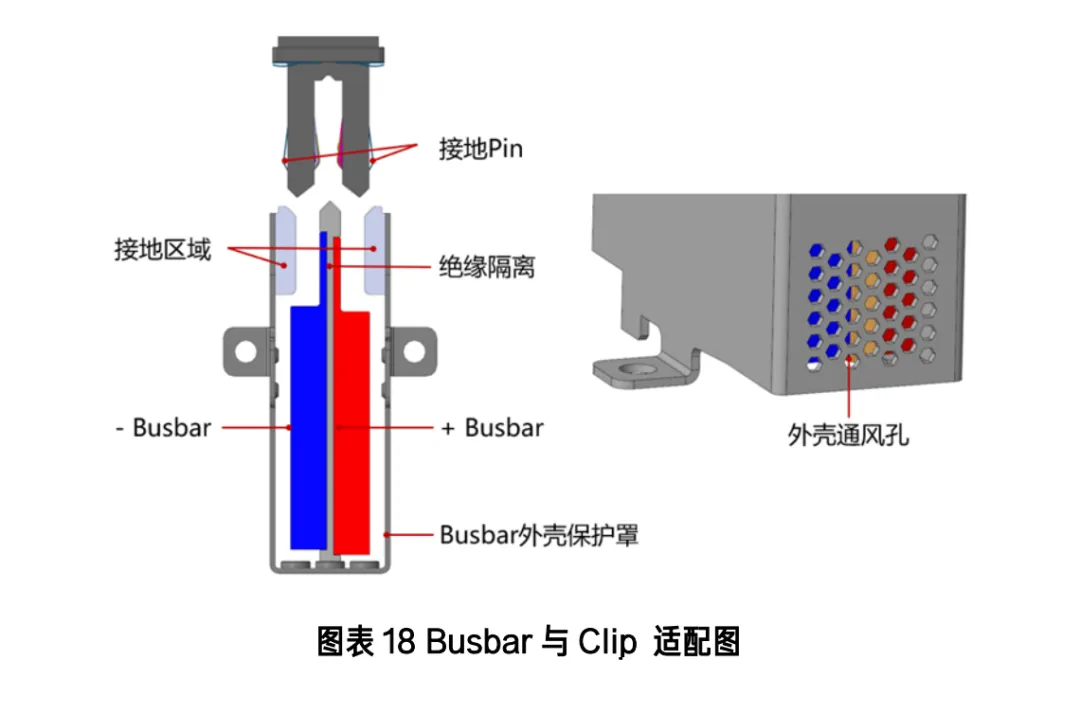
天池Busbar采用T2紫铜,镍打底、表面镀银,用于降低导体与接触界面的电阻。百度还把Busbar Clip温度单独接入RMC。系统可以把接点温度与母排电流、整柜功率放在一起判断,从异常温升中提前识别接触电阻变化。
计算节点采用盲插供电,推进机柜后由Bar Clip直接接触背部Busbar。现场少接一根线,工厂端就要多控制几项参数,包括结构公差、插接压力、表面磨损和插拔寿命。母排连接器能否长期稳定,比纸面上的1400A额定值更难验证。
06|RMC相当于整柜电源的值班工程师
天池RMC安装在Power Shelf内部,支持热插拔。它持续采集输入输出功率、电压、电流、环境温度和Busbar Clip温度,同时监控每一个PSU是否在位。
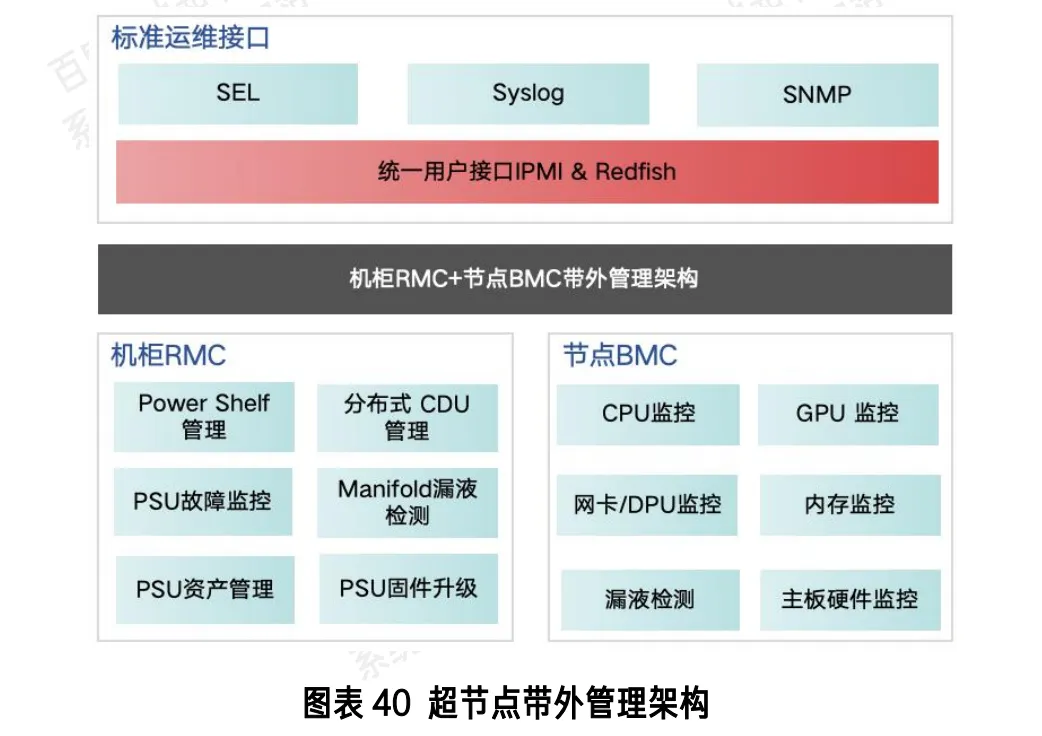
单个电源模块发生异常后,RMC可以把故障定位到具体槽位,并保存故障前后的黑盒日志。运维人员据此判断问题来自机房输入、PSU本身还是母排接点,无需把整柜所有电源逐一排查。
规范还要求PSU支持在线升级和降级回滚。依靠N+1或N+2冗余,电源模块可以逐台轮换升级,计算任务继续运行。
当整柜功率、电流或温度接近设计边界时,RMC采集的数据还可以用于Power Capping。系统提前限制部分功耗,避免过流或过温保护突然切断整柜电源。对用户来说,适度降低一段时间的性能,通常比训练任务整体中断更容易接受。
类似的模块化运维已经出现在其他整柜产品中。Dell在2026年发布的IR7044维护资料,把Power Shelf、Power Management Controller和Power Busbar分别设计成可更换部件,并提供独立维护流程。
这说明整柜电源行业正在形成相近的运维思路:故障要定位到模块,部件要能够单独更换,维护过程尽量减少对其他计算节点的影响。
07|百度百舸的部署说明了什么
按照规范披露的信息,天池超节点已经在百度百舸AI计算平台完成大规模部署验证。对于这套供电架构,至少可以得出两个判断。
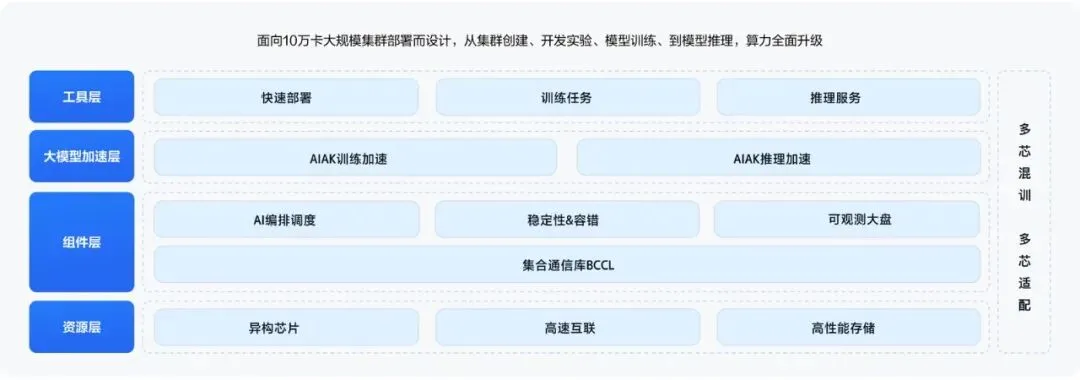
第一,交流与240V直流兼容、双路ATS、双Power Shelf均流以及RMC管理已经进入实际平台环境,设计目标显然覆盖批量部署和长期运维。
第二,公开文档暂时没有给出故障率、均流偏差、ATS切换波形、Power Capping效果和平均修复时间。这些数据决定供电架构在真实运行中的表现,也是后续评估天池成熟度时更值得跟踪的指标。
因此,供应商阅读这份规范时,可以把注意力放在几个具体问题上:电源模块退出后整柜能否保持运行;双Power Shelf在各种故障工况下怎样分配电流;Busbar Clip异常升温能提前多久发现;PSU升级是否真的对业务无感。
把部件连接成一套能长期运行、方便维修、适应存量机房的系统,是百度这份规范对产业链提出的完整要求。