ARTICLE · 1055898
AI编程助手正在读取你的“黑历史”,这事得说清楚
本文由 写作鹅 创作
我的判断是,我们正在用效率交换一个巨大的隐私陷阱。当所有开发者都在为AI写代码的速度欢呼时,很少有人停下来问一句:它到底“看”了我的哪些东西?
最近智谱的ZCode在开发者圈里炸了锅。简单说,它的一项“端到端长程任务”功能,会把你项目里整个.git历史记录,像打包行李一样,一股脑上传到云端。这意味什么?不只是你现在的代码,而是你每一次提交的修改、每一次写错的尝试、甚至那些被你删掉的敏感信息(比如误提交的API密钥、数据库密码),都可能被完整地读走。官方在社群里确认了这个行为。
这根本不是小事。这不是“读取当前文件”,这是在翻阅你的“开发日记”和“草稿纸”。细思极恐。
一、.git历史:你以为的“日志”,AI眼里的“裸奔”
我先打个比方,帮你彻底搞懂这事。
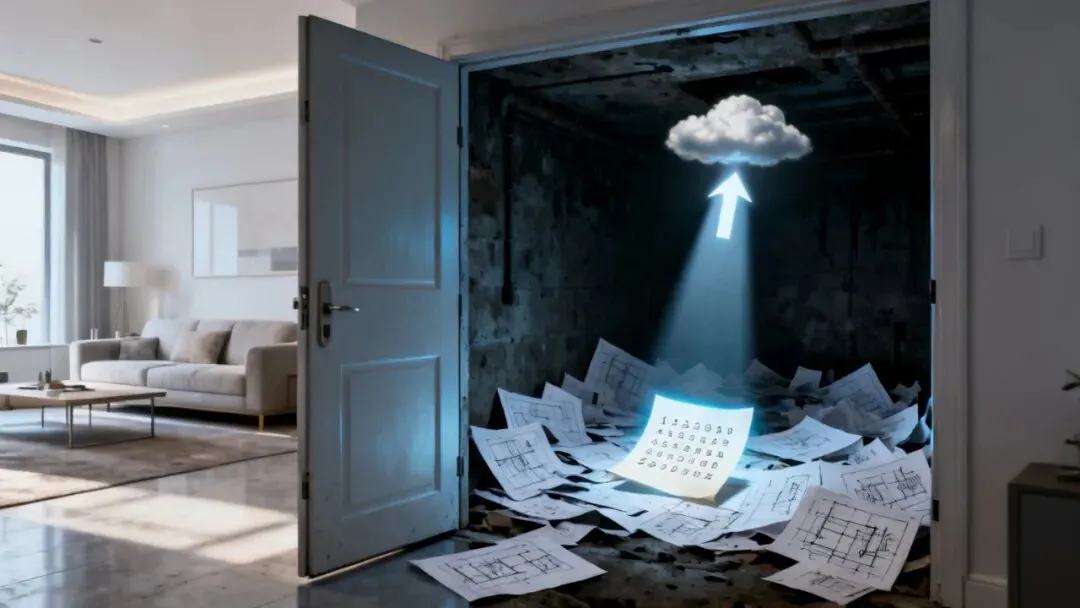
你的代码项目就像一个家。当前写好的代码,是你家客厅,整洁体面,可以待客。而.git文件夹是什么?是你家从不对外开放的地下室和储藏间。里面堆满了东西:你装修时废弃的设计图(旧版本代码)、你写了一半觉得不好就扔掉的草稿(废弃分支)、甚至可能还有你记着银行卡密码的纸条(误提交的敏感信息)。
正常情况下,AI助手来帮你打扫客厅(优化代码),这很合理。但现在,ZCode的这个功能,是连地下室的门锁都撬了,把里面所有杂物——包括那张写着密码的纸条——全部拍照打包,传到一个你不知道在哪的云相册里。
你觉得这仅仅是“读取项目文件”吗?这是在窥探你的创作全过程,你的试错,你的“黑历史”。任何一个有经验的开发者都知道,git历史里埋了多少“雷”。这根本不是增强功能,这是过度索权,是赤裸裸的数据越界。
二、产品逻辑的“偷懒”与商业逻辑的“贪婪”
为什么会发生这种事?我的分析是,这是产品思维偷懒和商业数据贪婪共同作用的结果。
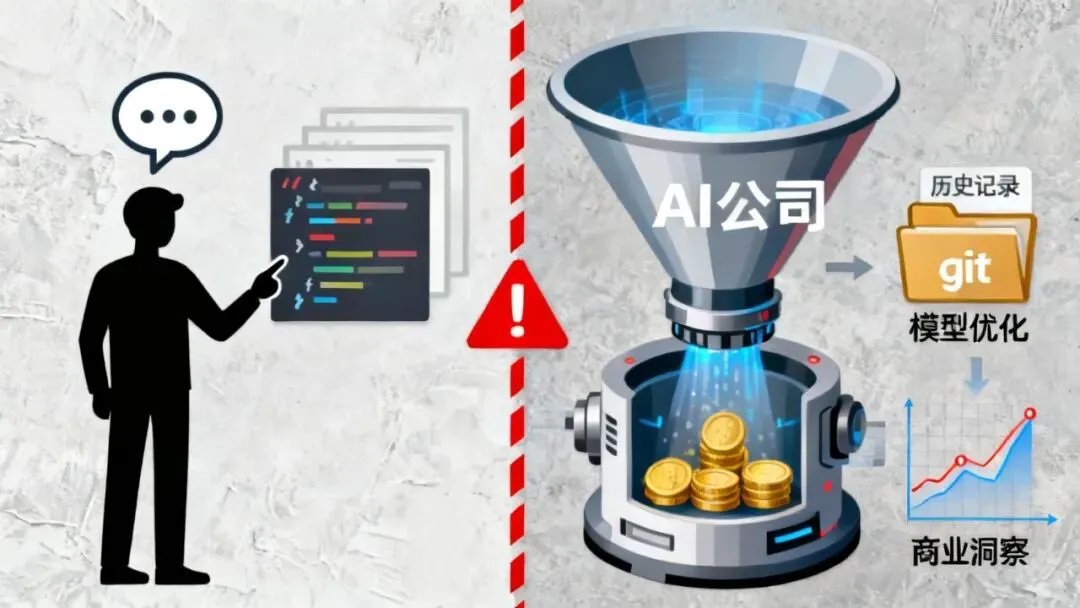
从产品角度讲,把整个git历史喂给大模型,可能是最简单的方案。开发者提的需求是“基于我的项目上下文深度分析”,产品经理或工程师一想:怎么给上下文最全?直接把.git打包上传最简单,里面啥都有,版本演变、上下文关联一应俱全。这是一种典型的“技术暴力”思维——不考虑隐私边界,只追求功能实现的便捷和模型效果的“理论上限”。
他们可能觉得:“我们是好心啊,给AI更多信息,它才能更好地帮你。”但这就是最大的问题:没有让用户知情和选择。用户可能只需要AI分析当前几个文件,你却默认把整个家底扫描上传。这是对用户控制权的剥夺。
从商业角度看,这就更值得警惕了。完整的git历史数据,对AI公司来说是“黄金饲料”。普通的代码片段是“零食”,而成体系的、带完整演进逻辑的私有项目历史,是“满汉全席”。用这些数据可以:
1. 极致优化代码模型:让你的私有项目成为他们模型的训练养料。
2. 分析开发行为:研究开发习惯、团队协作模式,这都是极具商业价值的洞察。
3. 构建竞争壁垒:谁掌握的私有高质量代码数据多,谁的代码助手可能就更“懂行”。
这里存在一个根本性的利益冲突:用户想要的是“一个不窥探隐私的聪明工具”,而AI公司潜意识里想要的是“更多、更私密的数据来喂养和证明它的聪明”。当两者冲突时,在产品设计上,数据贪婪往往就占了上风。
三、守护本地代码:开发者必须建立的“新安全观”
面对这个局面,开发者不能天真地指望AI公司的“自律”。我们必须建立新的安全开发意识。指望一家商业公司完全放弃数据诱惑,是不现实的。关键要靠我们自己设防。
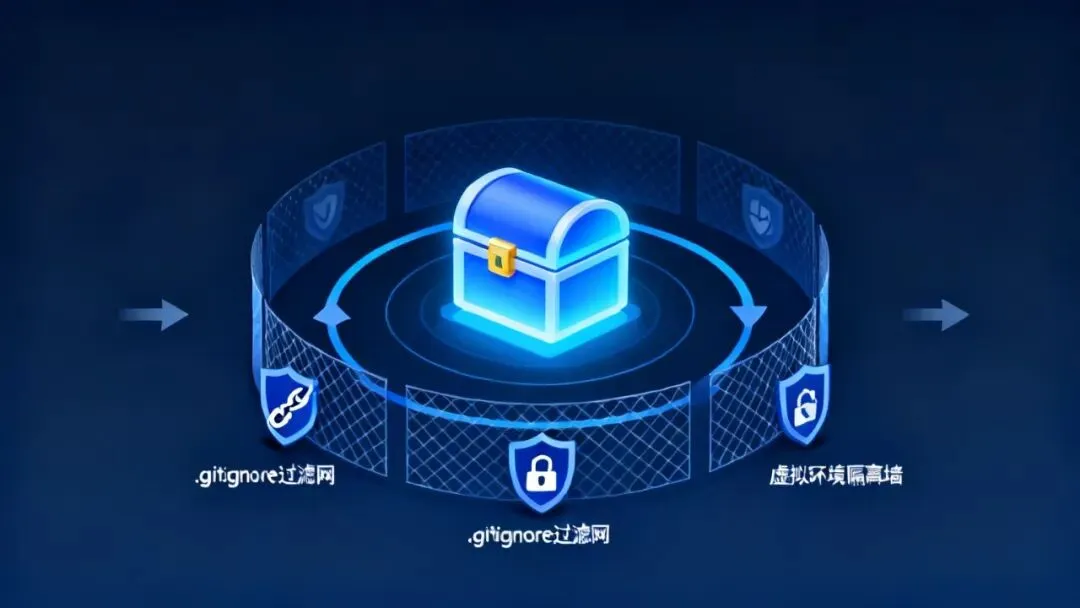
我认为,开发者应该立刻做三件事:
第一,建立“最小授权”原则。给AI工具的权限,要像给访客的权限一样。能用“只读当前文件”解决的,绝不给“项目访问权”。需要分析项目结构时,先问问自己,真的需要把历史提交记录都开放吗?把AI工具想象成一个你不太信任但能力很强的外包程序员,你会把公司代码库的所有访问日志都给他吗?
第二,审查你的.gitignore和git历史。立刻检查你项目里的.gitignore文件,确保它屏蔽了所有配置文件(如.env)、密钥文件、日志、编译产物等。更重要的是,定期审查你的git历史(用`git log`和相关工具),看看有没有早期误提交的敏感信息。有的话,用`git filter-branch`或BFG等工具彻底清理。别把你的“历史罪证”留在那里。
第三,对AI编码工具进行“安全隔离”。对于极其敏感或核心的项目,我的建议是:干脆在物理或虚拟环境上隔离。使用虚拟机、独立的开发容器(Docker),或者专门准备一台不联网、或只运行完全本地化AI编码工具(比如一些本地部署的代码补全模型)的机器来处理。不要让你的核心资产暴露在任何一个你无法控制数据流向的云端AI服务下。
四、给AI公司的几句直言
最后,我想对做AI编程工具的厂商说几句。
是“透明”和“可控”。清晰、醒目地告诉用户,每一项功能会访问哪些数据,上传哪些内容。提供“隐私模式”或“数据沙箱”,让用户可以选择只将分析限制在特定文件或目录,甚至提供纯本地计算的重型功能(哪怕收费)。把选择权,明明白白地交还给用户。
短期看,上传全部历史可能让模型表现好一点点,但长期看,失去的是所有资深开发者和企业的信任。而这些人,正是你们最核心的用户和付费者。
我的结论很明确:AI编程辅助是不可逆转的趋势,效率提升也是真实的。但我们绝不能在半睡半醒间,用代码隐私和知识产权去交换这份效率。ZCode事件是一记响亮的警钟,它敲给每一个开发者:请看好你的“数字家门”。它也敲给每一个AI厂商:真正的智能,始于对用户的尊重。 这条路如果走歪了,今天你多拿的数据,明天就会变成用户用脚投票离开你的原因。
开发者们,是时候更聪明、更警惕地使用这些强大的工具了。你的代码,不仅是你的作品,也是你的领土。