ARTICLE · 1063258
腾讯开源爆款 WeKnora:把散落文档变成会自进化的企业级知识库
前面我们连拆了 jev 系的三个开源项目,看的都是「AI 怎么替人把活儿干漂亮」。这周 GitHub 趋势榜上最猛的一匹黑马,是腾讯刚开源的 WeKnora——一个号称能把公司里散落的文档,变成「能问答、会推理、还能自己长知识」的框架。我照老规矩,先把它真实仓库 clone 下来读代码,不靠 README 下结论。结论是:它比大多数「知识库」开源项目重得多,也完整得多。
项目地址:https://github.com/Tencent/WeKnora 官网:https://weknora.weixin.qq.com
一、它到底是个什么
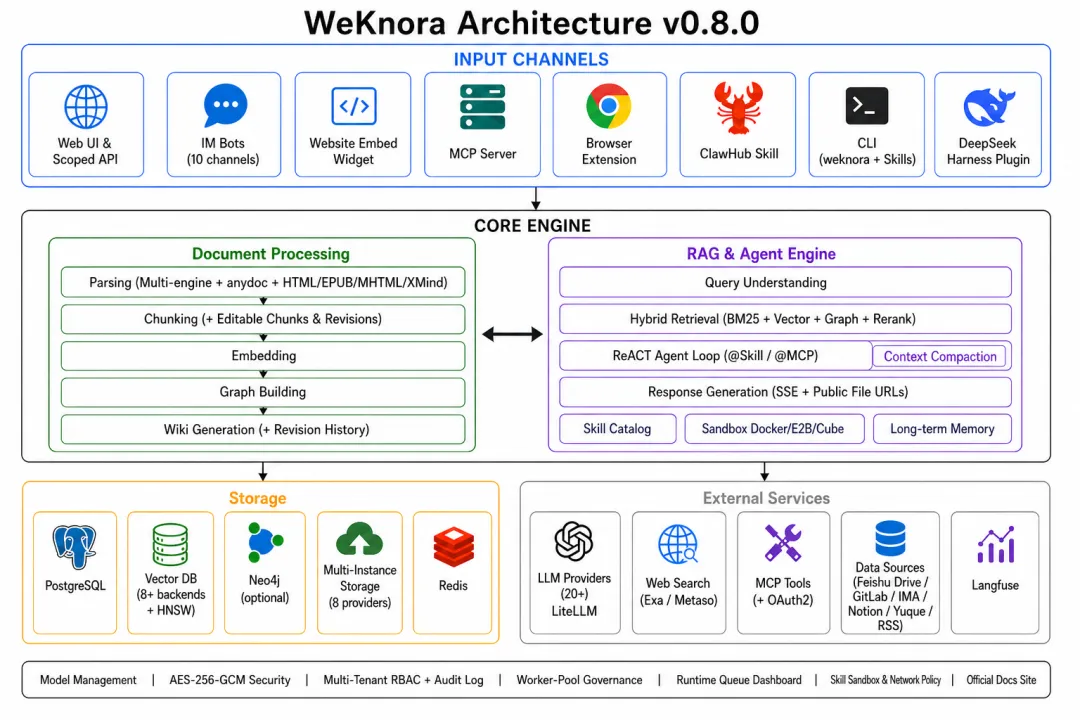
一句话:WeKnora 是一个把文档变成「可问答 + 能自主推理 + 会自我整理」的知识中枢。它不像很多开源 RAG 项目那样只做「上传文件、向量检索、吐答案」三件事,而是把三套能力叠在了一起。
↔️ 提示:以上表格数据支持左右滑动查看完整维度
backend 是 Go(已用到 Go 1.26),前端是 Vue,整体可完全私有化部署。对我这种「先把代码读明白再说话」的人来说,它的卖点不是概念新,而是工程完成度高。
二、先核数字:自述 vs 实测
读 README 容易热血,所以我直接拉了仓库数了一遍。下面每一项都是我这台机器上跑出来的,不是抄官网。
↔️ 提示:以上表格数据支持左右滑动查看完整维度
几个判断:Star 数近 2.9 万、今天(2026-09-22)还有提交,说明它不是刷一波就凉的演示项目;1,199 个测试文件在 Go 项目里属于相当扎实的投入;MCP 工具「源码 33、发布 29」的小出入,更像是发布包做了裁剪,不影响「工具面很全」这个判断。
三、最特别的那块:Wiki 自动知识图谱
RAG 和 Agent 现在到处都是,真正让 WeKnora 和同类拉开距离的,是Wiki 模式。它干的事是:把一堆 raw 文档丢进去,Agent 自动生成结构化的、互相链接的 Markdown 词条,并在界面里画出知识图谱;每个词条有修订历史、行级 diff、一键回滚,还能手动编辑。
我在源码里找到了印证,而不是停在宣传语:
• application/service/wiki_ingest.go 里定义了 WikiTaxonomyPlanPrompt(给所有实体分配目录树)和 WikiSummaryPrompt(把文档蒸馏成结构化词条);
• 仓库里有专门的 KnowledgeGraph.md 文档讲知识图谱的实现;
• docs 里附了 wiki-graph 的真实截图,节点和关系确实是自动抽取的。
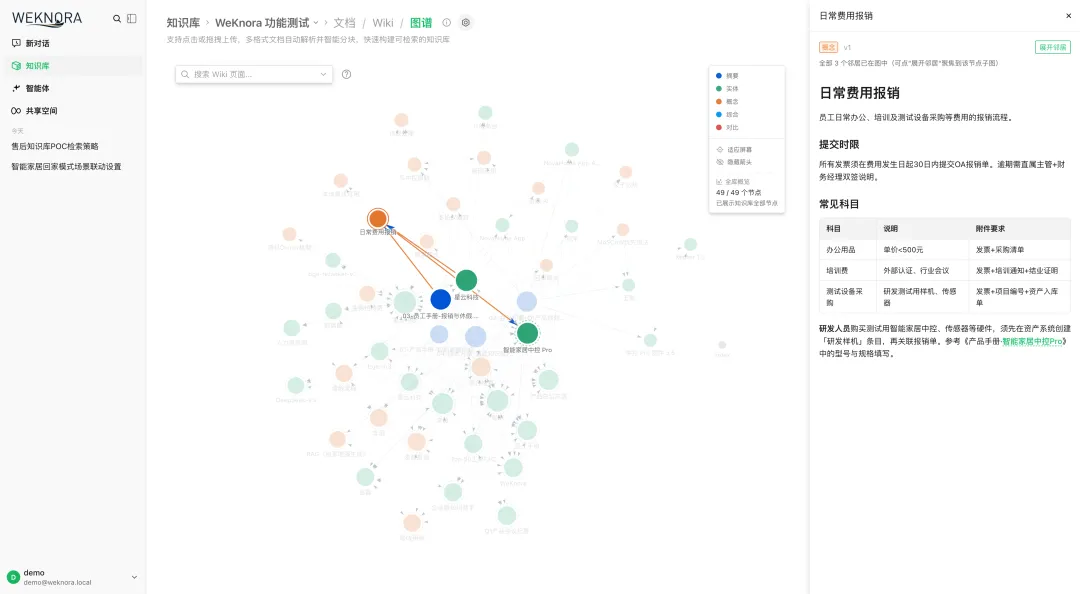
这意味着它想解决的不是「检索」,而是知识沉淀与维护——文档一多,人会懒得整理,Wiki 模式等于雇了个不知疲倦的编辑。这是它最值得看的设计。
四、关键机制拆解
1. ReAct 引擎是真的,不是 PPT。 我在 internal/agent/engine.go 第 29 行看到注释:AgentEngine is the core engine for running ReAct agents;第 586 行有 executeLoop executes the main ReAct loop。更关键的是它还写了 loopGuards——专门防止模型在工具调用里空转死循环。一个开源项目把「循环守护」都写进代码,说明它真跑过长时间自主任务,踩过坑。
2. 管道全模块化。 文档解析、向量化、检索、LLM 推理每一层都能替换:向量库支持 pgvector、Elasticsearch、Milvus、Weaviate、Qdrant、腾讯 VectorDB 等;大模型接了 OpenAI、DeepSeek、Qwen、智谱、混元、Gemini、Ollama 等 20 多家;对象存储从本地到 MinIO、S3、各种云 OSS 都能挂。想换国产模型和国产向量库,基本不用改业务代码。
3. 多源接入很务实。 能直接从飞书知识库、飞书云盘、GitLab、腾讯 IMA、Notion、语雀、钉钉文档、RSS 自动同步,增量和全量都支持。对企业来说,这比「上传 PDF」有用得多——知识库能跟着源头自己更新。
4. MCP 与可观测。 官方 MCP 服务(PyPI 包 tencent-weknora-mcp)把知识库能力暴露给任意支持 MCP 的客户端;同时接了 Langfuse 做推理链路追踪、Token 统计和管道耗时。对想把它嵌进自己工作流的团队,这点很关键。
五、公道话与边界
先说做对的地方:完整度、测试密度、私有化能力这三项,它明显比多数个人作者的 RAG 玩具项目强;ReAct 循环守护、Wiki 自动整理、RBAC 四层权限 + 审计日志,都说明它瞄准的是企业落地,不是 demo。
再说是老实话——它的边界也要看清楚:
• 偏重。 一套 Docker Compose 拉起来连带向量库、对象存储、可选 Neo4j 图谱、可选 Langfuse,资源占用不小,个人轻量玩具场景有点杀鸡用牛刀。
• 要自备大模型密钥。 它自己不产模型,DeepSeek / OpenAI / 混元 的 API Key 得你自己有,纯本地跑要配 Ollama。
• 门槛不低。 配置项极多(.env.example 就有 44KB),新手第一次部署大概率要在文档里翻一阵。
• 定位是企业知识中枢,不是轻量 RAG 库。 如果你只想给自己的笔记加个问答,它有更适合的小工具;WeKnora 适合「一整个团队、一堆系统、要长期维护」的场景。
回到开头:这周 GitHub 最火的那匹马,我读完后觉得名实基本相称——它没有用一个惊天概念糊弄人,而是把「文档→知识→推理→自生长」这条链路,用相当工业化的方式拼完整了。值不值得跟,取决于你是想搭企业知识库,还是只想给个人笔记加个问答。
免责声明
本文为开源项目的技术介绍与代码核验记录,不构成任何投资建议。项目功能、许可(MIT)与安全边界以官方仓库为准,部署前请结合自身环境与合规要求自行评估。