ARTICLE · 1065993
LangChain系列文章Demo源码
《代码的江湖》
这些文章配的代码,我整理成了一个仓库放在 GitHub 上,方便大家一起学习交流。
地址是 github.com/chengjungao/Langchain-Demo。
8 个章节,每章一个能单独跑起来的工程,都不需要 API key。
一、仓库里有什么
每个章节下面是一个能单独拎出来跑的工程。仓库首页的 8 个目录:
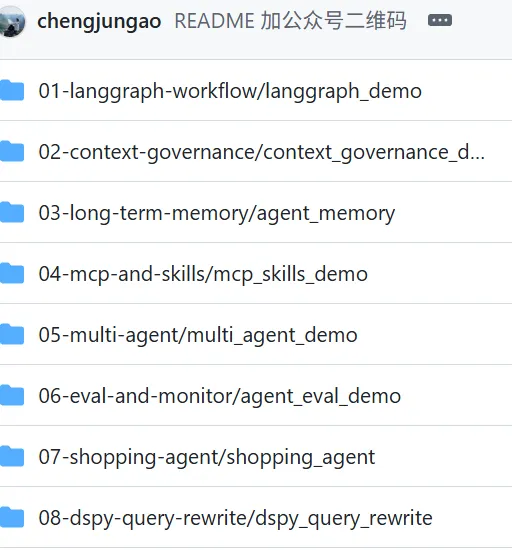
前面 4 个偏机制:三关闭环演示人工闸口挂起和时间旅行回溯,上下文治理把四种策略的账单摆在一起,长期记忆拆成抽取、存储、检索、治理四层,MCP 与 Skills 对比两种接入姿势。
后面 4 个偏实战:多 Agent 覆盖隔离、交接、并行、死循环与成本,评测监控把 trace、评测集、门禁、指标和脱敏都做了一遍,购物助手是带浏览器界面的完整工程,DSPy 用优化器编译提示词、落盘产物再蒸馏。
目录是两层:章节目录下面保留着工程自己的文件夹,和文章里下载到的压缩包解压后一样。运行命令里的 cd 一律进到里面那一层。
二、零成本是怎么做到的
每个工程都自带一个假模型,它按剧本回消息,替真模型上班。
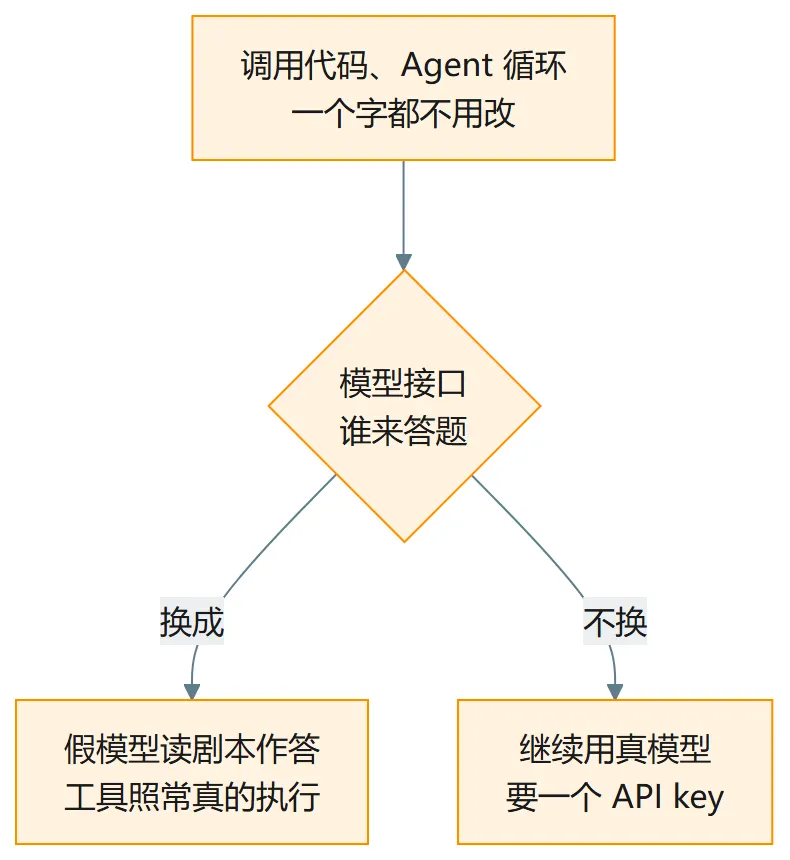
手法是继承 BaseChatModel,覆写 2 个方法。bind_tools 记下这一轮绑了哪些工具,_generate 返回写好的消息。
ORDER = {"order_no": "SO2026"}CALL = [{"name": "query_order","args": ORDER, "id": "c1"}]def call_msg(calls):return AIMessage(content="",tool_calls=calls)def result(msg):return ChatResult(generations=[ChatGeneration(message=msg)])@tooldef query_order(order_no: str) -> str:"""按订单号查订单状态。"""return f"{order_no} 已发货"class Fake(BaseChatModel):@propertydef _llm_type(self):return "fake"def bind_tools(self, tools, **kw):got = [x.name for x in tools]seen["t"] = gotreturn selfdef _generate(self, msgs, **kw):seen["n"] += 1seen["c"].append(len(msgs))if seen["n"] == 1:msg = call_msg(CALL)else:msg = AIMessage("查到了")return result(msg)
配一个真工具,用 create_agent 起一个最小 Agent,跑起来是这样:
模型看到: ['query_order']被调用: 2 轮每轮上下文条数: [1, 3]工具返回: ['SO2026 已发货']最终回复: 查到了
模型被调用 2 轮:第 1 轮发起工具调用,第 2 轮拿到工具结果后作答。工具是真的执行了,上下文从 1 条涨到 3 条。整个过程没有一次网络请求。
换成真模型时,把 Fake() 换成 ChatOpenAI(...),调用方代码一行都不用动。各章 README 都写了改哪儿。
三、跑起来能看到什么
几组跑出来的真实输出。
状态能跨进程活下来(第 01 章)
sqlite_demo.py 把每一步写进 sqlite。先跑 run,图会挂起在人工闸口,这时可以关掉进程。再跑 resume,它按同一个 thread_id 从断点接着放行,不用从头再来。
上下文治理的账(第 02 章)
同一个演示还顺手验出一件事:官方 trim_messages 的预算如果贴着下限设,会把用户问题整段裁掉,只剩系统提示。
记忆在换会话之后还在吗(第 03 章)
demo.py 演 8 幕。第 2 幕是换个会话,上下文清零,但上一轮记下的偏好由记忆系统补了回来;第 3 幕是用户换了技术栈,旧值失效但没被删掉。核心层只用标准库,sqlite3 加一个哈希向量,装不装第三方包都能跑。
工具装不下的量级(第 04 章)
7000 个业务风格的工具,合计 1,537,101 token,是 200K 窗口的 768.6%。模型一个都装不进上下文。
这个工程里有个网关,把工具检索一遍再交出去。实测模型侧账单从 1,537,731 token 降到 1,529 token,注册的 7003 个工具里,这一轮只给它 9 个。
多 Agent 到底是贵还是省(第 05 章)
分水岭是一次请求要动几个专家。动 1 个省一半,动 3 个贵一半,模型调用次数从 2 次涨到 10 次。
没配模型的购物助手(第 07 章)
python run.py 起来一个网页,右边能对话,左边实时显示它这一轮干了什么。没配模型也能跑完整一轮,整个过程吐了 10 个事件,主线是这几步:
memory 没有可用的长期记忆govern 本次请求约 11 tokenroute 路由 → 导购线,命中 advisorthink 第 1 轮,想调 search_productstool search_products 返回 5 款think 第 2 轮,信息够了archive 写入长期记忆:预算=1000final 按现有数据查到这些……
路由、检索、工具、记忆归档全是真的,只是「思考」那一步用的是规则而不是模型。
提示词跑进了产物目录(第 08 章)
第 08 章一条龙跑完编译、蒸馏、回跑 3 步,默认用 DummyLM,同样不花钱。产物和蒸馏出来的 SFT 数据落到 artifacts 目录,改一行 config.yaml 换成真实模型就能接着用。
四、整理时踩到的 3 个坑
第一个:数据库会跟着提交上去。
第 01 章那个持久化演示会生成一个 checkpoints.db。原来的忽略清单漏了这一条,读者跑完执行 git add -A 就会把数据库提交进仓库。已经补上了。
第二个:一键验收要跑 132 秒。
第 06 章的 python run_all.py 会跑 8 个演示、2 个命令行工具和 33 项冒烟测试。全部通过,耗时 132 秒,中途没有任何输出,容易被当成卡死。
它跑完会打印一行汇总,等着就行。
**第三个:Send 的位置有硬要求。**
第 05 章演示了 Send 的使用位置。它只能从条件边返回,写在普通节点体里会直接报错:
InvalidUpdateError: Expected dict,got [Send(node='worker', ...)]
分清楚这两个原语的活:Command(goto=...) 改的是控制流去哪,Send(node, payload) 改的是这一份活派给谁、带什么数据。位置要求跟着这个分工来。
五、怎么用
要求 Python 3.10 以上,我在 3.13 上实跑通过。一个工程一个环境,别装进同一个虚拟环境。
cd 03-long-term-memory/agent_memorypython -m venv .venv.venv\Scripts\activatepip install -r requirements.txtpython demo.py
第 03 章这条路径只用标准库,pip install 那步甚至可以跳过。
想先看能不能跑,每个工程都有一条自检命令。第 07 章是 python run.py --check,它会报数据加载了多少条、31 项自洽校验过没过、以及当前是不是内置规则模式。
仓库是 MIT 许可。工程之间没有导入关系,可以直接把某一个目录单独拷出来用。
跑的过程中卡在哪一步,欢迎留言说具体报错。这个仓库的每一个工程,都是从头跑过一遍才放进去的。
— 代码的江湖 —