ARTICLE · 1067117
AI 不缺知识,缺的是你的上下文
Codex + Obsidian:把个人经验、判断和来源,变成可协作调用的知识资产
为什么资料越来越多,AI 仍然不一定更懂你的工作?
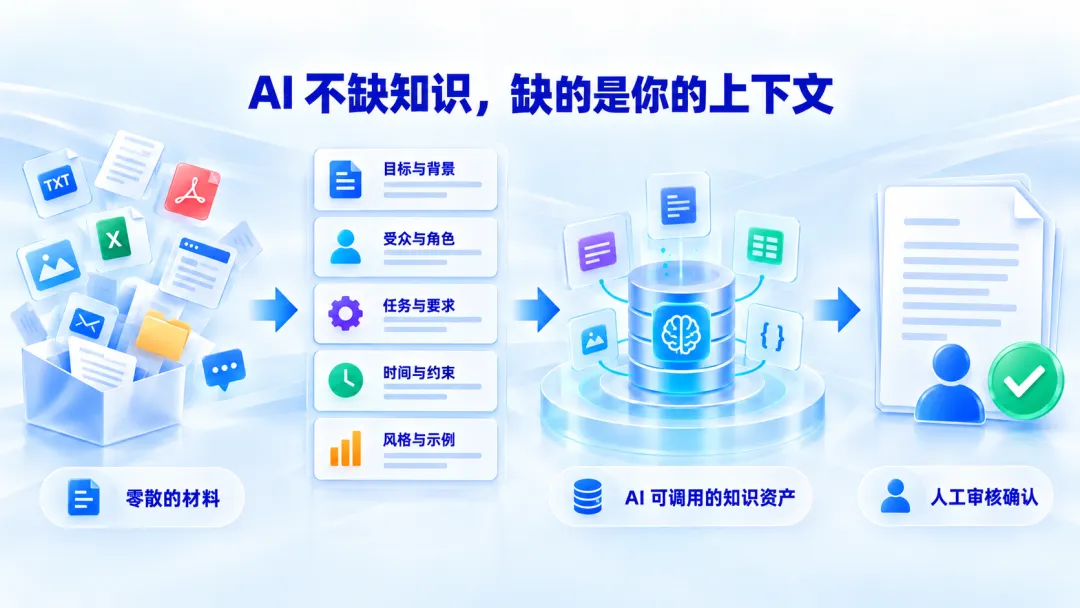
先说结论:AI 缺的往往不是更多知识,而是与当前任务有关、可审阅、可追溯的工作上下文。
你有没有遇到过这样的时刻?
你让 AI 写一篇文章。它很快给出了一个结构完整、语言流畅的版本。可是读完之后,你发现它并不知道文章真正要写给谁,也不知道你过去已经讲过哪些观点,更不知道哪些内容只是推测,哪些内容是你已经确认过的判断。
于是你开始继续补充:账号定位、读者对象、历史文章、案例边界、表达风格、不能使用的材料……
这时你可能会想:是不是模型还不够强?
很多时候,问题并不在于 AI 知道得不够多,而在于它不知道——这一次工作必须服从什么语境。
01AI 不是不会回答,而是不知道你正在做什么
通用模型知道什么是公众号文章,知道什么是课程开发,也知道什么是知识管理。
但它不知道你正在写的这篇文章,是给第一次接触 AI 的管理者,还是给已经熟悉自动化工具的技术人员;不知道你的课程只有 90 分钟,还是要做成一套长期训练营;不知道你更看重观点的可验证性,还是更看重现场启发;也不知道哪些材料可以公开,哪些只能留在内部。
模型掌握的是公共知识。
而真实工作依赖的是工作语境。
工作语境通常包括五个部分:
这次究竟要完成什么; 最终给谁使用或阅读; 哪些资料可以作为依据; 哪些判断已经被确认; 哪些事情不能做,哪些内容不能使用。
如果这些信息只存在于你的脑中,或者散落在过去的聊天记录、文件夹和临时笔记里,那么每一次开始新任务,都像是在重新给 AI 做一次入职培训。
你以为自己在让 AI 工作,实际上你一直在给它补前情。
02给 AI 更多文件,不等于给了它更多上下文
当我们发现 AI 的回答不够贴近时,第一反应通常是把更多文件交给它。
但文件数量增加,并不自动带来理解增加。
02.1一个文件只能说明“这里有内容”
它未必说明这份内容从哪里来,是否可信,是否仍然有效,适用于什么场景,能不能对外使用,以及它和其他资料是什么关系。
一份旧课件,可能是一个文件;但它背后的课程目标、适用人群、常见误解、试讲反馈和修改依据,才是下一次课程开发真正需要的知识。
02.2摘要不等于你的判断
AI 可以把十篇文章压缩成一页摘要,但这不代表它知道:
哪些观点属于原作者; 哪些观点是你的解释; 哪些结论已经被实践验证; 哪些内容仍然只是待确认的假设。
如果这些层次没有被区分,AI 很容易把“来源材料”写成“你的结论”,把“候选信息”写成“已经确认的事实”。
02.3记住内容,也不等于承担责任
即使 AI 能够读取大量资料,它也不会自动替你判断:
这条信息今天还适不适用; 这条内容有没有权限使用; 这个案例是否需要脱敏; 这个结论是否足以支持一次公开表达。
所以,真正重要的不是让 AI 读过你的一切资料,而是让它知道:
哪些内容,在当前任务里,可以被怎样使用。
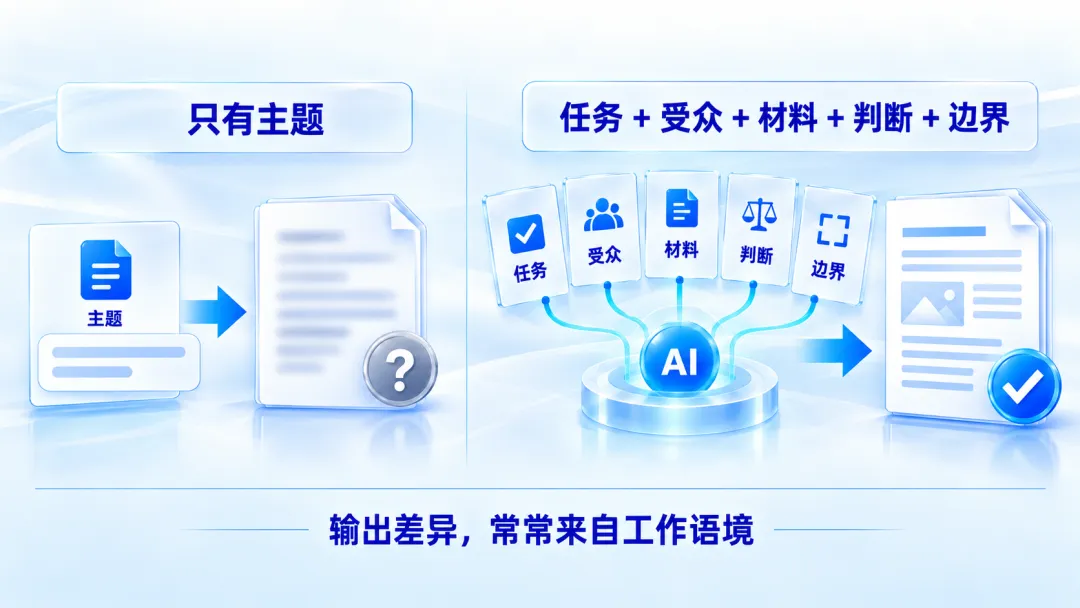
03一个任务真正需要的,是五类最小充分上下文
所谓“上下文”,不是把关于自己的所有信息都交给 AI。
更准确的说法是:为当前任务准备一组最小但足够的工作背景。
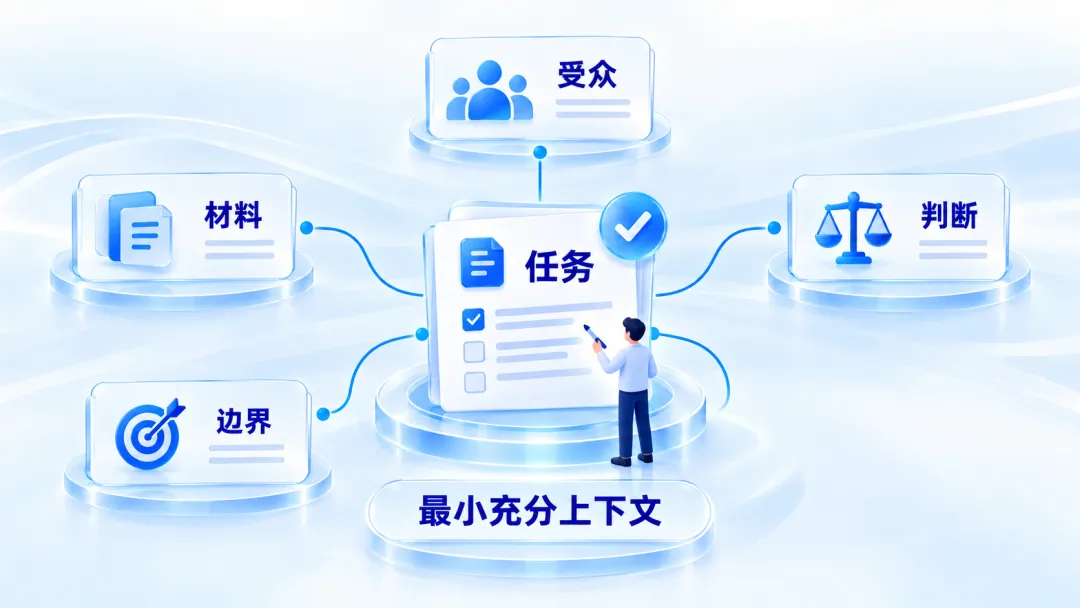
我把它称为“最小充分上下文”,可以先从五张卡片开始。
这次究竟要完成什么?是写一篇文章、整理一批资料、设计一节课,还是检查一份已有方案?还要说清楚不做什么。任务边界越清楚,Agent 越不容易把工作范围越做越大。
这份输出最终给谁使用?同样是“介绍个人知识管理”,写给普通管理者、HR 从业者、技术人员和课程学员,内容深度、案例选择和语言方式都会不同。
哪些资料可以作为依据?要区分原始来源、主题笔记、草稿和仍需核验的内容。材料卡让 Agent 知道可以参考什么,也知道不能把什么直接当成结论。
你已经确认了什么?比如文章要有个人判断,案例需要脱敏,未经核验的数据不能写成事实,数字员工不能被描述成替人承担最终责任的自治主体。
哪些事情不能做,哪些内容不能使用?例如不读取限制访问资料,不移动、重命名或删除原始文件,不把待确认内容用于公开文章。
04Codex 和 Obsidian,分别解决什么问题?
在这套工作方式里,Obsidian 和 Codex 不是两个互相替代的工具。
它们更像是知识协作中的两个不同位置。
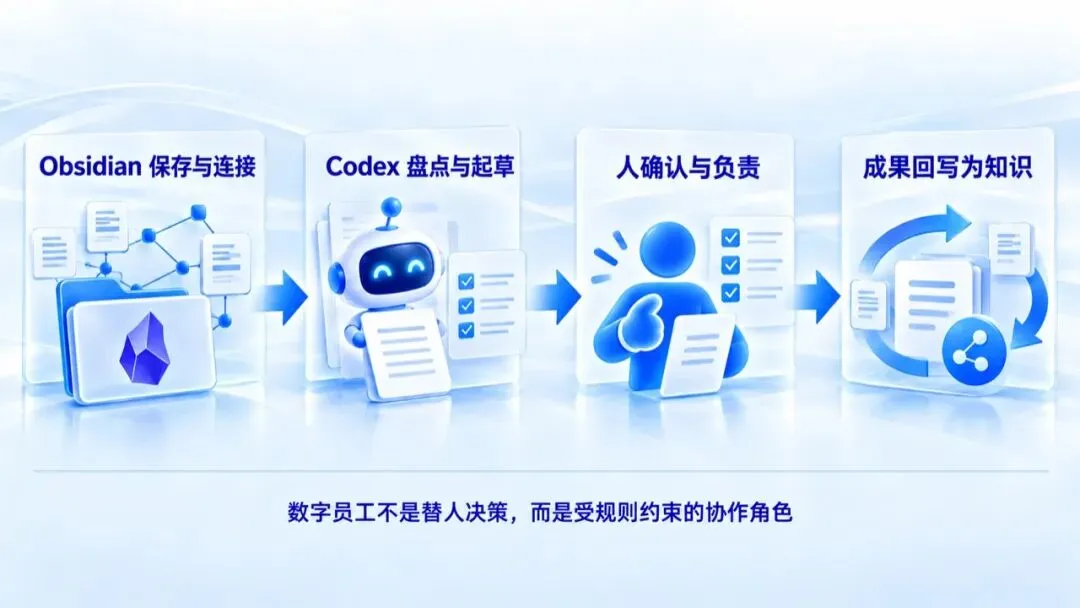
Obsidian 负责保存和连接:
来源资料; 主题笔记; 已确认的判断; 资料之间的关系; 内容的状态、权限和生命周期; 项目结束后值得保留的复盘。
Codex 负责在明确范围和规则下,帮助完成:
资料盘点; 候选关联; 内容提炼; 文章或课程初稿; 断链、重复、过时和缺失信息检查; 将任务结果回写为知识的建议。
而人仍然负责最关键的部分:设定问题和范围,判断资料是否值得使用,确认敏感性和权限,判断结论是否成立,并对最终公开内容和实际决定承担责任。
所以,这个系列里说的“数字员工”,不是一个可以脱离人独立负责的虚拟人。
它更接近一个受规则、权限、来源和人工确认约束的协作角色。
人和 Agent 可以共享材料,但不共享最终责任。
05不要先重建全部知识库,先做一个任务上下文包
如果你现在已经有很多文件,不建议第一步就重建整个知识库。
可以先选一个近期真实任务,做一个小小的“任务上下文包”:
然后让 Codex 只完成三件事:
根据这些上下文提出工作提纲; 标出它仍然缺少的信息; 不替你假设或补齐尚未确认的内容。
这就是个人知识资产开始形成的地方。
06先把不能每次重讲的内容留下来
个人知识库的第一步,不是把所有资料都搬进去。
也不是让 AI 记住关于你的一切。
第一步只是把那些不能每次重新解释、但又会持续影响工作质量的上下文,变成一份可以阅读、检查、更新和调用的材料。
当任务、受众、材料、判断和边界开始被写下来,AI 才有可能从“会回答问题的工具”,逐渐变成“能够参与具体工作的协作角色”。
收藏、保存和剪藏,为什么没有自动变成知识?
下一期,我们继续追问:文件、来源、知识和判断之间,到底差了哪一步?
你最近哪一次使用 AI 时,最明显地感到它“不懂你的工作”?如果只保留“任务、受众、材料、判断、边界”五张上下文卡,你会先写哪一张?