ARTICLE · 1069098
你的 AI 编程助手,默认在拿你的代码训练吗
我每天用 Claude Code 和 Codex 写代码,上周才第一次去翻它们的数据设置:两个账号的"用我的数据训练模型"开关,都开着。
两个开关都开着,我却不记得自己开过——默认值要的就是这个效果。
触发我去翻的是 Meta。9 月 2 日它发布 Muse Spark 1.3,API 分两档,规格完全一样,只差一件事:便宜的那档,要你同意拿提示词和回复去训练它的下一代模型。
Meta 把"同意训练"做成了一个价格
Meta 官方定价页上,标准档 muse-spark-1.3 每百万 token 输入 1.25 美元、输出 4.25 美元,条款写"prompts and completions are not used to train Meta models"。贡献者档 muse-spark-1.3-contributor 输入 0.10、输出 0.20,换来的是"permission to use your prompts and completions to train future Meta models"[1]。
算下来输入便宜 12.5 倍,输出便宜 21 倍。网上流传的"便宜 75 倍"只对缓存输入成立(0.15 对 0.002),是挑了最吓人的那档报的。另一个差别没多少人提:贡献者档每分钟只能发 100 次请求,标准档是 3000 次。它适合跑离线批处理,不适合给一个团队当日常助手。
同意机制就写在 model ID 的后缀里。你在代码里把 -contributor 拼上去的那一刻,就算签了字。
我原本想写"这是一笔可选的交易,谈不上偷",写到一半改了:一个没被看见的选项,算什么选择?Meta 至少把价格明码标出来了,编程助手这边连价格都没有,只有一个默认值。
四家的开关在哪、默认是什么
四家个人版的条款说法差不多:开关开着(Cursor 是 Privacy Mode 关着),就可以拿你的内容训练。我把开关位置和我自己账号的状态放在一张表里:
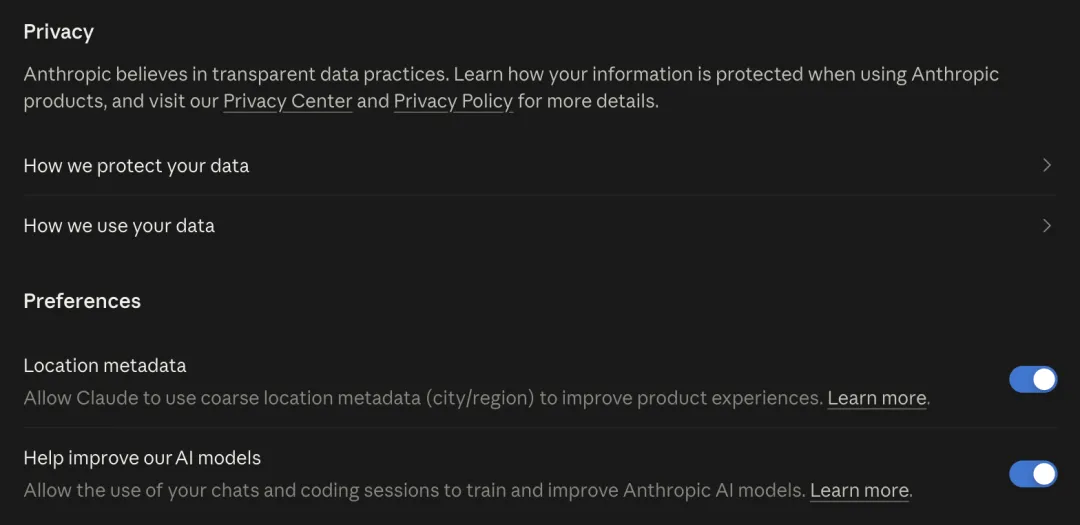
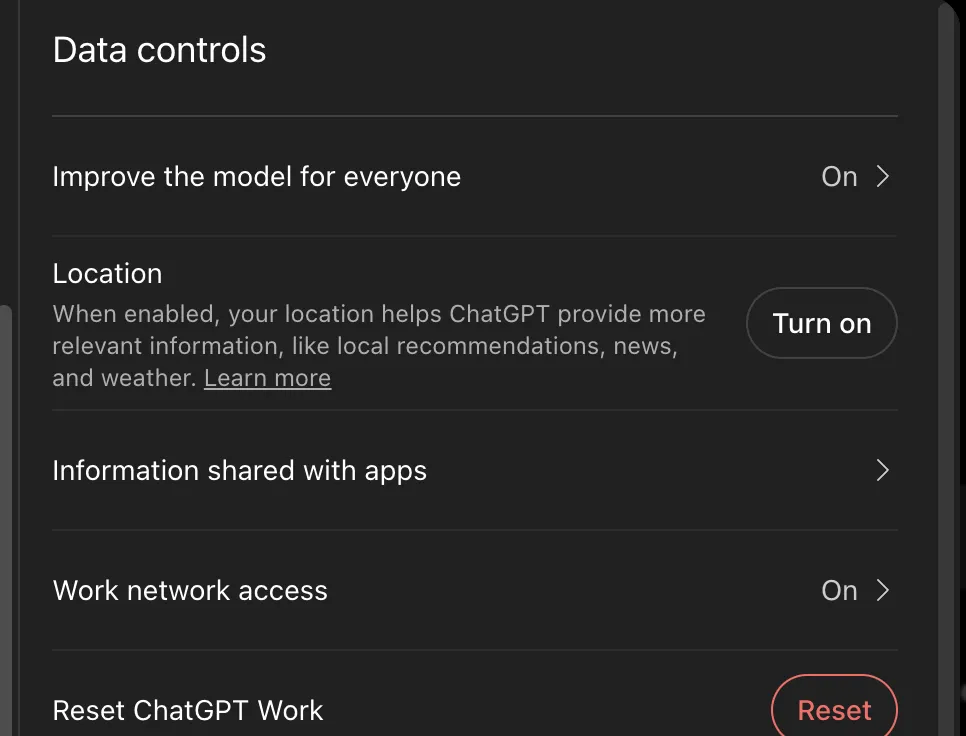
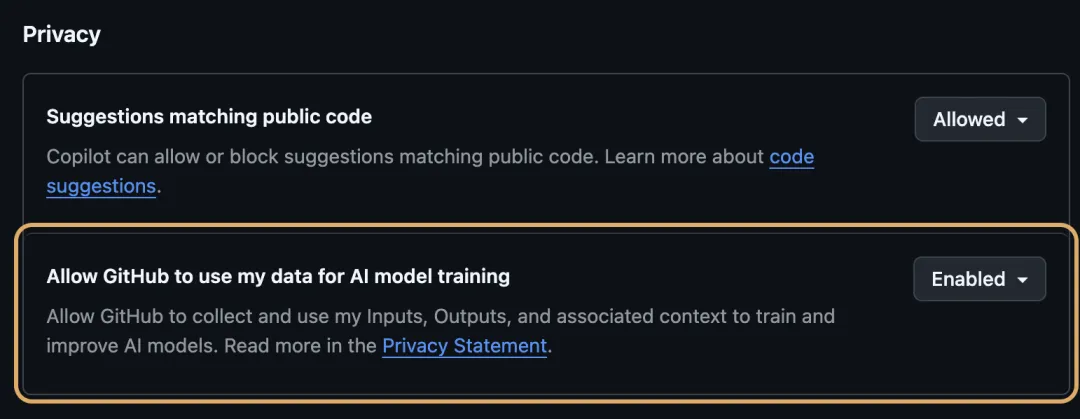
这张表只说明条款允许什么,说明不了这些公司实际拿了多少、怎么清洗、有没有真的用上你那几行代码。条款是上限,外人看不到实际用量。
规律很清楚:付钱的是公司,默认不训练;付钱的是你自己,默认大多是开着的。Cursor 的个人版默认值,它的数据使用页和隐私帮助页我都翻了,两处都没有写明是开还是关。
我自己这四个账号,Claude、Codex、Copilot 三个开着训练,全是个人账号。唯一关着的 Cursor,也是我个人付费的 Ultra 版。它的个人默认值官方没写,我这一个样本分不清是默认关,还是哪次弹窗里被我点掉了,所以只记一笔,不下结论。
Copilot 这次改动最能说明默认值有多大分量。GitHub 3 月 25 日发博客,4 月 24 日生效,Free、Pro、Pro+ 三档的交互数据开始用于训练[5]。博客里有一句:以前主动关过这个设置的人,选择保留,照旧不训练。所以这次改动碰到的,只有从没去过设置页的那批人,默认值替他们换了答案。
我的 Copilot 是 2025 年 2 月开通的免费版,这个月的额度一次没用过。它想拿我的数据也没多少可拿,但我登上去一看,开关照样是 Enabled。我 4 月之前从没进过这个设置页,所以默认值替我换答案的那批人里,有我一个。
GitHub 给的理由也很坦白:先拿微软自家员工的交互数据试过,多种语言的补全接受率都涨了,所以要"来自像你这样的开发者的真实交互数据"[5]。这句话把交易说清楚了:你每天接受、拒绝、改写补全的那些动作,正是它最缺的训练信号。公开代码网上到处都有,一个人怎么改 AI 写的代码,只有编辑器里才看得到。
"交互数据"四个字听着轻,GitHub 列的清单是这样的:你接受或改过的补全、发给模型的代码片段、光标附近的上下文、你写的注释和文档、文件名、仓库结构、你在文件之间怎么跳转,还有你给建议点的赞和踩。它也写明了不拿"静态存放的私有仓库内容",但你在编辑器里打开、被发给模型看的那几段,不在这个例外里。私有仓库挡住的只是没人打开的那部分。
终端里管不到的三扇门
第一扇,开关根本不在你的电脑上。我在本地找了一圈:~/.claude/settings.json 里 18 个键,没有一个和训练有关;~/.codex/config.toml 里也没有。~/.claude.json 里倒有一个名字很像的缓存字段 isQualifiedForDataSharing: false,而网页上的开关是开着的。我不知道这个字段具体管什么,但它至少说明:看本地配置,得不出你的代码有没有被拿去训练。
Cursor 是唯一能在本地看到状态的。它的本地数据库里写着 PRIVACY_MODE_NO_TRAINING,旁边还有一条记录,说明这个值已经和服务端对过账。开关一样在账号上,本地存的只是一份缓存。这几个工具在命令行里跑,训练开关却跟着网页账号走。一个人每天花八小时在终端里,这个开关放在一个他一年打开一次的网页设置里。
Anthropic 的文档里藏着一条硬数字:个人账号开着训练开关,数据保留 5 年;关掉,保留 30 天[2]。拨一下,保留期从 30 天变成 5 年。
第二扇,关了主开关只关了一半。Codex 在 ChatGPT 的主开关之外,还有一个自己的 "Include environments" 设置,管的是 Codex 云端任务的完整运行环境能不能拿去训练。OpenAI 的说明写得很直白:改 ChatGPT 那个开关,不会改这个[3]。所以关 Codex 要关两处:ChatGPT 的数据控制里一个,Codex 自己的设置里一个。
第三扇,是你自己递出去的。Claude Code 里敲 /feedback、/bug 或 /share,当前会话的完整记录连同代码一起上传,保留 5 年;会话结束弹出"能不能看一下这次的记录",点了 Yes,记录、子代理记录和本地日志一起传,保留半年,只有 API key 这类已知格式会被抹掉[2]。文档说这些不会拿去训练模型,但会用来改进产品。训练开关管不到这扇门,每次都得你自己点,只是很多人点的时候没想过里面装着什么。发 /feedback 之前,先想想这次会话里有没有贴过密钥或客户数据;不想每次被问,可以在环境变量里设 CLAUDE_CODE_DISABLE_FEEDBACK_SURVEY=1,把会话调查整个关掉[2]。
我的判断
开关都在,谁也没偷。但"默认开着、放在网页深处、改默认时发一封邮件",这套设计就是算准了大多数人不会去看。Meta 那档是另一回事:你得亲手在 model ID 后面拼上 -contributor,看得见价格才选得上,那是一笔明码交易。两件事放在一起,只说明一点:这份数据有价,Meta 的报价是便宜 12 倍左右;默认开着的那些开关,是在你没看的时候把它白送了出去。
如果你用个人订阅写公司的代码,今天就去把上面几个开关关掉,再问一句公司允不允许用个人账号,很多公司的合规条款比这些开关严。如果公司买的是 Team、Business、Enterprise 版,默认不训练,但先确认你终端里登录的是公司账号,不是自己的。如果写的本来就是公开在 GitHub 上的开源代码,这个开关对你意义不大,那些代码早就在别的训练集里了。至于 Meta 的贡献者档:跑一批不敏感的离线数据,便宜 12 倍是笔划算的买卖;接进团队日常工作流,100 次每分钟的限流会先让你放弃。
你上一次打开 AI 工具的隐私设置页,是什么时候?
参考资料
Meta:Muse Spark 1.3 Pricing and Rate Limits(2026-09)— https://dev.meta.ai/docs/pricing-rate-limits/
Anthropic:Claude Code Data usage — https://code.claude.com/docs/en/data-usage
OpenAI:How your data is used to improve model performance — https://help.openai.com/en/articles/5722486-how-your-data-is-used-to-improve-model-performance
Cursor:Data Use — https://cursor.com/data-use
GitHub Blog:Updates to GitHub Copilot interaction data usage policy(2026-03-25)— https://github.blog/news-insights/company-news/updates-to-github-copilot-interaction-data-usage-policy/