ARTICLE · 1080330
AI 写得越快,新人越难成为专家?
Andrew Ng 对 AI 的态度一直很积极。
他鼓励年轻人学习 AI,鼓励软件工程师把能自动化的工作交给模型,也鼓励市场、招聘、运营人员开始用 AI 构建自己的工具。在他看来,AI 也许可以接手一份工作中 30% 到 40% 的任务,但剩下那些需要人类完成的部分,反而会变得更有价值。
然后,他说了一句听起来几乎和前面矛盾的话:
AI 模型非常不适合学习。
https://www.youtube.com/watch?v=o-wv_szZ0V0
Andrew Ng 自己也会让 AI 解释一个陌生的前后端组件。答案出来了,项目完成了,一切都很顺利。六个月后再次遇到相同问题,他发现自己并没有记住,只好重新问一遍。
这不是 AI 没把事情做完。恰恰相反,正因为它完成得太顺利,人的大脑没有留下多少东西。
两件互相冲突的事,正在同时发生
现在的软件行业几乎同时相信两件事。
第一件事是,不使用 AI 的工程师会落后。Coding Agent 可以读代码、写功能、补测试、查问题,过去需要几天的工作,现在可能几个小时就能完成。
第二件事是,AI 生成的代码仍然需要有经验的人审查。你需要判断设计是否合理、抽象是否泄漏、测试是否覆盖真正的风险、一个看似能跑的方案会不会在半年后变成负担。
这就产生了一个尴尬的问题。
正确使用 AI,需要架构、调试和判断能力。可如果一个新人从第一天起就把规划、实现和排错交给 AI,他又要从哪里获得这些能力?
Lars Faye 在 AI Coding will Prevent Expertise 里把它称为熟练编排者悖论:管理 Coding Agent 所需的能力,正是长期使用 Coding Agent 可能削弱的能力。
今天从 AI 里获益最多的人,大多已经工作了很多年。他们在没有 Agent 的年代里写过失败的代码,追过没有日志的 Bug,亲手推翻过扩展不下去的设计。这些经历已经变成一种很难说清楚的直觉。
他们看见一段代码,会觉得这里以后可能出事。未必能立刻指出哪一行错了,但知道应该停下来查一遍。
AI 放大了这种经验,却没有自动把经验传给新人。
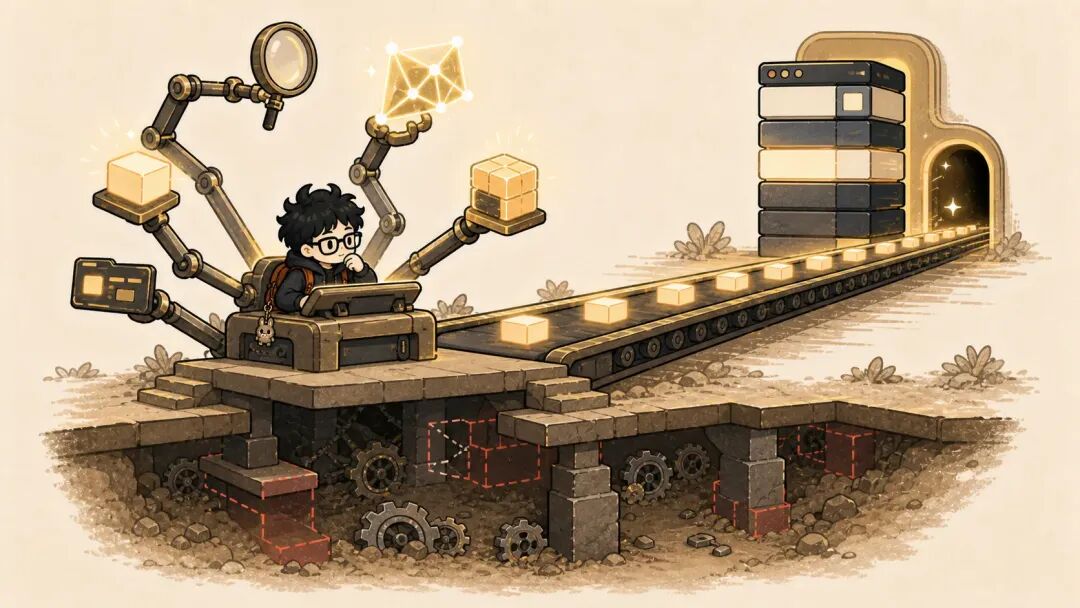
于是,一种很奇怪的角色开始出现:他能在 AI 帮助下交付超出自身能力范围的系统,却不能独立解释这个系统为什么这样工作,更不知道它什么时候会坏。
他拥有专家级的输出,却没有专家级的理解。
完成一道题,和学会解决这类题,是两件事
这个问题已经不只是一种行业焦虑。
2024 年发表的一项研究观察了 21 场编程新手使用生成式 AI 的实验。21 名参与者里有 20 人完成了题目,表面上看,AI 几乎让所有人都成功了。
但研究者看到的不是整体进步,而是一道被拉大的裂缝。
本来就有计划、知道自己要写什么的学生,会把 AI 用在已经形成的思路上。他们可以接受有用的补全,也能忽略错误建议。研究者把这种能力称为负面专业知识:知道什么建议不值得听。
原本就缺少规划能力的学生,则更容易跟随 AI 的方向。他们跳过问题分析,被生成结果带着走,最后获得的不是理解,而是能力错觉。他们以为自己表现得很好,实际却无法说明刚刚发生了什么。The Widening Gap
这项研究的样本不大,也不能证明所有编程新手都会因此退步。但它揭示了一个重要差别:
AI 既可能加速你已经会做的事情,也可能掩盖你根本不会做这件事。
AI 在场时成绩更好,拿走以后反而更差
宾夕法尼亚大学参与的一项实验,把这个问题放到了更大的样本里。
研究覆盖了土耳其一所高中的近 1000 名学生。学生被分成三组:只能使用教材的对照组、可以直接询问 GPT-4 的 GPT Base 组,以及只能获得提示、不能直接拿答案的 GPT Tutor 组。
在有 AI 帮助的练习阶段,两组的表现都大幅提高:
GPT Base 组比对照组高 48%; GPT Tutor 组比对照组高 127%。
如果实验到这里结束,结论会非常漂亮:AI 显著提高了学习效率。
但随后研究者拿走所有工具,让学生独立完成考试。
GPT Base 组比从未使用 AI 的学生低了 17%。练习时最容易获得完整答案的人,在真正需要自己解题时反而表现更差。
GPT Tutor 组的负面影响基本消失了,但也没有在独立考试里显著超过对照组。它让学生在练习时走得更快,却没有证明他们最终学得更多。PNAS 研究
更值得注意的是,学生并没有意识到自己学得更少。他们感觉 AI 很有帮助,也觉得自己的表现不错。
产出变好、信心上升、能力下降。这三个现象可以同时发生。
在真实编码任务里,差距最大的恰好是调试
Anthropic 在 2026 年做了一项更接近软件工作的随机实验。
52 名大多处于初级阶段的软件工程师,需要使用自己不熟悉的 Python Trio 库完成两个功能。一组可以使用 AI 助手,另一组手写代码。任务结束后,所有人参加一场测试,内容覆盖代码阅读、调试、编写和概念理解。
AI 组平均只快了约两分钟,这个速度差异没有达到统计显著。理解差异却很明显:AI 组平均得到 50%,手写组为 67%,接近两个字母等级的差距。
落差最大的题型是调试。
手写组遇到了更多错误。他们需要理解错误、修改假设,再重新运行。这个过程看起来更慢,却让他们更清楚代码为什么失败。
AI 组中,直接把实现和排错委托给模型的人完成得很快,测试成绩通常不到 40%。表现较好的参与者会追问概念、要求解释,或者在拿到代码以后验证自己的理解。Anthropic 研究
这项研究同样有边界。样本只有 52 人,测试发生在任务结束后不久,不能直接代表几年后的职业能力。实验使用的侧边栏助手也不同于能自主修改仓库的现代 Coding Agent。
但这个限制并没有让问题变轻。Anthropic 自己指出,更自主的 Agent 对技能形成的影响可能更明显。
摩擦不是学习路上的 Bug
我们习惯把开发中的阻力看成需要消灭的东西。
查文档很慢,等编译很慢,定位类型错误很慢,理解一套陌生框架更慢。AI 能直接跳过这些过程,自然会被理解成一次效率升级。
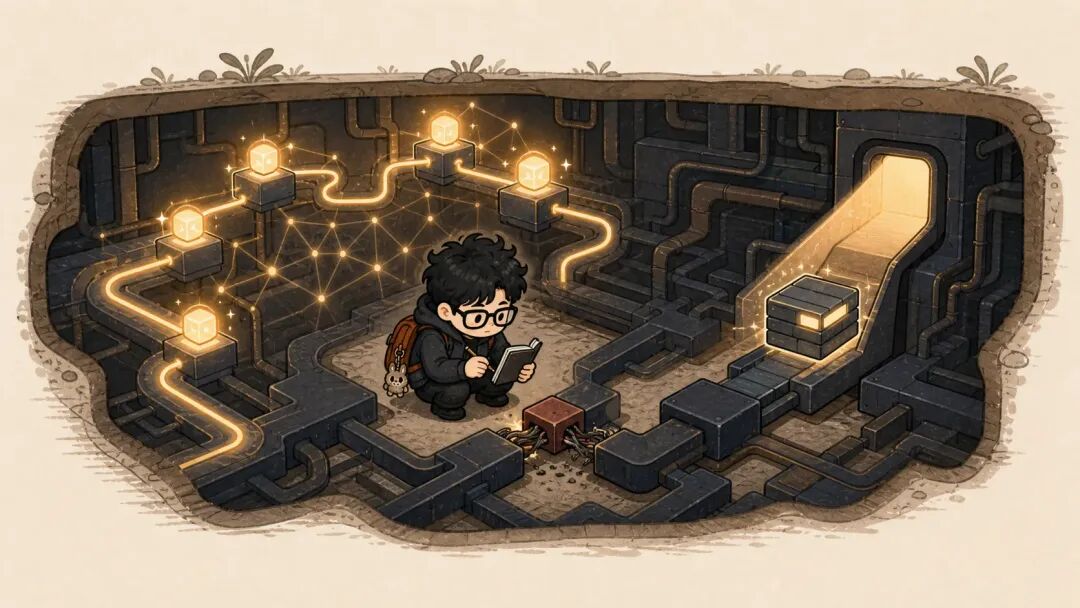
问题是,并非所有摩擦都是浪费。
有些摩擦只是在消耗时间,例如抄样板代码、调整格式、重复迁移字段、机械地查找 API。这些工作适合交给 AI。
另一些摩擦承担着形成能力的任务:
在动手前建立问题模型; 猜测错误可能出现在哪里; 比较两个方案为什么一个更容易扩展; 亲手验证生成结果和系统行为是否一致; 在没有现成答案时缩小问题范围。
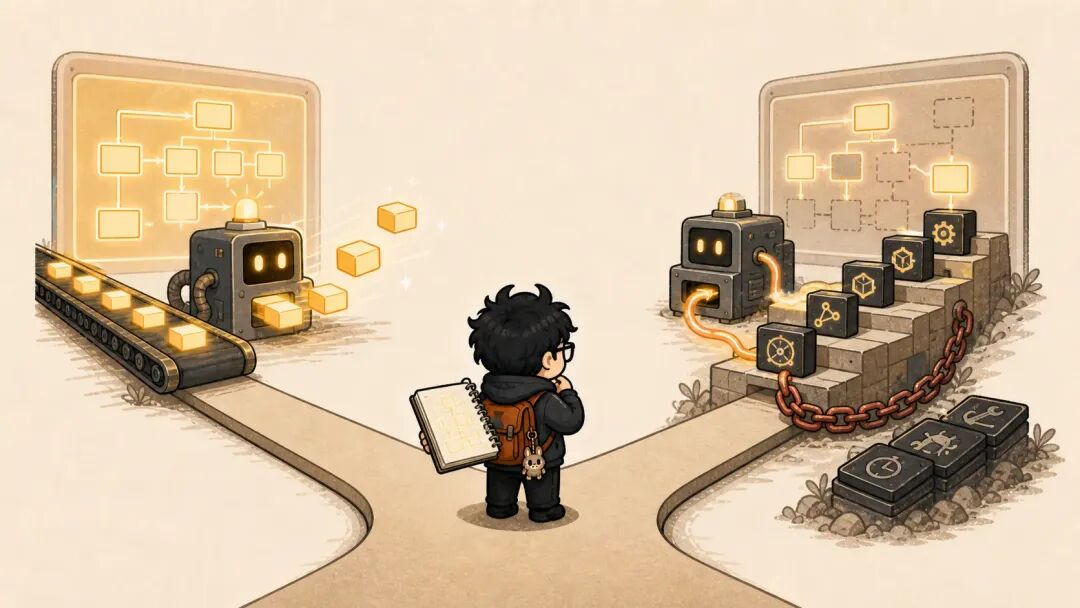
这些过程不是交付前的绕路。它们就是专业能力的生产线。
学习做菜的人可以看一个月的视频,也能准确描述一块五分熟牛排。但第一次真正站在锅前,他仍然可能把牛排煎老。温度、声音、气味和时间形成的判断,无法只通过观看答案获得。
软件开发同样如此。所谓工程直觉,很大一部分来自那些不顺利的时刻。
认知卸载,还是认知负债
把工作交给工具本身没有问题。
我们不会坚持手算每一笔账,也不会为了理解网络协议而拒绝使用 HTTP 框架。抽象一直在推动软件发展。
真正需要区分的是认知卸载和认知负债。
认知卸载是把已经理解的机械工作交出去。即使 AI 消失,你仍然知道目标是什么、结果是否正确,以及出问题时该从哪里开始查。
认知负债是把自己尚未形成的判断也一起交出去。代码暂时可以运行,但你没有获得维护它所需的心智模型。以后每一次修改、排错和升级,都需要继续向 AI 借能力。
区分两者可以用一个简单问题:
“ 如果现在拿走 AI,我还能解释、修改和诊断刚刚生成的东西吗?
如果答案是否定的,刚才节省下来的时间未必是效率,也可能只是一笔没有显示在项目面板里的债务。
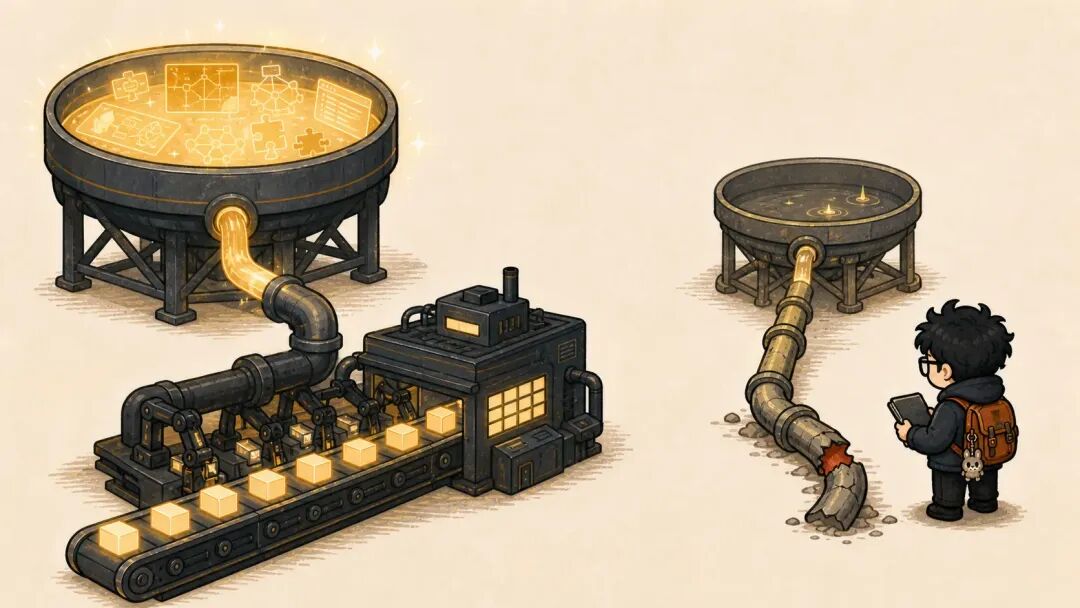
真正的风险,是专家供给管道断裂
资深工程师使用 AI,短期内通常不会失去全部能力。
他们已经经历过形成专业判断所需的训练。AI 可以替他们写样板、搜索代码、尝试修复,而他们负责决定方向和验收结果。
企业看到这部分收益后,很容易得出一个看似合理的结论:既然资深工程师使用 AI 后可以产出更多,那么所有工程师都应该尽可能多地使用 AI。
但同一个工具作用在新人身上,可能产生完全不同的结果。
新人缺少的不是打字速度,而是判断什么值得生成、什么结果不能相信、什么时候应该推翻整个方案。如果训练过程只奖励功能有没有按时交付,最理性的选择就是把更多思考交给 AI。
几年以后,团队也许拥有更多代码,却没有足够多能接住这些代码的人。
这才是所谓专家供给管道的风险:我们正在消费上一代工程师积累的判断,却没有给下一代留下形成同等判断的机会。
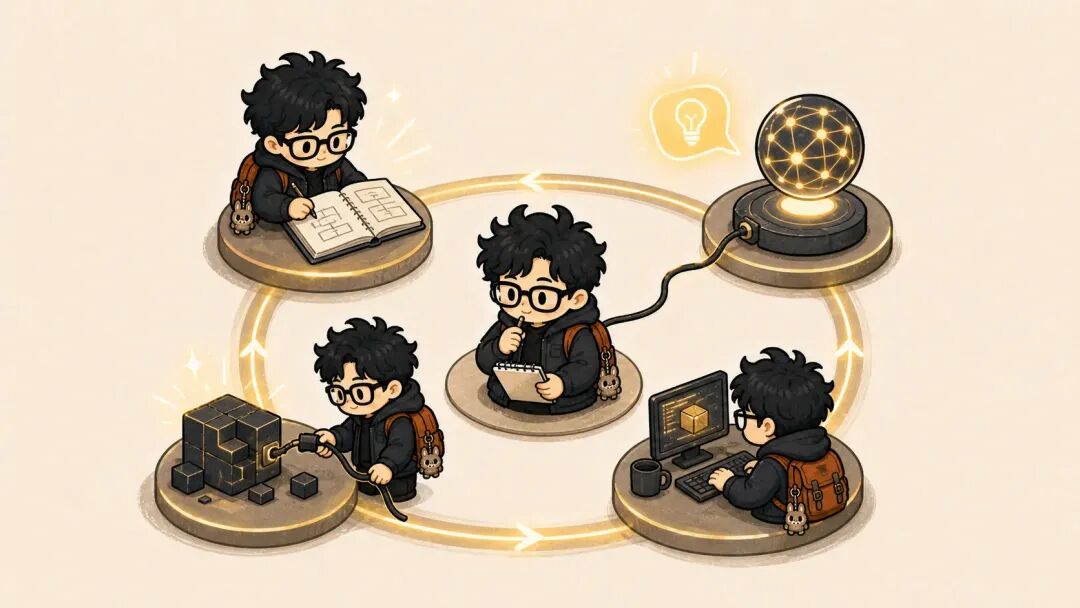
一套摩擦优先的 AI Coding 方法
答案不是禁用 AI,也不是要求所有人重新手写每一行代码。
更合理的方式,是根据任务目的决定把哪些摩擦保留下来。
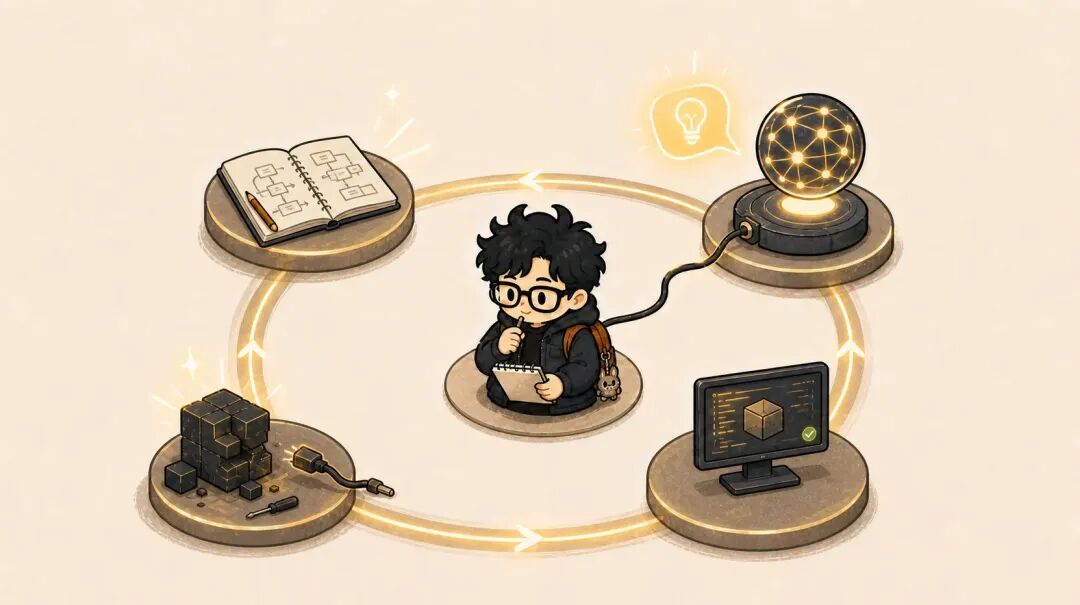
熟悉领域:让 AI 承担机械劳动
当你已经理解问题和实现边界,可以让 AI 生成样板、补重复测试、完成迁移、查找调用点或整理文档。此时 AI 压缩的是劳动,不是学习过程。
陌生领域:先形成自己的预测
在询问 AI 以前,先写下你对问题的理解、可能的方案和不确定点。哪怕猜错也有价值,因为后续回答可以和一个明确的心智模型发生碰撞,而不是直接覆盖一片空白。
把给答案改成给提示
让模型指出缺失条件、提出反例、解释错误或追问设计,而不是直接完成实现。AI 可以扮演陪练,但关键推理仍然由人完成。
生成以后,要求自己完成一次所有权测试
不看对话,解释代码的数据流和失败路径;修改一个模型没有预料到的条件;故意制造错误,再独立定位。能完成这些动作,才说明代码开始属于你。
定期安排没有 AI 的重放
对刚学会的概念,隔几天重新实现最小版本,或者在没有 AI 的情况下解决一个相似问题。记忆不是在第一次看懂时形成的,而是在需要重新取回时被加固的。
团队不能只测交付速度
如果公司的唯一指标是需求吞吐量,那么新人把思考交给 AI 是完全合理的行为。
要保护长期能力,团队需要改变验收方式。
代码评审不能只问功能能不能跑,还要问作者能不能解释关键选择、失败模式和回滚路径。新人需要拥有从问题分析到线上验证的完整任务,而不是只负责把 Agent 生成的代码搬进仓库。
团队也需要保留一部分不会立刻转化为产出的时间:阅读底层实现、独立调试、复盘故障、重写失败方案。这些活动短期看起来降低速度,却在生产未来能承担系统责任的人。
AI 使用政策同样不应该只有允许或禁止。更重要的规则是:
哪些任务可以完全委托; 哪些决策必须由人先形成方案; 哪些知识需要在没有 AI 的情况下验证; 谁对生成代码的长期维护负责。
当 AI 写出的代码越来越多,人的价值不会只剩下点击接受。真正稀缺的是知道什么时候不应该接受。
AI 没有改变人类学习的基本方式
AI 可以让人完成原本做不到的事情。这是真实的生产力。
但完成一项任务,不代表获得了完成这类任务的能力。两者过去经常一起发生,现在被 AI 拆开了。
这也解释了 Andrew Ng 那个看似矛盾的判断。他一边要求每个人学习 AI、用 AI 构建,另一边又担心 AI 破坏学习。因为生产和学习本来就不是同一个目标。
生产模式关心结果是否尽快出现。学习模式关心结果出现以后,人的能力是否发生了变化。
我们真正需要防止的,不是 AI 写太多代码,而是人类在代码越来越多的时候,逐渐失去理解、修正和接管它们的能力。
如果未来的 Coding Agent 仍然需要专家监督,那么今天最重要的工程问题之一,就是不要在享受专家生产力的同时,切断专家的生产线。
参考来源
Andrew Ng:The Biggest Opportunities in AI Aren't Where You Think Lars Faye:AI Coding will Prevent Expertise The Widening Gap: The Benefits and Harms of Generative AI for Novice Programmers Generative AI without guardrails can harm learning Anthropic:How AI assistance impacts the formation of coding skills