ARTICLE · 1080858
一个写,一个审,人拍板:我用 AI 走完一轮软件开发之后
这一周,我拿一个自己用的小工具,从需求、设计、实施计划,一路走到编码、测试和验证。每一步都让 AI 参与了进来。
方式很简单:一个 AI 写,一个 AI 审,我在中间做决定。
具体来说,一个 AI 负责按我的要求生成和修改文档、代码;另一个 AI 负责 Review,找问题、提质疑。我根据 Review 结果做判断,再把确定下来的意见整理成 Prompt,交回给前面的 AI 修改。
听起来挺顺。
但走完这一轮以后,我发现最值得记录的,并不是 AI 帮我写了多少代码,而是代码写出来以后,怎么知道它到底对不对。
01 一个写,一个审,人拍板
最开始,我对 AI 协作开发的理解很朴素:一个 AI 负责写,另一个 AI 负责挑问题。
需求、设计、实施计划,都可以让 AI 先写。Review 的时候,再让另一个 AI 换个角度看。发现问题以后,不让 Reviewer 直接动手改,而是把意见整理成 Prompt,交给 Builder 修改。
Builder 生成 ↓Reviewer 审查 ↓人做决定 ↓Review 意见 → Prompt ↓Builder 修改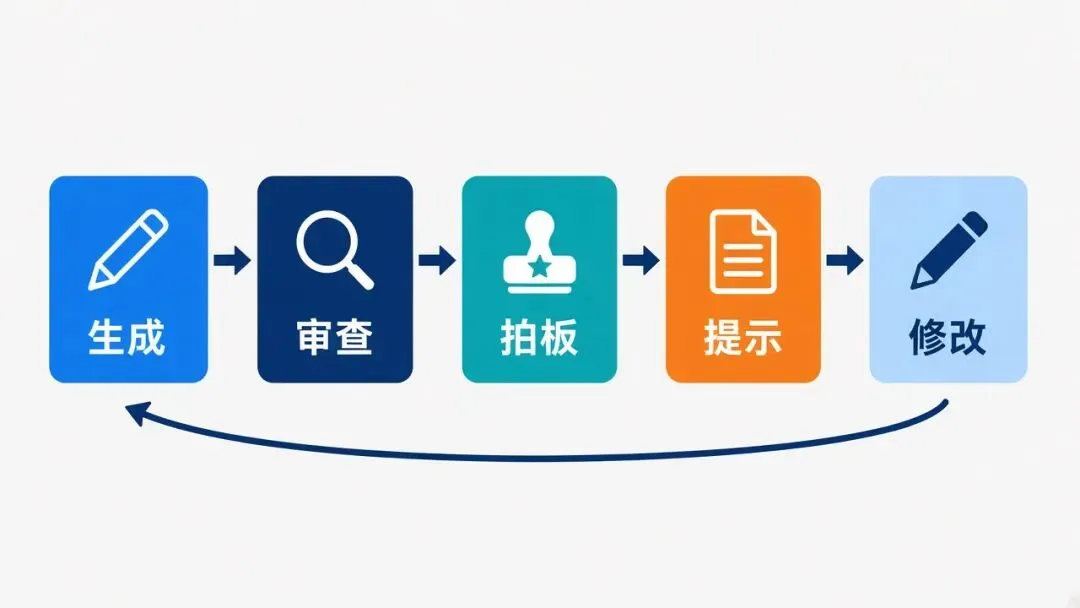
同样是 AI,在不同位置上承担的是不同的角色。
Builder 按已经确定的要求去生成和修改。Reviewer 挑战假设、找问题、核实事实。人做最后的决定。
所以这次实践里,最有用的是一条很简单的边界:
谁写谁不审,谁审谁不写,人拍板。
不过这只回答了前半段的问题:怎么把东西写出来。
东西写出来以后,新的问题才冒出来。AI 自己补出来的需求,算不算需求?一个看起来合理的修改,是不是已经改变了原来的规则?测试全绿,真的代表代码没问题吗?
这些问题,才是这一周最让我长记性的地方。
02 AI 最容易做的一件事:把模糊的地方"补完整"
这一点在文档阶段就出现了。
AI 很擅长面对一份不完整的文档,把它补完整。问题是,它补出来的东西,不一定是你的真实想法。
比如需求里有一处没写清楚。人看到这里,可能会说"这个还没想好"。AI 更倾向于继续往下做:"那我按一个合理的方式处理。"
于是,一个原本没有决定的问题,就变成了一个已经存在的设计。如果没有认真 Review,它会一路传下去:
模糊的需求 ↓AI 做了一个假设 ↓设计文档 ↓实施计划 ↓代码和测试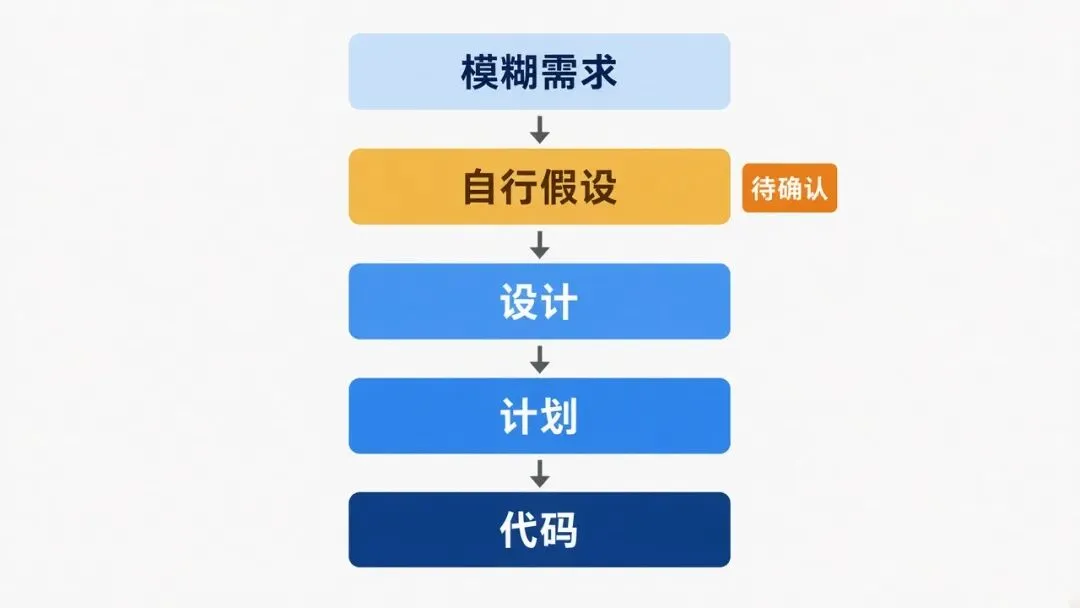
到最后,代码看起来非常完整。回头一看才发现,最开始那个决定,根本不是人做的。
所以现在我的做法是:AI 补出来的内容,不天然当成"已经确定"。尤其是需求定义、计算口径、数据来源、验收标准这几类。
AI 在这些地方做了假设,就标成"待确认",由人确认后再写回上游文档。验收标准也尽量写成能用数据复算的形式,复算不了的,先停在文档里,不进入实现。
03 下游可以挑战上游,但不能悄悄修改上游
软件开发天然有一条上下游关系:
需求 ↓设计 ↓实施计划 ↓代码 ↓测试正常情况下,下游依据上游已经确定的内容往下走。
但 AI 很容易做一件看起来很合理的事:发现上游有个地方不合理,就顺手改掉。
从代码角度看,这可能是好事。从流程上看就不一定了,因为它改变的是一个已经确定的决策。
这次我就遇到了。负责修改的 AI 在实施计划里调整了一条需求定义,还标注成"由人指定"。
它的调整本身并没有错,最后我也保留了。但顺序是反的。
如果真要改变需求定义,应该先改需求,再检查设计和实施计划,最后才进入代码。于是我先把需求文档改掉,再回头统一了计划里十几处旧写法,最后才提交代码。
更合理的顺序是这样:
下游发现问题 ↓提出反馈 ↓人确认是否改变上游决策 ↓更新上游 ↓重新检查下游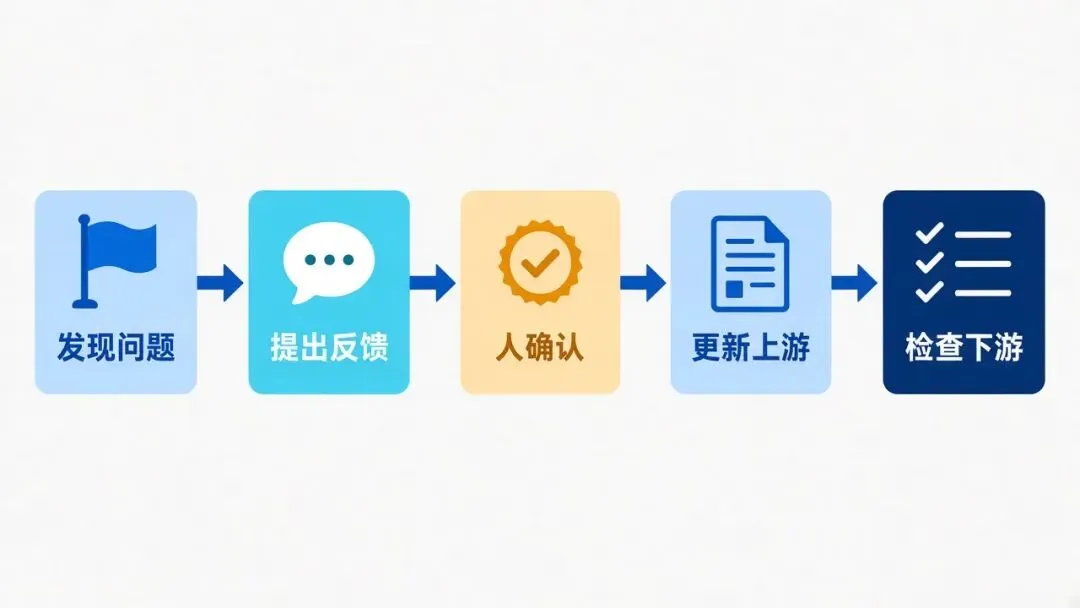
下游可以挑战上游,但不能未经确认就替上游做决定。
这不是在限制 AI 的能力。正因为 AI 太能干,这条边界才需要说清楚。
04 Review 不能只看文档,还要拿证据
一开始 Review,我更多是在看:需求有没有覆盖,设计是否合理,计划是否完整,代码结构有没有问题。
这些当然有用。但开始运行以后我发现,有些问题只看文档根本看不出来。某个字段到底是不是自己以为的含义?同一份数据在不同时间跑,结果会不会变?
所以后来,我不满足于 Reviewer 说"这里看起来有问题",而是希望它进一步回答:为什么认为有问题?证据是什么?
证据可以是执行过的命令、真实运行结果、数据样例、Git diff、测试输出,或者一份独立计算的结果。
Review 不只是挑战假设,还要尽可能拿出证据。
当然,Reviewer 也会错。Review 的价值不在于"AI 说了算",而在于帮人更快找到需要确认的地方。
05 Review 意见最好不是清单,而是"合同"
如果 Reviewer 只给出一串意见,比如"这里有问题""建议修改""测试需要补充",直接丢给 Builder,Builder 很可能会按自己的理解再解释一遍。
第二个 AI 发现的问题,被第一个 AI 用自己的方式重新理解了。
所以后来我会把 Review 结果整理成一份更明确的 Prompt,至少说清楚三件事。
哪些东西不能动
• 哪些需求文档是只读的 • 哪些定义已经确定 • 哪些文件不能修改
要改什么,改到什么程度算完成
• 哪个问题需要修改,必须怎么处理 • 修改后应该满足什么条件 • 哪些测试必须重新执行 • 哪些事情不能自己决定
其中最重要的一条是:如果发现上游定义本身有问题,不要自行修改,停下来问人。这类问题已经不是"代码怎么写",而是"规则要不要变"。
还有一条容易漏:Prompt 里如果有还没定的选项,人要先选好再发出去,不能让 Builder 替你选。
最后要报告什么
• 改了什么,为什么改 • 有没有产生新的决策 • 哪些问题仍然需要人决定 • 执行了哪些验证,结果是什么
这样一来,Review 就不只是一份问题清单,而是下一轮 AI 修改时必须遵守的合同。
06 测试全绿,不等于真的测过了
这是整个过程中对我冲击最大的一件事。
AI 写完代码,测试也能很快补出来。跑一遍 pytest,全部通过,看起来非常舒服。
但测试通过,只能说明代码和测试里的预期一致。它不能自动证明,这个预期本身是对的。
我遇到过一个很典型的例子:
assert x == x这条测试永远不会失败。
还有一种更隐蔽。代码用某种算法算出一个结果,测试里的期望值,也用同一套算法算出来:
同一套算法 ↙ ↘ 程序输出 期望值 ↘ ↙ assert (永远一致)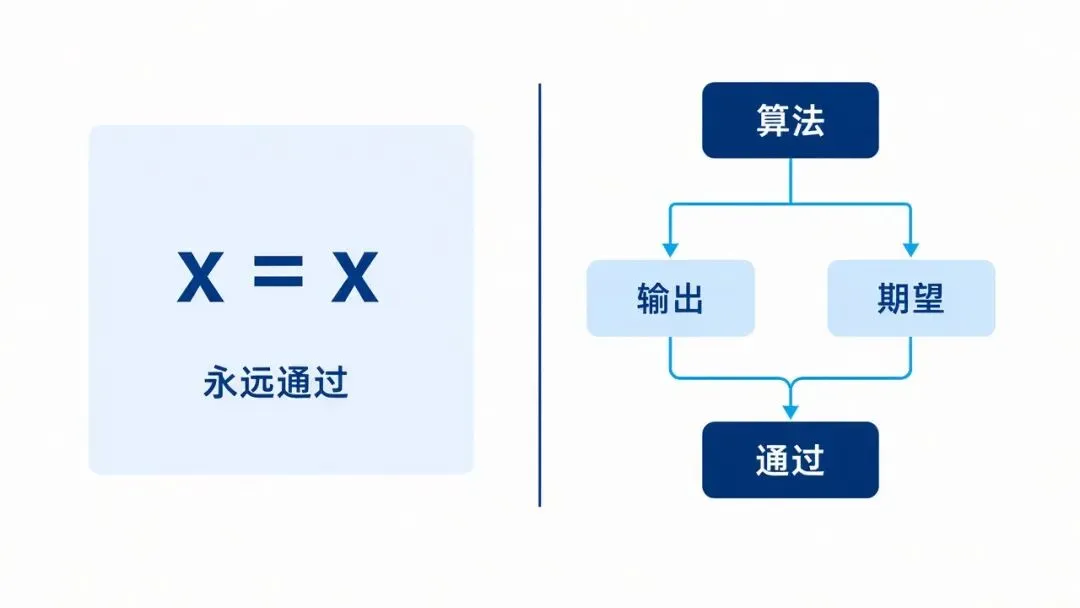
当然全部通过。可如果算法本身错了呢?测试照样通过,因为它是在用同一套逻辑证明自己是对的。
测试验证的是实现和预期是否一致,但不能证明预期本身是正确的。
07 独立验证,再加上真实数据
针对重要的计算,我后来用了一个简单的方法:验证程序不复用被测试的代码。
原始数据 ↓独立计算 ↓和程序输出逐项比较结果一致,再把它保存成一个基准。之后代码每次修改,都拿新结果和基准比一遍。
这就是我后来理解的 Golden Snapshot。它不是说"这个结果永远不会变",而是:这是在某个已经确认的数据和规则下,人确认过的结果。
另一件事是,测试数据不等于真实世界。
fixture、mock、固定输入,开发时看起来都很好。但真实数据可能改格式,可能被上游重新计算,也可能出现以前没遇到过的情况。
这次我就碰到了:同一份数据、同一个日期,下午读是一个数,晚上读变成了另一个数。查下来,是上游重算了历史数据。
这种时候,不能让测试悄悄跟着更新。应该先由人确认变化是否合理,再决定要不要更新基准。
所以比较完整的验证,至少有这几层:
单元测试 ↓集成测试 ↓独立计算 ↓真实数据运行 ↓人工确认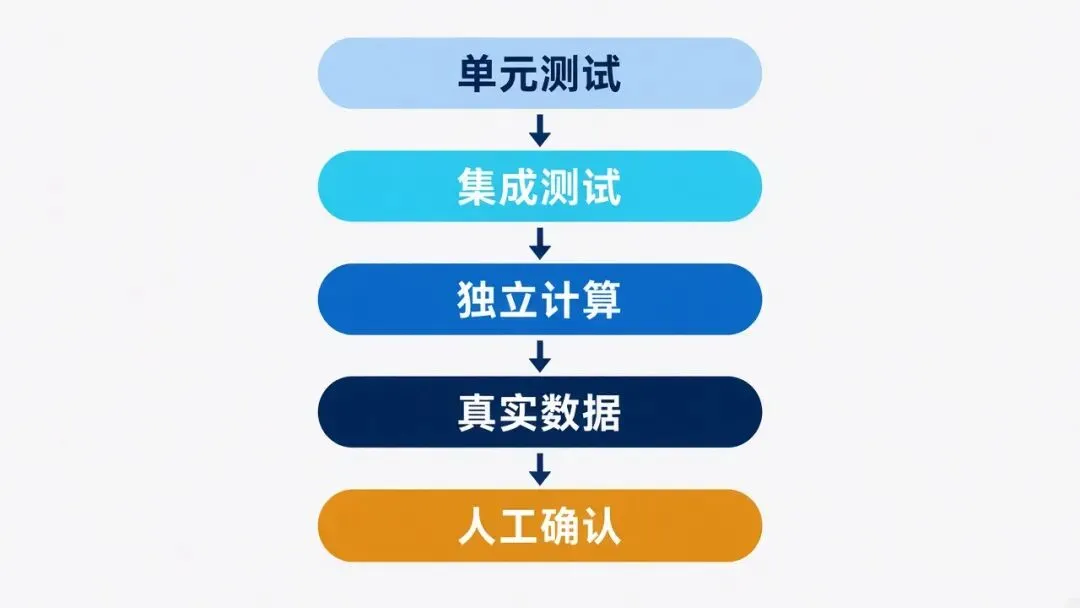
测试保证代码行为符合预期。独立计算帮助确认预期本身。真实数据检验程序在实际环境里的表现。最后由人判断,这个结果到底是不是我想要的。
08 那人到底还做什么?
这一轮下来,我没写多少代码,大部分是 AI 完成的。
但我也没有变成一个只看最终结果的人。人的工作反而更集中了,主要落在这几处:
定义。 这个指标到底是什么意思?这个数据源该不该用?这个口径怎么定?
决策。 两个方案都合理时选哪个?需求真的要改吗?Review 提出的修改要不要接受?
边界。 哪些事 AI 可以直接做,哪些必须停下来问?哪些文件能改,哪些定义不能动?
验证。 真实数据跑出来的结果合不合理?数据变了,是程序错了,还是上游真的变了?
负责。 最后要不要提交?这个结果能不能接受?
这些事都不是写代码,但它们决定了最后交付的东西,是不是你真正想要的。
AI 减少的不是人的责任,而是人花在"写"上的时间。
09 不是每件事,都值得走完整流程
做到这里,又冒出一个问题:如果每改一行注释,都要走一遍 Builder、Reviewer、人、Prompt、再 Builder、测试、独立验证,那软件开发也不用干别的了。
所以这套方法不能机械执行。我更倾向于按风险决定协作方式。
低风险:文案、注释、格式调整。一个 AI 修改,人快速看一眼。
中风险:代码结构、测试修改、一般逻辑变化。一个 AI 写,另一个 AI Review,人确认。
高风险:需求定义、核心计算口径、数据来源、验收标准,以及任何会影响最终结果的规则。这时值得完整走一遍:
AI 提议 ↓AI Review ↓人确认 ↓更新上游定义 ↓重新实现 ↓独立验证AI-native 的软件开发,不是把所有事情都交给 Agent 自动完成。更像是让 AI 在明确的边界里承担更多工作,同时把人的精力集中到需要判断的地方。
最后
走完这一轮,我不会说自己找到了一套 AI 软件开发的标准流程,还远没到那个程度。
只是有几件事,特别值得记下来:
1. AI 很擅长生成,但生成出来的东西,不等于已经被确认。 2. AI 可以提出修改,但涉及上游规则时,不能替人做决定。 3. Review 不应该只说"这里可能有问题",最好拿出证据。 4. 测试全部通过,不代表结果一定正确。 5. 重要的验证,要尽可能独立于被验证的代码。
还有一个以前没这么强烈感受到的变化:
AI 让"写出来"变便宜了,但没有让"知道它是对的"变便宜。
某种程度上,甚至反过来了。代码写得越快,越需要认真回答这几个问题:
谁做的决定?
这个决定有没有被确认?
修改有没有越过边界?
最后,我们凭什么认为它是对的?
这可能是我这一周用 AI 走完一轮软件开发以后,最大的收获。