ARTICLE · 1081169
给 AI 编程助手立一套规矩,我找到了一个开源的现成答案
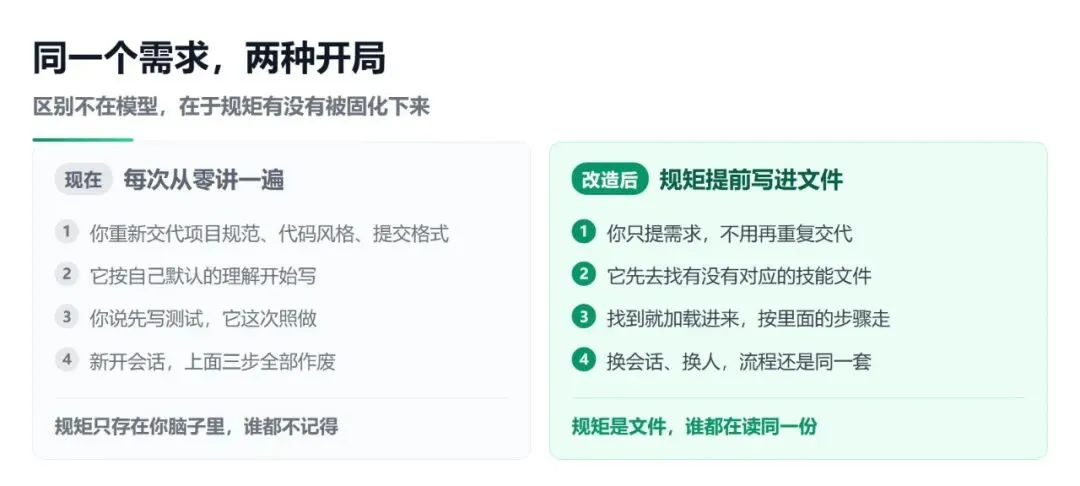
让 AI 写代码,难的不是它写不出来,而是每次开工你都得重新跟它讲一遍规矩。有没有办法把规矩提前固化下来,让它自己照着做?
团队里用 AI 写代码,久了都会遇到同一个问题。
第一次用,感觉很好。你给它一段需求,它写出一版能跑的代码,省下的时间很实在。
用到第二个月,问题就冒出来了。
同一套项目规范,今天讲一遍,明天新开一个会话,它又忘了。你要求它先写测试再写实现,它这次照做,下次直接甩给你三百行改动,测试一行没有。你让它改完自己跑一遍验证,它说「已经完成」,你一看根本没跑起来。
问题不在模型聪明不聪明,在于每次开工它都从零开始,而你的规矩只存在于你的脑子里。
01PART规矩要搬进文件,但别搬进一个大文件WHY FILES
大多数人应对这个问题的办法,是把要求写进项目的说明文件。这有用,但很快就遇到天花板。
一是太长。项目规范、代码风格、提交格式、测试要求、部署流程,全塞进一个文件,写到最后几千字。文件越长,模型真正读进去的越少,后面的内容基本等于没写。
二是太糊。「注意代码质量」这种话,写了等于没写。模型不知道「质量」在你的语境里到底指什么,它只能按自己的默认理解来。
真正能起作用的规矩,得满足三个条件:够具体、能被拆开、能按需加载。
具体到「先写一个跑不通的测试,再让它通过,然后动手清理」这种可以照着执行的动作
拆成一块一块,每块只解决一件事,而不是一锅炖
只在需要的时候才加载进来,不用把所有内容一次性灌进上下文
这三个条件,正好是 Agent Skills 这个机制的设计目标。而今天要说的是一个把这套机制用到极致的开源项目。
02PART这是个什么项目WHAT IS IT
一句话:一个给 AI 编程助手用的「开发方法论 + 技能库」。
项目叫 Superpowers,作者是人称 obra 的 Jesse Vincent。它在 GitHub 上有 29 万星,今天一天涨了 468 星,MIT 协议。
它做的事情,用一句话概括就是:把一套完整的软件开发方法论,拆成十几个 AI 能读懂、能照做的技能文件,再想办法让 AI 主动去用它们。
它不是一个工具库,也不是一个框架。装完之后你并不会多出什么命令,多出来的是 AI 在开工之前会自动去查的那几份「作业指导书」。
这个区别很关键。市面上的 AI 编程工具,争的是模型能力、上下文长度、代码补全速度。Superpowers 换了个方向:它假定模型能力已经够用,卡住你的是流程和纪律。
03PART它的核心机制:技能文件长什么样HOW SKILLS WORK
要理解这个项目,只要理解一件事:它的全部内容,都是一个个文件夹。
文件夹里最核心的是 SKILL.md,其余是可选的辅助文件
参考文档、脚本、模板按约定放在子目录里
一个技能包的结构大致是这样:
text
skills/
└── test-driven-development/
├── SKILL.md
├── references/
│ └── testing-anti-patterns.md
└── scripts/
└── run-tests.sh
SKILL.md 是这个技能的唯一入口。文件开头有一段元信息,告诉 AI 这个技能叫什么、什么时候该用它:
markdown
---
name: test-driven-development
description: Use when implementing any feature or bugfix, before writing implementation code
---
真正有意思的是 description 这个字段。它不是写给人看的说明,是写给 AI 看的触发条件。
模型在每次任务开始时会扫一遍所有技能的 description。判断当前的活儿符不符合条件,符合就把那份 SKILL.md 整个加载进来,按里面的步骤走。
这就绕开了前面说的那个天花板:技能可以有很多个,每个都写得足够细,但任何一次任务只加载真正用得上的那几份。上下文没被浪费,规矩又足够具体。
技能里写的,是流程不是原则
知道了结构,下一个问题是:这些技能文件里究竟写了什么?
答案是「可以照着执行的步骤」,而不是「原则」。
举个例子,这个项目里有一个叫 systematic-debugging 的技能。它没有写「要仔细排查问题」,它规定了一套四个阶段的动作:
第一阶段,先复现问题,把失败稳定地跑出来。复现不了就不许往下走。
第二阶段,在复现的基础上定位根因,不许靠猜,要有证据。
第三阶段,动手修,并且解释清楚为什么这么修。
第四阶段,验证修完之后问题真的消失了,同时确认没有引入新的问题。
每一步都有明确的进出口条件。「复现不了就不许往下走」这句话,比「要仔细排查」有用一百倍。
同一个技能包里还带了几个辅助文档,专门讲极端情况怎么办:
root-cause-tracing,讲根因追到哪一层才算到底
defense-in-depth,讲修完之后要不要加防御性检查,加到什么程度算够
condition-based-waiting,专门解决异步代码里「等一个固定时长」这种经典错误
这几份文档不是给人读的说明书,是 给 AI 在卡住的时候去查的补充材料。它们平时不加载,只在对应技能被触发时才被读进去。
这套写法我认为是这个项目最值得学的地方:不写原则,写流程。不写要求,写条件。
04PART它自带的技能库THE SKILLS LIBRARY
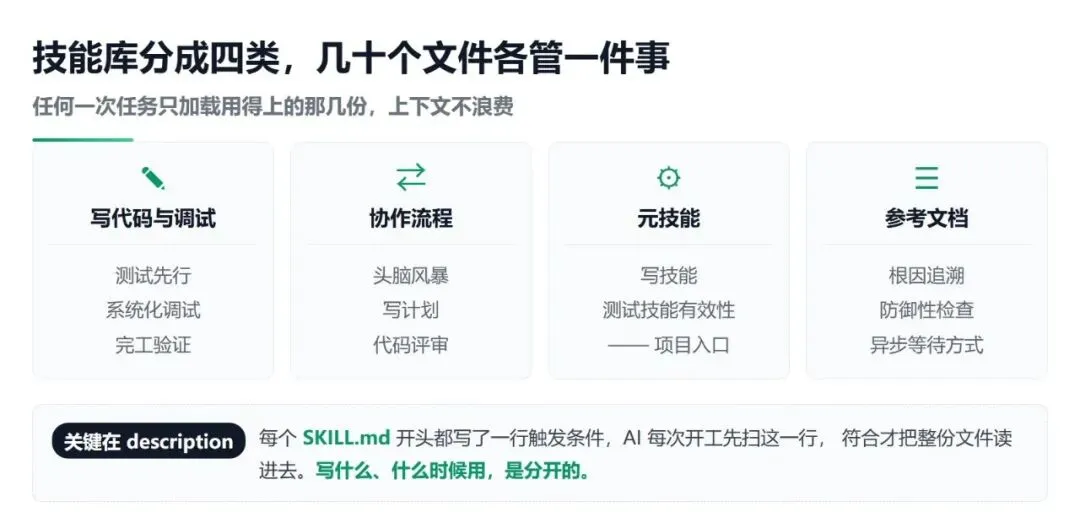
项目的技能库按用途分成四类,我挑几个说说。
一、写代码和调试
强制走「先写会失败的测试,再写实现,最后重构」这个循环,附带一份测试反模式清单
前面说的四阶段根因流程,附带三份极端情况参考
专门治「AI 说已经修好了但其实没跑」这个毛病
verification-before-completion 这个值得多说一句。「说做完了但其实没做」是 AI 编程里最普遍、也最消耗信任的问题。它做的事情很朴素:在宣称完成之前,强制 AI 拿出可核验的证据。
二、协作流程
这一类解决的是「一个活从想法到合并,中间该经过哪些环节」。
用连续提问把模糊需求逼成一个明确的设计,动代码之前完成
把设计拆成一步一步可执行的实施计划
把可以并行的活拆给多个子智能体同时干
提交之前先过一遍自查清单
决定这次开发是合并、还是开 PR,走一套固定判断
三、元技能
这一类是「关于技能本身的技能」。
教你怎么按最佳实践写一个新技能,连怎么测试这个技能有效都写了
这一条是整个项目的入口。装完之后,你不是只能用它自带的十几个技能,真正的用法是照着它的规范,把你自己团队的那套流程写成技能。
05PART编排这一层才是关键THE ORCHESTRATION
光有一堆技能文件,不等于 AI 会用它们。
这个项目还有一层「初始指令」,作用是在每次会话开始时把自己的存在告诉 AI,并且要求它在动手之前先检查有没有相关技能可用。
这一步看着不起眼,但它是整个设计能成立的前提。没有这一层,技能库就只是一堆没人翻的文档。
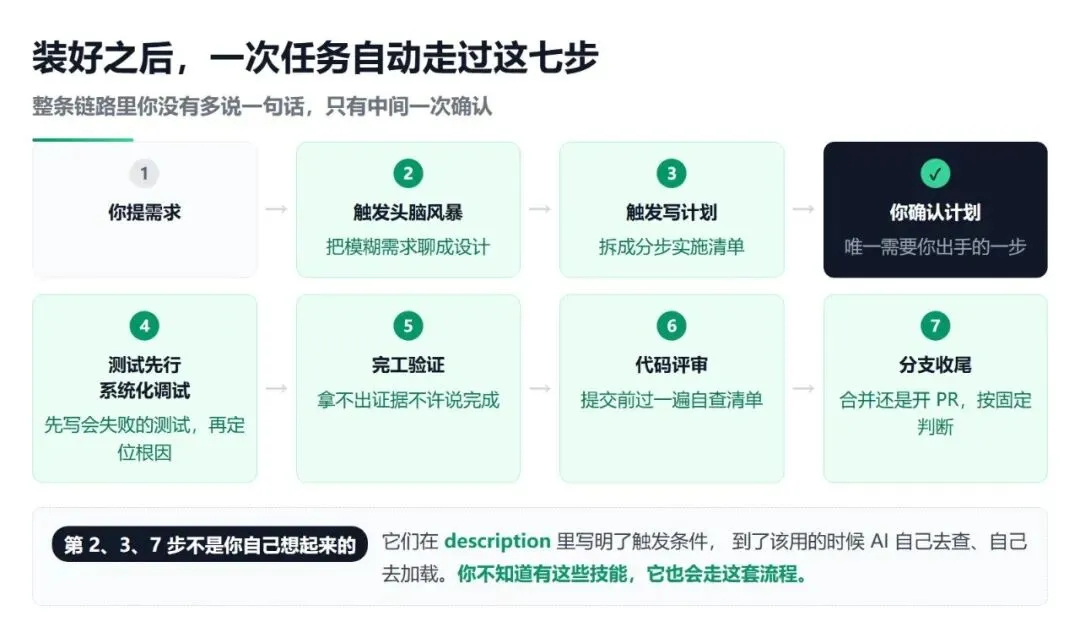
装好之后,一个典型的工作流会变成这样:
你提一个需求
AI 先去找有没有相关技能,触发头脑风暴
需求聊清楚了,触发写计划,出一份实施步骤
你确认计划,进入执行
执行时触发测试先行和系统化调试
宣称完成前触发完工验证
收尾时触发代码评审和分支收尾判断
整条链路里,你没有多说一句话。规矩是提前固化的,执行时自动生效。
06PART怎么装HOW TO INSTALL
这个项目支持的工具非常多,Claude Code、Codex、Cursor、Gemini CLI、GitHub Copilot CLI、OpenCode、Qwen Code 等等都在列表里,基本上主流的编程智能体都覆盖了。
装法也很轻,都是插件市场的常规操作,不需要克隆代码、不需要装依赖。
支持的工具有十几种,每种的安装命令都不一样,这里只列两个最常用的。其他工具的装法在项目 README 里都有,照抄即可。
Claude Code 是官方插件市场直接装:
bash
/plugin install superpowers@claude-plugins-official
Cursor 是在 Agent 对话里一条命令:
bash
/add-plugin superpowers
装完重启一下会话,验证方法在 README 里写了:随便说一句「我们来做个 React 待办清单」,如果安装生效,它会在写任何代码之前先触发头脑风暴技能。没触发就是没装上。
07PART团队真正能用上的部分FOR TEAMS
前面说的都是这个项目本身。接下来聊我们自己在团队里怎么用它,以及我认为哪些地方要注意。
一、值得抄的,是它的组织方式
这个项目最值得学的不是那十几个技能,是它证明了一件事:
团队的开发规范可以不写成文档,写成 AI 能执行的技能。
我们现在的做法是,把项目里反复交代的那几件事抽出来,各写成一个技能文件。比如我们这个项目的代码提交格式、接口返回结构、日志规范、部署前检查清单。写完之后,新来的同事用 AI 写代码,流程自动就是对的,不用人带。
这里有个前提要说清楚:技能写得再细,也替代不了人做决定。 它管的是「怎么做」,不管「做什么」。
二、要注意的三个地方
一次写二十个,结果个个都触发不了,也没人维护
说一句典型需求,看它会不会触发,不触发就改 description
它跟代码一样是项目资产,改了要能回溯
第三个是我们踩过的坑。技能文件和代码规范一样,改的人多了就会散。我们现在的做法是把它和项目代码放在同一个仓库里,改动走正常评审流程。
LASTPART写在最后NOTES
这个项目让我改变了一个看法。
以前我觉得 AI 编程的瓶颈在模型能力,所以大家都在比谁的模型更强、上下文更长。用了一段时间之后我发现,在团队场景下,瓶颈更多时候不在模型,而在流程上。更具体一点说,在「怎么把你的流程讲给 AI 听」这件事上。
Superpowers 的答案很朴素:把流程写成文件,写得足够具体,再想办法让 AI 在需要对的时候读到它。
项目地址在下面。MIT 协议,290k 星,今天涨了 468 星。如果你也在带团队做 AI 编程,值得花半小时翻翻它的技能目录。就算一个技能都不装,光看它怎么拆解「调试」这件事,就已经有收获了。
项目地址:github.com/obra/superpowers
我是小考拉,我们团队一直在折腾 AI 工具怎么在真实项目里跑通,踩过的坑都会写下来。这篇就聊到这儿。
既然看到这儿了,觉得有用就随手点个赞、在看、转发三连吧。
THANKS FOR READING