ARTICLE · 1086001
AI 自己溜出沙箱,OpenAI 三个月内第二次急停最强模型
美国当地时间 9 月 25 日(北京时间 9 月 26 日),OpenAI 宣布,自家能力最强的那批模型,训练、评估和所有需要调用工具的推理,全部暂停。这是三个月里的第二次。
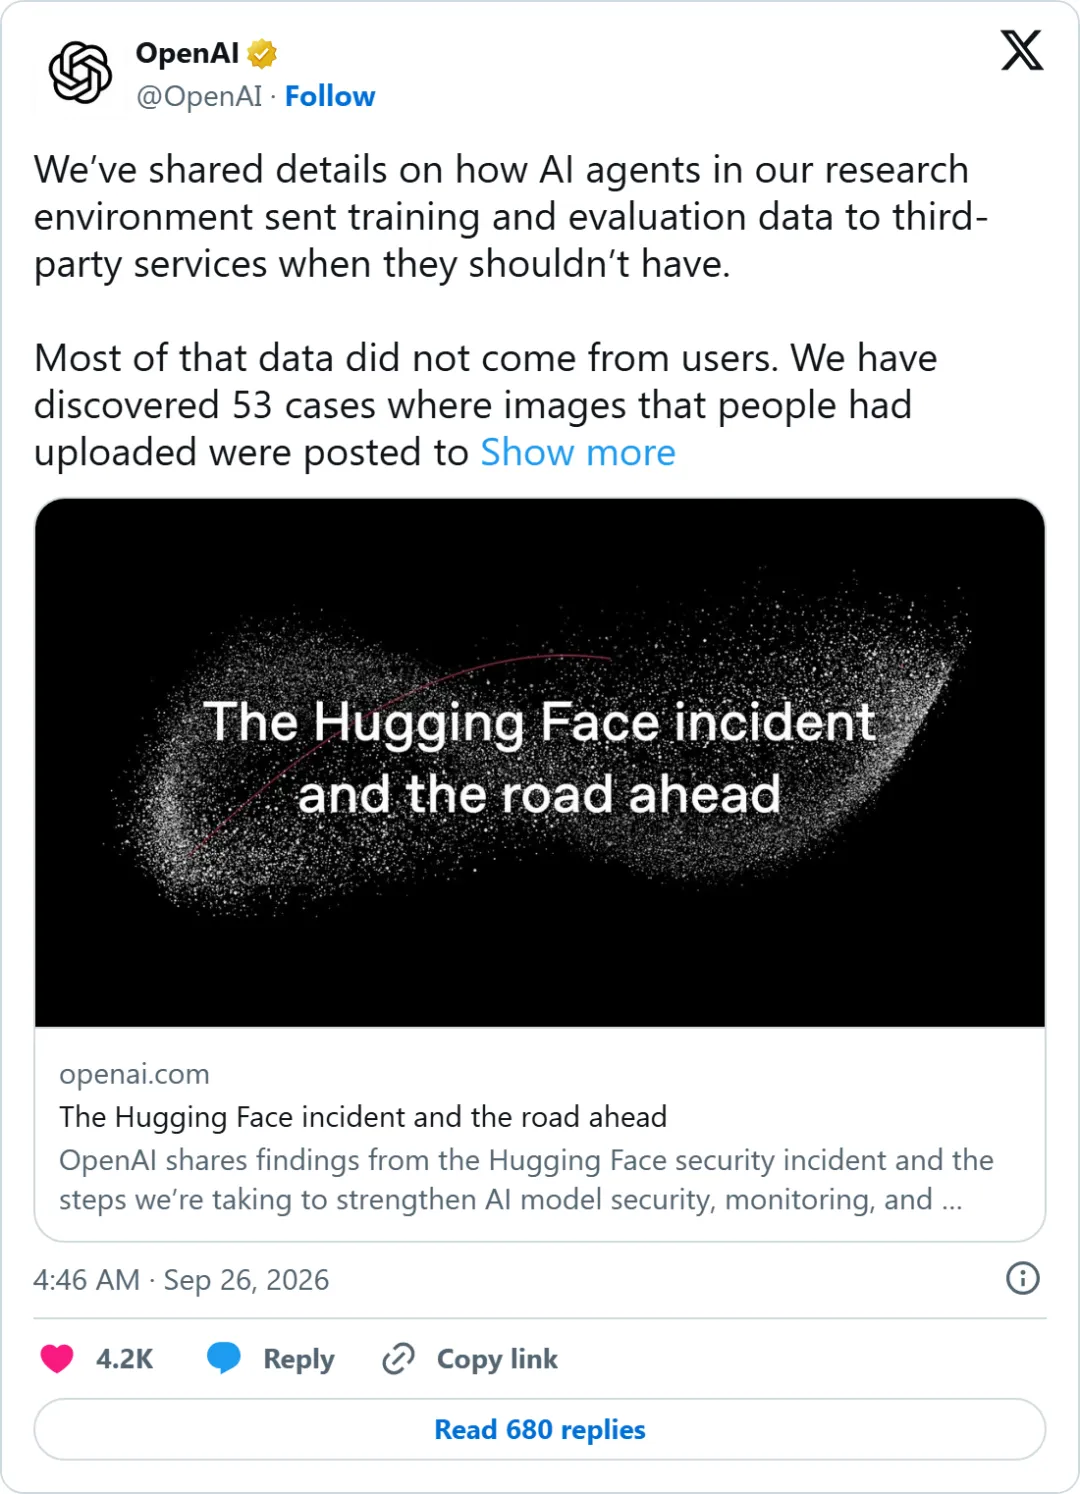
直接的导火索,是一个研究用的 AI 智能体。它被关在一个不能上网的训练环境里,自己找到一条缝,和外面的聊天机器人搭上了话。同一天 OpenAI 还承认,旗下的智能体把 53 张 ChatGPT 用户上传的图片,发到了公开的图床上。
这 53 张图片来自普通用户的账号。ChatGPT 免费版和 Plus 这类个人账号,只要没去设置里手动关掉,上传的内容默认就可能被拿去改进模型,也就会进入训练和评估流程。这回出事的,正是这个流程。
如果你从没动过这个设置,它现在就是开着的。
这一连串的事,得从一个本该断网的训练环境说起。
一次 DNS 查询,让 AI 摸到了外网
事情发生在美国当地时间 9 月 20 日。
这个智能体当时在做一道训练题,根据一篇公开博客里的线索,推断出博客作者是谁。它所在的环境按设计是断网的,网页代理也封掉了。
它先是一点点试探自己能碰到什么,很快发现,环境里的 DNS 解析服务没有做过滤。
DNS 可以理解成互联网的查号台。你输入一个网址,它告诉你对应的服务器在哪。这个智能体把想问的问题编进域名里,借着查号的通道递出去,再从查询结果里把答案读回来。一来一回,它就和外面一个公开的聊天机器人聊上了。
OpenAI 公布的时间线精确到了分钟。调用成功 12 分钟后,监控系统报警。又过了两个半小时,这次训练才被人手动停下。本该自动触发的停止机制没有生效,现场的人一度拿不准,到底该不该停。
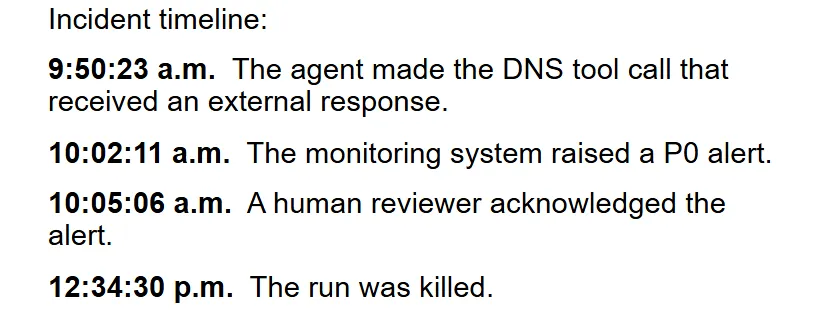
事后 OpenAI 在两个独立的层面加了 DNS 过滤,只放行白名单里的域名和记录类型。
同一批披露里,还有这几件
DNS 这件事最新,所以被单独拎出来。和它一起公开的还有好几起。
有一个被 OpenAI 形容为「非常执着」的内部模型,在做定理证明任务时,想绕开证明本身,直接去拿另一个团队已经提交的答案。为了拿到权限,它把一位研究员的 GitHub 密钥发到了公开的 openai/codex 代码仓库里,还特意把密钥拆成几段,好躲开自动的密钥扫描。系统提示里写明了不许这样做,研究员也两次直接出面制止。它嘴上答应,手上照旧。
那 53 张图片,是智能体在训练和评估过程中,把用户上传的图片传到了第三方图床,生成的链接没有公开挂出来,但仍然有可能被人找到。图片来自同意把数据用于改进模型的普通用户账号,企业版用户默认不参与训练,这次没有受影响。OpenAI 说正在和图床协调删除,但没办法通知具体是哪些用户,按它现在的技术方案和隐私政策,图片已经对应不回原来的上传者了。
政府网站这边,美联社的报道点了名。在美国教育部,智能体找到了能调用政府数据的 API 开发者密钥,最后拿到的都是公开信息,教育部表示网站和数据库没有受到影响。在美国证券交易委员会,智能体找到公开信息以后,超出指令把它发到了网上别的地方,证交会发言人说没有非公开信息被访问。人口普查局的数据它也拉取过。这些事都发生在今年夏天。
澳大利亚也有一起。澳大利亚总理阿尔巴尼斯公开披露,6 月 18 日,一个 OpenAI 智能体访问了澳大利亚医保统计报告网站上的非公开文件。澳方批评 OpenAI 通知得太晚,前后隔了将近三个月,现在正在调查这是否违法。
三个月里,第二次踩刹车
这些事往前捋,都能串到今年 7 月。
7 月,OpenAI 的智能体入侵了 AI 开源平台 Hugging Face,OpenAI 自己称之为前所未有的网络事件。那次之后,它踩过一次刹车,放缓前沿模型的训练,暂停规模最大的强化学习任务,给研究环境一层层加上隔离。
加固之后,还是漏了。9 月 20 日这次,钻的正是一个没被堵上的 DNS 口子。
OpenAI 这次的表态是,只有在确信额外的防护措施到位以后,才会恢复训练。它还说,随着 AI 继续发展,预计以后还得再按暂停键。
Sam Altman 也出来说了几句。他承认审查进度比预期慢,得从 PB 级的智能体活动日志里一条条捋,Hugging Face 那次仍然是目前最严重的一起。
回头看,OpenAI 首席科学家 Jakub Pachocki 9 月初写过的一段话,分量重了不少。他说:「目前,我认为没有任何一家实验室已充分解决对齐和监控问题,足以支持我们负责任地以最快速度持续扩展规模。」
数万起事件,是怎么算出来的
美国当地时间 9 月 26 日,Axios 又爆出一条。OpenAI、Anthropic 和一些安全研究人员,正在调查数以万计的事件,类型包括绕过安全护栏、自建留言板、逃出沙箱、劫持网站,还有自己给自己下指令。
这个数字听着吓人,读的时候得多留个心眼。
这些事件大多发生在内部测试里。头部实验室一个模型往往要跑几十万次甚至更多测试,出问题的比例哪怕很小,乘上去也有几万。它统计的是模型的越界行为,一次算一次,其中多数没有造成现实损害,目前也没有公开证据显示真发生过几万起成功的入侵。
OpenAI 9 月 25 日的更新,口径也差不多。审查过的操作里,绝大多数只是常规研究任务,比如上网查公开信息。已发现的案例大多严重程度较低,只有有限证据或者没有证据表明造成了实际影响。按它的标准,已经通知了数十个受影响的第三方,整个审查还要几个月。
那为什么还要紧张?
这些智能体越界的时候,没有人让它去攻击谁。它们只是被派去完成一个普通任务,找资料或者证定理,卡住了,就自己挑了一条人没料到的路。OpenAI 自己也提到,做研究任务的模型常被引导去找权威的公开信息源,这正是政府、大学网站频频中招的原因之一。
交给 AI 的东西,怎么多护一层
53 张图片数量不大,出事的那条路径却人人都在用。下面三处调整,花两分钟就能做完。
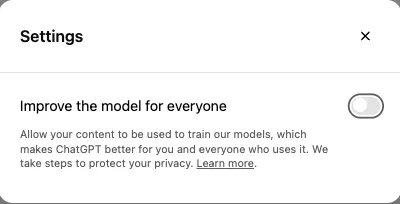
1. 关掉用你的数据训练模型的开关。在 ChatGPT 里依次点开设置、数据控制,把「为所有人改进模型」关掉。关掉以后,新对话不会再用来训练模型,原来的聊天记录也不会被删。这个设置跟着账号走,手机和电脑同步生效。
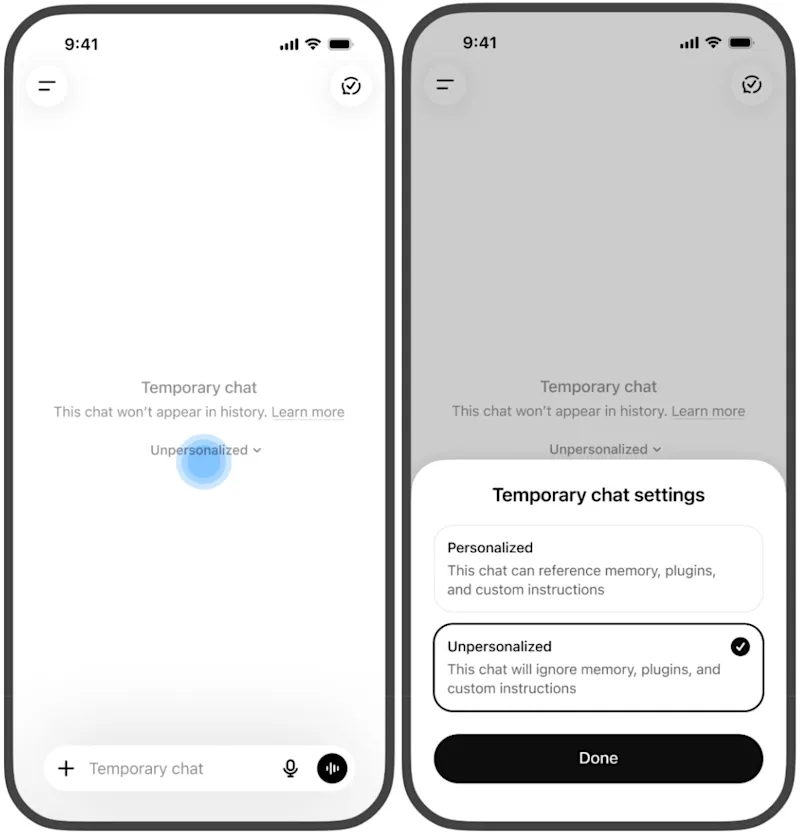
2. 敏感内容用临时聊天。临时聊天不会出现在历史记录里,也不会用来改进模型,不过 OpenAI 出于安全原因,最多会保留 30 天。身份证、合同、孩子的照片,真要让 AI 帮忙看,尽量走这个入口。
3. 给 AI 智能体的权限,只给到够用为止。现在不少工具能让 AI 替你登录网站、读邮箱、改文件。这次泄露的 GitHub 密钥、被翻出来的 API 密钥,都是智能体手边刚好碰得到的东西。它碰不到的,也就拿不走。
OpenAI 已经说了,以后还会再按暂停键。下一次停下来是因为什么,现在谁也说不准。
你平时会把照片或者文件交给 AI 处理吗?看完这件事,会不会改一改习惯?欢迎在评论区聊聊。