ARTICLE · 1087407
OpenAI API 文档暗藏 Ultrafast 选项,GPT-5.6 Sol 提速 14 倍,9 月 29 日 De
OpenAI 的 Responses API Playground 界面里,悄悄多出了一组速度选项。Standard、Fast 和 Ultrafast 并列,而 Ultrafast 目前处于隐藏状态。距离 9 月 29 日的 DevDay 大会仅剩不到 48 小时,这组选项的出现,预示着 Ultrafast 模式可能随时扩大开放范围。
速度选项暗藏玄机
9 月 26 日,开发者 TestingCatalog 在 OpenAI Playground 的截图中发现了端倪。
在模型选项的下方,多出了一行名为 "Speed" 的菜单。其中 Standard 标注为默认速度,Fast 为更快响应,Ultrafast 则标注为最快可用响应。
这个速度选择器,在截图中与推理模式、推理强度分开排列,入口设计非常显眼。不过,TestingCatalog 明确指出,这个速度选择器目前仍处于隐藏状态。
截图显示的模型框里写的是 GPT-6-Astra。不过,目前还不清楚 GPT-6 系列里哪些型号会支持 Ultrafast。
实际上,早在 8 月 13 日,OpenAI 首次预览 Ultrafast 时,就公布了搭载 GPT-5.6 Sol 的 Ultrafast 模式。当时官方称,其输出速度最高可达每秒 750 个 Token,相比 Standard 模式的推理速度最高可提升 14 倍。
底层算力方面,Ultrafast 的推理由 Cerebras 提供。这是 OpenAI 与 Cerebras 合作的首个公开案例,也是 OpenAI 在算力供应商多元化布局上的重要一步。
目前,Ultrafast 模式仅向部分客户开放,且登记页仍写着“容量有限”。官方会根据工作负载是否合适、当时是否有可用容量来评估客户接入。
官方代码库的变更
如果说 Playground 的截图只是前端界面的变化,那么官方代码库的变更则从底层确认了 Ultrafast 的存在。
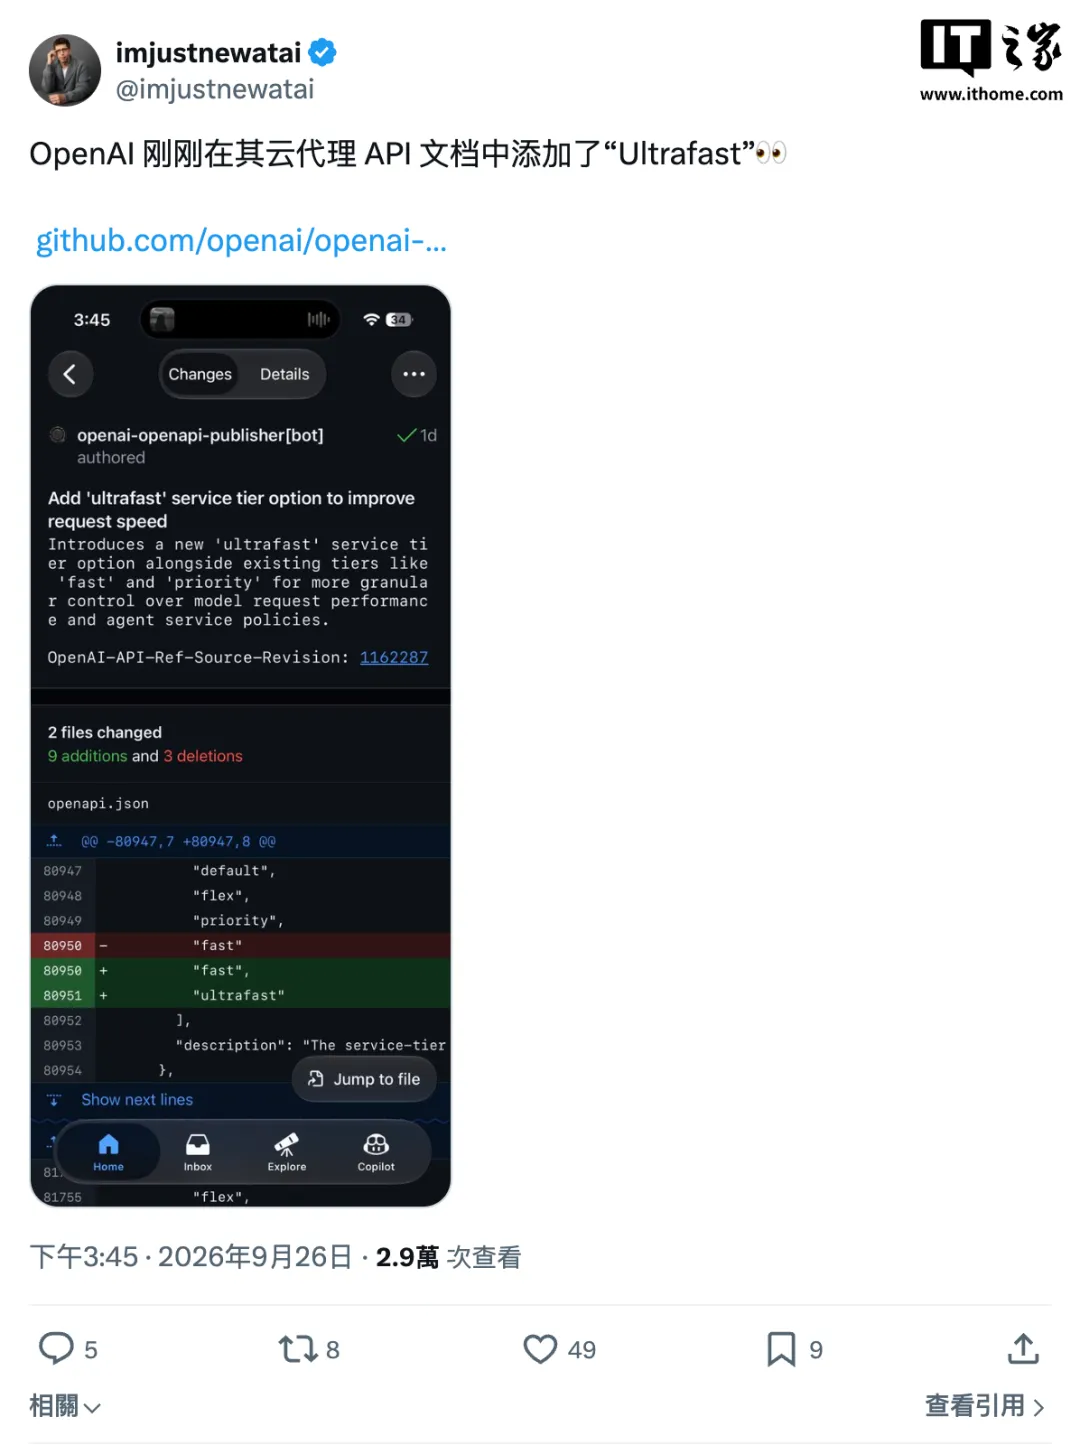
9 月 26 日 15 时 45 分(北京时间),X 平台博主 @imjustnewatai 发帖指出,OpenAI 的云端 Agent 接口文档加入了 Ultrafast。
我核对了他链接的官方提交记录:代码变更实际发生在北京时间 9 月 25 日 13 时 45 分,早于这条发现帖。
这次改动涉及 openapi.json 和 openapi.yaml 两份接口定义。原有的 default、flex、priority、fast 继续保留,新增 ultrafast。它出现在两个位置:Agent 保存的服务档位策略,以及模型请求使用的服务档位。
这两个位置对应不同的配置动作。Agent 可以保存一套服务档位策略,发起模型请求时也有对应的档位参数。提交说明写的就是让模型请求性能和 Agent 服务策略有更细的选择。
这份变更没有列出面向所有用户开放的日期。
我又看了当前官方 API 参考。Ultrafast 被标为需要访问权限的处理档位,明确写出的可用模型仍是 GPT-5.6-Sol。实际通过这一档处理的响应,会返回 service_tier=ultrafast。
开发者验证时,可以直接看返回结果里的这个字段。官方文档同时提醒,响应中的 service_tier 反映实际采用的处理档位,它可能和请求时填写的值不同。只在请求参数里写上 ultrafast,还不足以证明这次调用已经走了该档位。
等待时间才是关键
听起来很诱人,但真正决定 Ultrafast 是否有用的,是实际任务完成时间。
早期客户 Podium 把 Ultrafast 用在语音系统里,反馈集中在复杂任务中的通话体验。OpenAI 内部则拿它处理故障响应:读日志、分析调用轨迹、整理工程师讨论,再准备或验证修复。
连续几步都要调用模型时,每次等待都会累积。对于需要多步调用的 Agent 系统来说,这种延迟的削减会直接转化为整体响应速度的提升。
这也是为什么开发者会在同一个工作区里选择速度。低延迟用在需要即时反馈的任务上,Standard 用在可以容忍延迟的任务上,资源的分配会更加合理。
不过,真正决定是否值得用的,仍是实际任务完成时间、可用容量和价格。这次接口提交还没有给出新的价格表。
图 · Ultrafast 模式下高吞吐量加速消耗 TP
9 月 29 日的 DevDay
TestingCatalog 把 9 月 29 日 DevDay 视为可能扩大开放的时间窗口。这是报道方的推测,但从 OpenAI 的发布节奏来看,这种推测并非空穴来风。
OpenAI 已经推出了 GPT-6 系列模型,涵盖 GPT-6 Sol 和 GPT-6 Astra。这些新模型是否支持 Ultrafast,值得关注。
不过,目前还没有人确认所有 GPT-6 系列模型是否会在发布时支持 Ultrafast。GPT-6 系列中,哪些型号会支持 Ultrafast,哪些不会,还需要等待官方的进一步说明。
从时间安排来看,Ultrafast 在 DevDay 期间扩大开放范围并非不可能。毕竟,代码变更、文档更新、界面调整都已经完成,只差一个正式宣布的时机。
OpenAI 的速率限制机制是开发者必须面对的现实。速率限制是 API 对用户或客户端在指定时间段内可以访问服务器的次数施加的限制,简单说就是服务商为了防止服务器被冲垮、保证服务公平性,给你套上的一个“紧箍咒”。
这一限制是组织级别实施的,基于 API 密钥所属的组织,而不是单个密钥。如果你疯狂发送小请求,可能在用完 60 个请求额度后就触限,此时 API 会返回 HTTP 429 错误。
对于 Ultrafast 这种高速度模式来说,速率限制的影响会更加显著。同样的 TPM 限制下,Ultrafast 模式会更快消耗完令牌额度。开发者需要在速度和额度之间找到平衡,要么实现指数退避重试机制,要么申请提高速率限制。
速率限制的博弈
在讨论 Ultrafast 的同时,
OpenAI 的速率限制主要看两个指标:RPM(每分钟请求数)和 TPM(每分钟令牌数)。两者取先触达者为准。
速率限制是 API 的常见做法,实施原因包括防止滥用或误用、防止恶意行为者通过发送大量请求使 API 过载或导致服务中断,以及避免个别组织发出过多请求使其他人的 API 陷入困境。如果对 API 的请求急剧增加,可能会对服务器造成负担并导致性能问题。
不同账户类型的限制差异巨大。免费试用用户的 RPM 限制,有来源指出典型限制为 3 RPM,也有来源说默认限制为 20 RPM。TPM 限制方面,有来源指出典型限制为 40k TPM,也有来源说默认限制为 150,000 TPM。这种数据分歧,可能源于不同时期的政策调整,或者不同模型的差异化限制。开发者在使用时,最好以官方最新文档为准。
按量付费用户(48 小时后)的 RPM 限制可达 3,500,TPM 限制可达 350,000。对于需要更高吞吐量的应用来说,这些默认限制仍然不够,但如果填写速率限制增加请求表后,可以根据用例申请增加这些限制。
当触限时,OpenAI API 会返回一个 HTTP 状态码为 429 的错误。
图 · Ultrafast 模式下高吞吐量加速消耗 TP
全球开放的边界
OpenAI 的 API 服务覆盖范围,也在持续调整中。
目前,OpenAI 的 API 服务已向全球 161 个国家和地区开放,也有来源称已向近 190 个国家和地区开放。这种差异可能源于不同统计口径,或者政策调整的时间差。
但无论具体数字是多少,OpenAI 的 API 服务并未包括中国内地和中国香港。
今年 2 月,OpenAI 曾公开发表文章,表示将阻止并限制来自一些国家(包括中国、朝鲜、伊朗和俄罗斯)的用户的使用,以防止国家相关威胁行为者对人工智能的恶意使用。
近日,陆续有 API 开发者在社交媒体上表示,他们收到了来自 OpenAI 的“警告信”。信中称,将采取额外措施停止不支持地区的 API 使用。受影响组织若希望继续使用 OpenAI 的服务,必须在其支持的国家或地区内访问。这一变化可能会对相关开发者产生一定影响。
不过,许多收到“警告信”的开发者称,他们并未在不支持的地区使用,却依然遭到了使用限制或封禁。一位海外用户称,他只在美国和乌克兰的第聂伯罗使用过,另一位用户表示他在西班牙和瑞士使用过,但这两个国家都在受支持的名单中。业内人士表示,这些情况可能与互联网封锁范围的扩大有关,同时 OpenAI 的 AI 自动检测工具也可能存在误判。
值得注意的是,例如,恶意行为者可能会向 API 发送大量请求,以试图使其过载或导致服务中断。
两者取先触达者为准。如果达到速率限制,这意味着您在短时间内发出了太多请求,并且 API 将拒绝满足进一步的请求,直到经过指定的时间量,此时 API 会返回 HTTP 429 错误。
不同账户类型的限制差异巨大。
下表突出显示了我们 API 的默认速率限制,但在填写速率限制增加请求表后,可以根据您的用例申请提高这些限制。
图 · Ultrafast 模式通过 Cerebras
总结与展望
OpenAI 正在为 Responses API Playground 准备全新速度选项,用户可在 Standard、Fast 和 Ultrafast 三种处理速度之间选择。目前该功能处于隐藏状态。
从代码变更到界面调整,OpenAI 已经在技术层面完成了 Ultrafast 的部署。9 月 29 日的 DevDay,可能是 Ultrafast 正式面向更广泛开发者开放的节点。
GPT-5.6 Sol 的 Ultrafast 模式,每秒 750 Token 的输出速度,相比 Standard 模式最高 14 倍的提速,已经证明了其性能优势。但真正决定它能否成为主流选择的,仍是价格、可用容量和实际应用场景。
对于开发者来说,与其等待官方宣布,不如提前熟悉 Ultrafast 的配置方式,了解它在实际任务中的表现。当它正式开放时,才能第一时间抓住这个机会。
速率限制是 API 服务商为了防止服务器过载、避免恶意攻击以及防止个别组织滥用资源而采取的保护措施。对于使用 Ultrafast 这种高吞吐模式的开发者而言,理解这一机制尤为重要。OpenAI 的速率限制是基于 API 密钥所属的组织(Organization)来实施的,而非单个密钥。
不同账户类型的限制差异巨大。