ARTICLE · 1098778
昇腾环境私有化文档解析:把OCR 关进内网,再配一套真正能用的前端
昇腾环境私有化文档解析:把Paddle-OCR-VL 关进内网,再配一套真正能用的前端
① 昇腾算力的妙用 —— 国产算力除了跑语言模型,还能转化成实用的生产力工具② 资料不出内网 —— 文档识别全链路内网闭环,从"不能做"变成"可以做"③ 前端完整易用 —— 后端服务化只是及格线,让不会写代码的同事用起来才算交付
阅读建议:先看这套系统现在能做什么(第一章),再看它是怎么搭出来的(第二章起);文末附三段可直接复制的部署命令、三条硬结论、一张八连坑速查表。
一、先看效果:这套系统现在能做什么
1.1 一句话说清能力
输入 PDF 或图片,输出结构化 Markdown——全流程在自有昇腾服务器上完成,不经过任何公网服务。
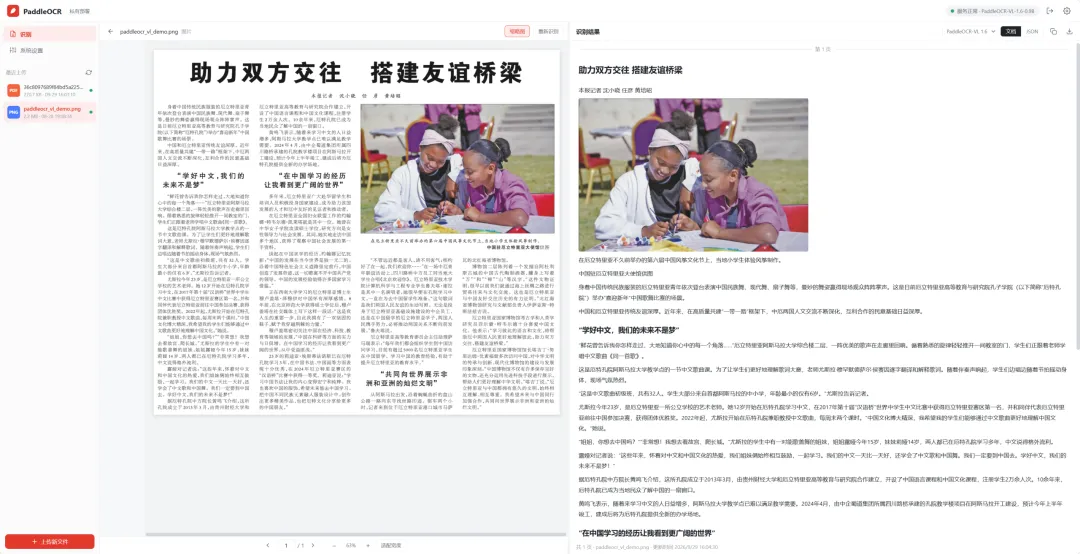
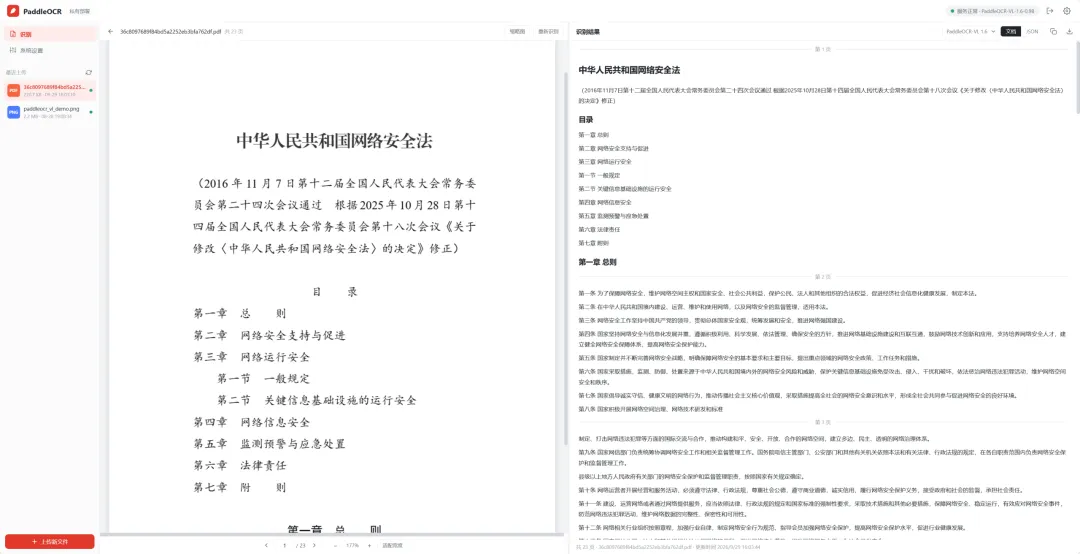
输入: .jpg .jpeg .png .bmp .tiff .tif .pdf,单文件上限 800MB输出:逐页 Markdown(保留标题层级、表格结构、图片引用)+ 原始 JSON 结构 接口:4 个 HTTP 端点,同步 / 异步双通道
/ocr/predict | ||
/ocr/predict/async | task_id + 查询地址 | |
/ocr/task/{id} | running 带 n/m 进度 / done / failed) | |
/health |
异步通道不是可选项——冷启动首个请求要 44.6 秒,大文件必须走异步接口。
1.2 实测性能
temperature=0.0 |
"可复现"这一条比"快"更重要。同一页文档重复请求,Markdown 字符数完全一致(2696 = 2696)——文档解析业务里,今天和明天解析同一份文档必须得到同样的结果,否则下游比对、归档、审计全都不可靠。
1.3 界面:不写代码的同事也能用
服务化之后最容易忽略的一步:交付物如果只是一个接口加一份文档,实际结果往往就是没人用。
所以我们配了一套完整界面(详见第四章):左边逐页渲染 PDF,右边实时出 Markdown;拖进去就开始识别;结果能打包成 zip 导出(含图片);20 多项识别参数全在界面上可调。
1.4 质量:26 个用例,两轮 26/26
服务能跑通只是起点。真正的信心来自"每个配置项都被验证过"。
按官方网页版的能力清单设计了26 个用例 / 10 个分组,覆盖基线识别、功能开关、版面几何形状、prompt 类型、采样参数、辅助内容过滤、PDF 后处理、异步链路、参数校验、远程拉图。
首轮 20 通过 / 6 失败 → 第二轮 26/26 全部通过,零失败。
那 6 个失败反而是最有价值的部分——不是"没测过",而是"测出来了、定位了、修掉了":3 例是服务端参数名未做归一化(已修);2 例是上游库的设计限制(转化为启动级开关 + 干净的 400 守卫);1 例是测试样本 URL 本身 404(改用自建 HTTP 服务复测通过,跨网拉图结果与上传方式完全一致)。
一个细节:第二轮复测是在"服务器替换脚本并重启"之后跑的,先用
/health确认新版生效,再执行用例——避免"测了半天发现跑的是旧进程"。
二、怎么搭出来的:双容器架构 + 三条硬结论
2.1 架构:一张卡管版式,一张卡管识别
数据流:客户端 → 版面检测切块(卡 5)→ 逐块送 VLM 识别(卡 4)→ 拼装 Markdown 返回
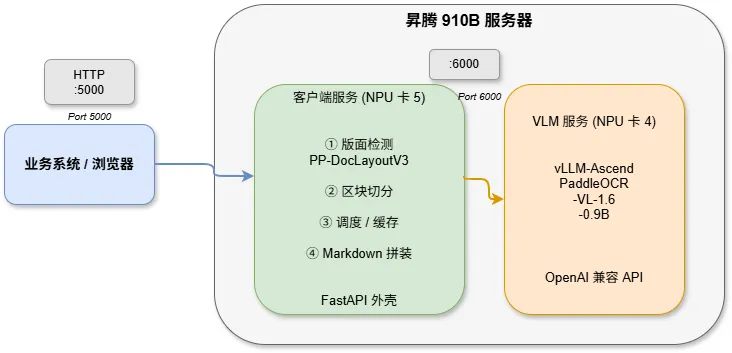
分卡不是浪费,是收益:轻量的版面检测占一张卡,重量级的 VLM 推理占一张卡,两类任务互不争抢,比挤在一张卡上更稳。同时在昇腾上"少占一张卡"本身就是稀缺资源的节约——剩下几张卡还能跑别的业务。
2.2 为什么必须是两个服务
翻官方昇腾部署文档时,启动方式表里有两行值得注意:
vllm serve) | |
genai_server |
一句话概括:"不支持"针对的是一个子路径,而官方在同一页就给了出路;"未验证"针对的是另一条——不是"不行",是"没人验证过"。路指了,但坑有多少,文档不会告诉你。
结论一:昇腾上「单容器进程内推理」不可行,且是框架层缺陷。
最省事的架构是一个容器装好环境、代码里直接 PaddleOCRVL(...) 推理。实测在昇腾上启动必崩:
RuntimeError: (NotFound) The kernel with key (CPU, Undefined(AnyLayout), uint8)of kernel `view_dtype` is not registered.根因是昇腾 paddle-custom-npu 构建下,safetensors 权重在 CPU 上做切分时张量 layout 变成了 AnyLayout,而 view_dtype 算子只注册了STRIDEDkernel——paddle NPU 运行时层的问题,与 paddlex 版本无关。三重佐证:官方 issue #16990 报过同款报错、因长期无响应被 stale 关闭(至今无修复);最新官方镜像上仍能复现(排除"版本太旧");官方文档第 2 节原文写着"当前硬件暂不支持'本地直接推理'路径"。
可抄结论:昇腾部署 PaddleOCR-VL,必须走独立 VLM 推理服务。 我们为此消耗了一个完整验证周期,你可以直接跳过。
结论二:官方标注"未验证"的裸vllm serve路径,实测可用且稳定。
官方推荐 paddleocr-genai-vllm-server 镜像 + paddleocr genai_server,把原生 vllm serve 标为"未验证"。我们在 910B 上实测:vllm-ascend容器直接vllm serve加载权重,服务稳定、可长期运行、输出满足业务。后续想切到官方推荐路径,只改一个VL_SERVER_URL,客户端代码零改动。
2.3 踩坑速查表
部署过程真实撞到的坑。收藏这张表比收藏文档更实用。
PreconditionNotMetError: The meta data must be valid + pd_kernel.phi_kernel | |||
docker run -d ... /bin/bashis not running) | -d | sleep infinity 保活 | |
LAYOUT_MODEL_DIR 漏带 | |||
AttributeError | paddle.version.to_str | paddle.__version__ | |
http://0.0.0.0:5000/...,客户端连不上 | 0.0.0.0 | ||
rectangle/quadrilateral/polygon 报 500 | rect/quad/poly/auto |
第 7、8 条暴露的是上游库的可用性缺口(参数校验失败不中断、文档用词与代码实现不一致)。在服务层把它们堵住,比让每个调用方各踩一遍更划算。
三、资料不出内网:不是"更安全一点",而是"才可以做"
3.1 云端方案在第一步就走不通
需求本身很朴素:几百页 PDF 要转成结构化 Markdown,让内容可检索、可比对、可二次加工。
标准做法早就有了:调用云端 OCR 服务,传上去,等结果,拿回来。
但我们的文档本身就是资产:合同、方案、汇报材料、内部出版物。把它们上传到公网服务的那一刻,合规上就已经输了。
不是"不太安全",是根本不能这么做。这一条没有商量余地。
3.2 全链路内网闭环,逐段可核
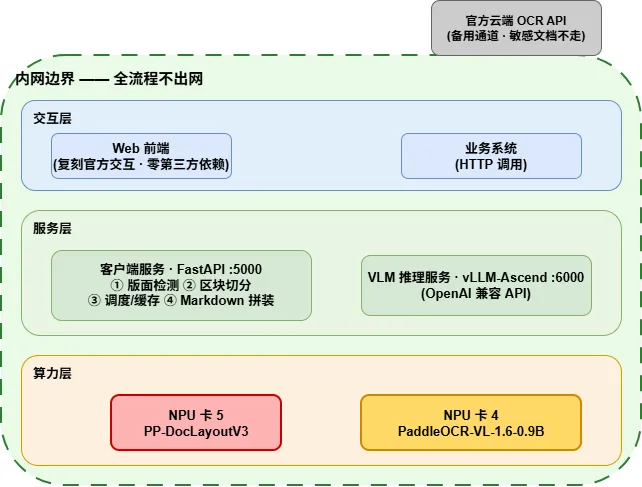
私有化最容易犯的错是"主流程内网、边角漏出去"。这个系统的每个环节都在内网:
模型权重走本地目录这一点尤其重要:用 LAYOUT_MODEL_DIR 指向本地路径,避免服务启动时从模型仓库下载——离线环境下这就是能不能启动的区别。
**【配图 7 · 全链路不出网】**六环节闭环图,每个环节打一个"不出网"标记(或画一道内网边界墙 + 一个"公网"在外面被挡住)。
3.3 成本账:边际成本趋零
算力是已有的空闲卡。服务上线后,每天的解析量不再产生任何对外计费。
这笔账很简单:文档越多的团队,自建相对按量的优势越明显。而且不用为"这个月文档突然多了"担心预算——机器的成本是固定的,用量不是。
3.4 可控性:出问题能自己查,升级不用推翻重来
可诊断: /health接口回显当前生效的全部配置——用了哪个版面模型、VLM 是否连通、预处理子管线是否构建,一眼可见。这个设计在排查"参数到底有没有传下去"时省了大量时间。可升级:官方后续推出更完整的 genai_server路径时,客户端代码零改动,只改一个地址。今天的自建不会变成明天的包袱。可回滚:接口契约与原版兼容,服务脚本可直接替换。
四、前端完整易用:让不会写代码的同事也能用
4.1 先承认一个现实:后端服务化只是及格线
服务跑起来之后,新问题来了:业务同事不会写 curl。
如果交付物是一个 HTTP 接口和一份文档,那么实际结果就是——没人用。所以"能不能出结果"和"有没有人用",中间隔着一整套前端。
我们的做法是:照着官方网页版的样子做交互,后端指向内网服务。熟悉官方界面的同事,上手成本接近零。
4.2 功能盘点:四块能力,一个不少
① 文档浏览区
PDF 逐页渲染(pdf.js),图片格式(png/jpg/bmp/tiff)同样支持 缩略图条:快速跳页 翻页:上一页/下一页按钮 + 页码直接输入跳转 缩放:按钮缩放、 Ctrl + 滚轮连续缩放、一键"适配宽度"中间与右侧之间是可拖动分割线,比例自动记忆,双击恢复默认
② 识别结果区
文档视图 / JSON 视图双切换:给业务看 Markdown,给开发看原始结构 页码分隔条点击 → 中间文档区自动跳到对应页 一键复制当前页 Markdown 识别进度条实时显示 n/N,且可中途"取消查询"
③ 导出(这是最容易被低估的一块)
当前页 zip:当前页 Markdown + 该页嵌入图片,一起打包 整篇 zip:全文 Markdown + 全部图片 结果 JSON:原始结构,便于二次开发
导出这块有个细节值得一提:跨页重名的图片会自动加页前缀消解(如 p2_img1.png),并且 Markdown 正文里的图片引用会同步改写——保证导出的 zip 解压后,Markdown 打开就能看到图,不会出现一堆裂图。
④ 系统设置:20 项参数全部可调
不只是"能跑",而是把官方网页版的能力完整搬过来:
参数保存在浏览器本地,对新提交的识别任务生效,不需要重启任何服务。
4.3 易用性细节:真正的"好用"藏在这些地方
功能列表谁都能列,区别在于细节有没有想清楚:
拖拽即用:把 PDF 拖进页面就开始识别,不用先点"上传"再"提交"; 上传后自动提交异步识别:不用手动点"开始",轮询进度、完成后自动渲染; 大文档不阻塞浏览:识别过程中可以正常翻页、缩放、看其他文件; 识别结果双重缓存:服务端缓存 72 小时,本地页面另存一份——重开文件不重复推理,服务重启也不丢; 状态可视:顶栏有后端连通性指示灯(绿点/红点),服务不通时立刻可见,不用等上传失败才知道; 失败原因:参数用错时返回明确的 400 提示(例如"需要以 VL_ENABLE_DOC_ORIENTATION=1重启服务后才可用"),而不是甩一个 500 堆栈; 一键重新识别:参数改完想重跑,不用重新上传文件。
其中第 6 条是我们特意做的:界面上默认置灰"方向矫正/扭曲矫正"两个开关——因为服务端默认没启用这两个预处理子管线,置灰 + 提示,比让用户点了报错再回来问要好得多。
4.4 两个工程细节:为什么这套前端能"发得出去"
① 纯 Python 标准库,零第三方依赖
页面后端(server.py)只有 Python 标准库,不依赖 Flask/FastAPI/requests 任何一个包。它负责三件事:托管静态页面、身份验证、把 /api/* 反向代理到内网 OCR 服务。
这在企业内网分发时是决定性的优势——不用为了跑一个界面去配 pip 源、装依赖、解代理。同事只需要 Python 3.8+,双击一个启动脚本就能用。
② 前端依赖全部本地化,包括最容易漏的那部分
pdf.js、Markdown 渲染、防注入、ZIP 打包,全部放在本地 vendor/ 目录,不引用任何 CDN——内网环境本来也访问不了公网 CDN。
这里有个几乎必踩的坑:pdf.js 必须配 CMap 与标准字体。缺了 cmaps/(169 个文件)和 standard_fonts/(16 个文件),包含 CID 中文字体的页面会整页空白——不是乱码,是纯白,极其容易被误判成"渲染坏了"或"文件有问题"。我们把这两份资源一并本地化,问题消失。
4.5 双后端热切换:一套界面,两种后端
前端支持在设置里切换后端类型:
私有部署(默认):指向内网昇腾服务,识别参数全量可用; 官方 API(可切):指向 PaddleOCR 云端服务,参数自动裁剪为官方支持的范围。
切换即时生效,不用重启。适配层会把两种后端返回的不同协议,转换成同一套前端数据格式——这意味着换后端不用改前端。
这个设计带来两个实际好处:一是能做 A/B 对比(同一份文档分别走内网和云端,看效果差异);二是留了一条备用通道(内网服务维护时,临时切云端不至于停工)。当然,涉及敏感文档时只会走私有部署——这条边界由使用者自己把握,但至少工具给了选择。
五、部署实操:三段可直接复制的命令
以下是实际部署用的命令(路径与卡号已按本机环境脱敏,替换成你自己的即可)。
① VLM 推理服务(占一张卡)
拉镜像:
docker pull quay.io/ascend/vllm-ascend:v0.18.0创建容器(注意 --net=host + 绑定 NPU 设备):
docker run -d -it \--name vllm-ascend-PaddleOCR-VL-1.6 \--shm-size=4g \--net=host \--device /dev/davinci4 \--device /dev/davinci_manager \--device /dev/devmm_svm \--device /dev/hisi_hdc \-v /home/<user>:/home \-v /usr/local/dcmi:/usr/local/dcmi \-v /usr/local/Ascend/driver/tools/hccn_tool:/usr/local/Ascend/driver/tools/hccn_tool \-v /usr/local/bin/npu-smi:/usr/local/bin/npu-smi \-v /usr/local/Ascend/driver/lib64/:/usr/local/Ascend/driver/lib64/ \-v /usr/local/Ascend/driver/version.info:/usr/local/Ascend/driver/version.info \-v /etc/ascend_install.info:/etc/ascend_install.info \-v /root/.cache:/root/.cache \-it quay.io/ascend/vllm-ascend:v0.18.0 /bin/bash
启动脚本 run_PaddleOCR-VL-1.6.sh(放在容器内 /home/ 下):
#!/bin/shset -e# 仅保留昇腾 NPU 内存动态分配有效配置export PYTORCH_NPU_ALLOC_CONF="expandable_segments:True"# 离线本地模型路径export MODEL_PATH="/home/PaddleOCR-VL-1.6"# 校验模型目录存在if [ ! -d "${MODEL_PATH}" ]; thenecho "错误:模型路径 ${MODEL_PATH} 不存在,请检查权重挂载"exit 1fi# 启动 vLLM-Ascend PaddleOCR-VL 昇腾推理服务vllm serve ${MODEL_PATH} \--tensor-parallel-size 1 \--host 0.0.0.0 \--port 6000 \--max-num-batched-tokens 16384 \--served-model-name PaddleOCR-VL-1.6-0.9B \--trust-remote-code \--mm-processor-cache-gb 2 \--gpu-memory-utilization 0.85 \--max-num-seqs 256 \--limit-mm-per-prompt '{"image": 10}' \--additional_config '{"enable_cpu_binding":false}'
后台拉起:
cd /home/nohup sh run_PaddleOCR-VL-1.6.sh > PaddleOCR-VL-1.6.log 2>&1 &
② 客户端服务(占另一张卡)
docker run -d --name paddle-npu-dev \--user root --privileged --network=host --shm-size=128G -w=/work \-v /home/<user>/data:/work \-v /usr/local/Ascend/driver:/usr/local/Ascend/driver \-v /usr/local/bin/npu-smi:/usr/local/bin/npu-smi \-v /usr/local/dcmi:/usr/local/dcmi \-e ASCEND_RT_VISIBLE_DEVICES="5" \ccr-2vdh3abv-pub.cnc.bj.baidubce.com/paddlepaddle/paddleocr-vl:latest-huawei-npu \sleep infinity
进容器补依赖、清掉残留进程:
docker exec -it paddle-npu-dev /bin/bashpip install python-multipartpkill -f ocr_vl_api.py 2>/dev/null; sleep 2
启动服务——注意必须带上LAYOUT_MODEL_DIR:
cd /workLAYOUT_MODEL_DIR=/work/models/PP-DocLayoutV3 nohup python ocr_vl_api.py > ocr_vl_api.log 2>&1 &
三个最容易漏的点(都是我们实际踩过的):①
-d后台模式必须用sleep infinity保活——写/bin/bash会因为没有 TTY 秒退;②LAYOUT_MODEL_DIR必须带——否则会触发联网下载模型,离线环境直接起不来;③--served-model-name必须与客户端请求的模型名一致——对不上会拿到 404。
六、诚实的遗留项
不藏问题,这些也写在部署文档里:
VLM 框架版本偏低(vLLM-Ascend v0.18.0,官方验证版本为 v0.21.0rc1)。当前输出满足业务,升级后精度可能仍有提升空间,属"待评估的优化项"; 与云端 API 的精度 A/B 对比未跑:对比脚本已备好,随时可执行; 方向矫正 / 扭曲矫正默认关闭:启用会带来额外显存占用与每页额外预处理,单卡场景按需开启; 带真实密码的 PDF 无法解析(空密码加密 PDF 正常),属上游限制; 服务定位内网工具级,未做强化鉴权。若需暴露到不可信网络,应前置反向代理做 HTTPS 与强鉴权。
结语
三个角度,三句话:
算力——国产卡不是"能跑就行"。官方标"不支持"的那条子路径,我们验证了确实走不通;官方标"未验证"的那条,我们验证了能用。为此花的功夫,换来的是三条能直接抄的结论和一张八连坑表。
合规——资料不出内网不是加分项,而是这个项目能不能立项的前提。全链路闭环、模型权重本地化、结果本地缓存,每一段都要能核。
体验——后端服务化只是及格线。一套对齐官方体验、零依赖、开箱即用的前端,决定了同事会不会真的用它。
本文涉及的架构、指标与踩坑记录均来自实际部署过程。文中已脱敏的内容包括:服务器内网地址与主机名、登录账号与口令、云端 API 凭证、本机用户目录名,以及真实测试文档的名称与内容。命令中出现的镜像地址、端口、卡号与设备路径属公开或通用信息,可原样参考。
如需前后端代码,请私信博主