ARTICLE · 1108936
AI 赋能自由形态超表面逆向设计提速25万倍
AI 赋能自由形态超表面逆向设计提速25万倍本文由作者团队投稿
如果要让一束光会聚成很小的焦点,或变成具有特殊形状的光束,传统光学往往需要安排不同的透镜与调制器。超表面提供了另一种可能:在一片薄薄的材料上布置大量纳米结构,让光穿过时就获得所需变化。不过,功能越丰富,结构设计也越复杂。每个位置放什么、相邻结构怎样配合,都需要计算检验。若一次修改就要等待很久,再好的优化思路也难以充分尝试。让逆向设计变快,意味着复杂器件的更多候选方案能够真正进入比较与优化。 近日,西安交通大学雷铭、梁言生教授团队联合南京大学、香港科技大学等单位提出了基于邻域注意力 Transformer 与迁移学习的大规模自由形超表面快速逆向设计框架MetaE-former。共同第一作者为西安交通大学硕士、本科毕业生匡仕琦、孙智,西安交通大学雷铭、梁言生教授,南京大学王漱明教授、香港科技大学李添悦研究员为共同通讯作者,文章在线发表在光学旗舰刊物PhotoniX上。 研究中的 AI 模型学习的是纳米结构与光场之间的关系。结构改变后,模型能够快速预测光将如何响应,并帮助程序决定下一步怎样修改。研究团队进一步把计算方案做成了真实超透镜,展示了这一路径从模型预测到器件实验的可行性。 从想要什么光到应该制造什么结构 假设目标是让平面入射光在指定位置形成焦点。首先可以计算理想情况下,各处透射光应该具有什么相位。接下来的难题是找到能产生这些相位关系的纳米结构,而且当它们放在一起时,整体光场还应符合预期。 一种常用方法是先做“结构字典”:计算若干圆柱或其他规则结构的响应,再按目标相位从字典里选择。自由形逆向设计则允许结构在更丰富的图案空间里变化,程序根据实际光场与目标之间的差异持续修改。这为高性能器件提供了更多可能,也使电磁计算成为反复出现的耗时步骤。 图中的MetaE-former 就承担快速预测任务。它读取结构的折射率分布,输出相应电场,再让优化程序根据误差更新结构。整个过程仍然需要迭代,但训练后的网络能较快地完成每次预测,并提供结构调整所需的梯度信息。 这也解释了快速逆向设计为何重要:速度提高后,研究者可以更充分地利用自由形结构,而不必总因计算代价压缩参数数量或减少尝试。对于尺寸更大、相位变化更剧烈的器件,这种能力尤其有价值。 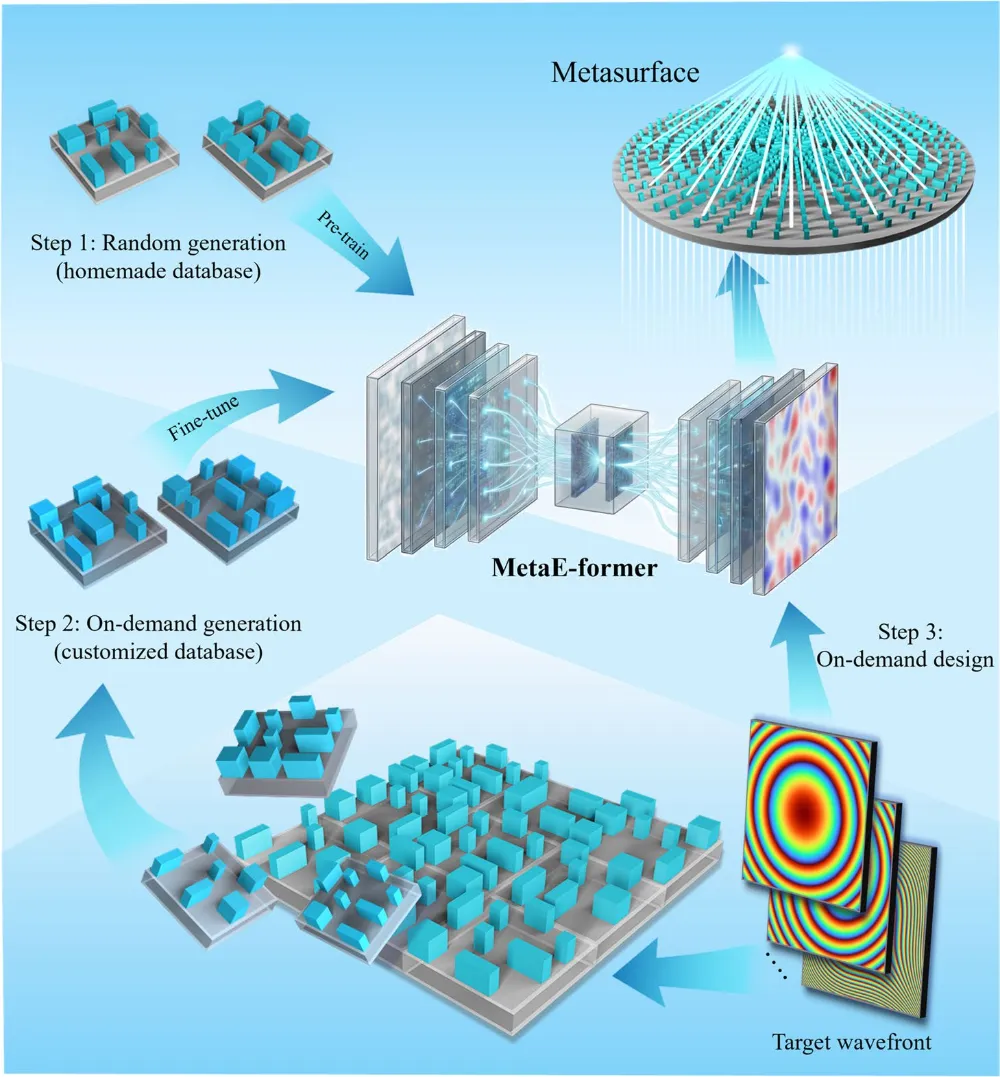
图1 AI如何参与超表面设计。模型先从结构与电场样本中学习,再用目标任务的数据微调,最后进入逆向设计流程,帮助生成满足目标波前的结构。对应原文图 1。 邻域注意力到底在注意什么 可以把结构输入理解为一张材料分布图:不同像素表示不同的折射率,相邻像素拼出细条、岛状区域或复杂边界。光场的变化与这些空间组合密切相关。要预测得准确,网络需要识别局部细节,也需要了解它们在更大范围内如何组合。 邻域注意力的做法是,让每个位置先处理周围一定范围内的信息,并根据当前特征给不同位置分配不同权重。它不像常规卷积那样只使用训练后固定的卷积核权重,而是能随输入图案变化调整信息聚合方式。换一类结构,网络内部关注的组合也可以随之变化。 如果让每个位置同时比较整张图的所有位置,计算量会随着图的增大迅速上升。邻域注意力限制每一层的比较范围,在固定邻域大小下,注意力运算的计算量随位置数量近似线性增长,减轻了全局注意力的负担。 它又如何了解更远的区域?经过一层处理,每个位置的特征已包含附近信息;再经过下一层,这些已经汇集过的信息继续传播,模型能利用的范围便逐步扩大。研究使用 16 个邻域注意力模块,再结合多头机制、上下采样与残差连接,使局部细节和更大范围的信息在网络中逐层结合。 这就是这一机制值得引入的原因:它为精细空间预测提供自适应处理能力,同时避免每层都建立所有位置之间的联系。需要区分的是,注意力权重只是 AI 内部的信息处理方式,并不是纳米结构之间真实的光学作用力或耦合强度。它能否准确预测光场,要靠电磁仿真数据训练,并由独立结果检验。 模型学到的光场需要怎样检验 光不仅有强弱,还有相位。相位决定不同位置的光在传播后如何叠加:有的地方增强,有的地方抵消。一个模型即使把强度预测得大致正确,也可能因相位偏差而把最终焦点或光束形状预测错。因此,这项研究让网络输出复电场的实部与虚部,使振幅和相位信息都能被保留。 网络单次处理 5 μm× 5 μm的区域,其中有 25 × 25 个像素化纳米柱位置。对于 1064 nm 的工作波长,这一区域横跨约五个波长,能够包含较复杂的空间变化。研究以约 26 万个样本训练模型,样本涵盖随机图案、岛状结构和条纹等不同类型。 训练还考虑到相位的周期性:走过一个完整周期后,光的相位可以回到等价状态。团队用适合这种周期关系的损失函数评价相位差,避免让数值表示方式干扰误差判断。图中不同场分量的比较,正是为了检验模型是否保留了波前设计真正需要的信息。 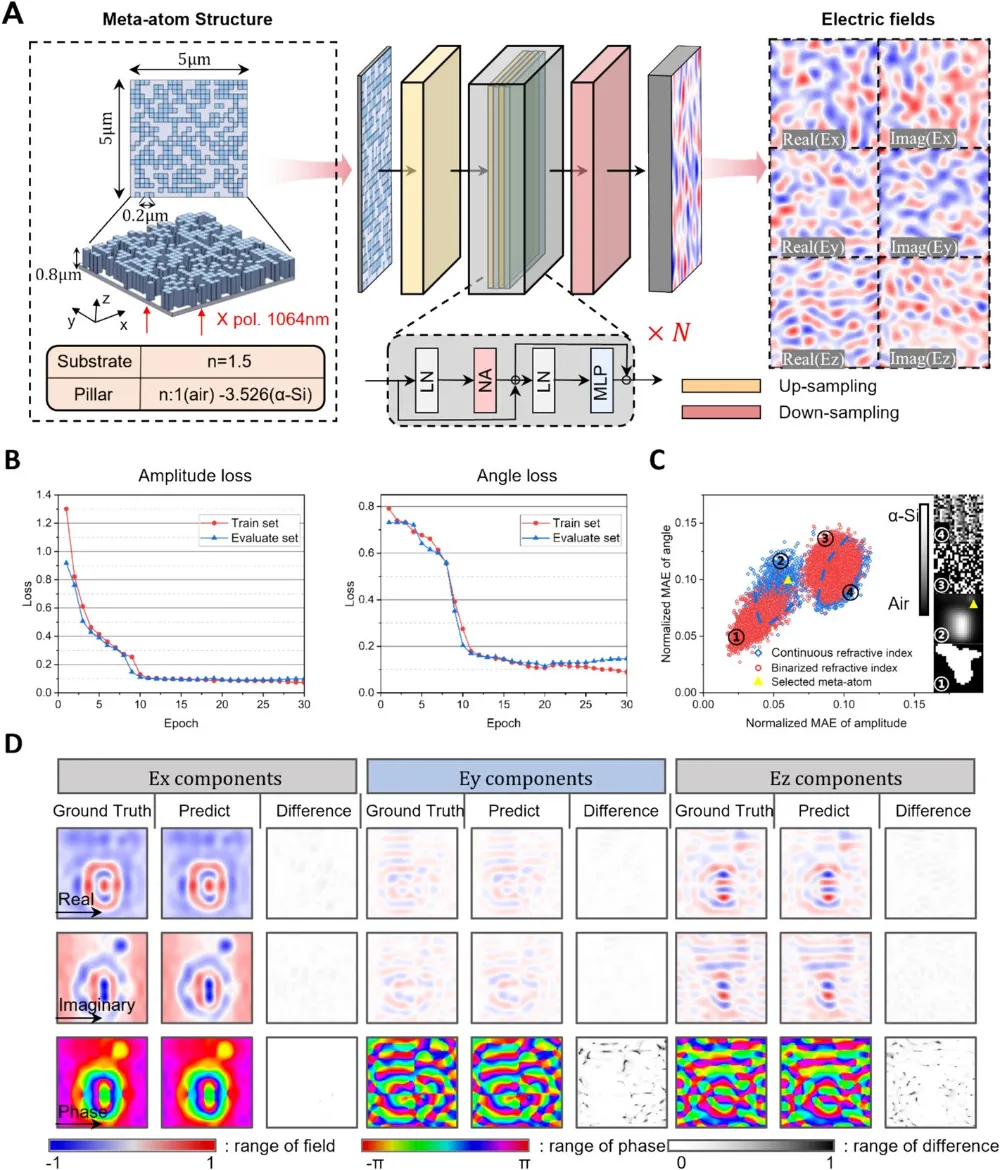
图2 从结构输入到复电场输出。上方展示网络工作方式,中间给出训练与误差统计,下方比较 AI 预测与电磁仿真中的电场实部、虚部和相位。对应原文图 3。 换一个设计任务 模型不必从头学起 学过许多随机结构,并不意味着模型已经同样擅长每一种目标器件。聚焦、涡旋和 Airy 光束的目标不同,优化中经常出现的结构也不同。如果能让模型再学习一些与目标任务相关的样本,就有机会把已有知识用得更准确。 研究以涡旋光束为例,先用预训练模型生成若干不同拓扑荷的器件,并保存优化中的结构,再用 RCWA 仿真获得相应电场。约 7500 个任务样本就能取得较好的适配效果,继续增加数据时收益逐渐变小。模型不同层采用不同学习率,以便在保留基础特征的同时调整任务相关信息。 这使模型的前期投入具有后续利用价值。论文报告,在所比较的优化阶段,相对于采用 FDTD 逐个求解超原子的方法,最高加速比约为 25 万倍。这一数字描述的是特定条件下的优化计算,并不把准备数据、训练模型或制造器件的过程一起算成同样的提速。 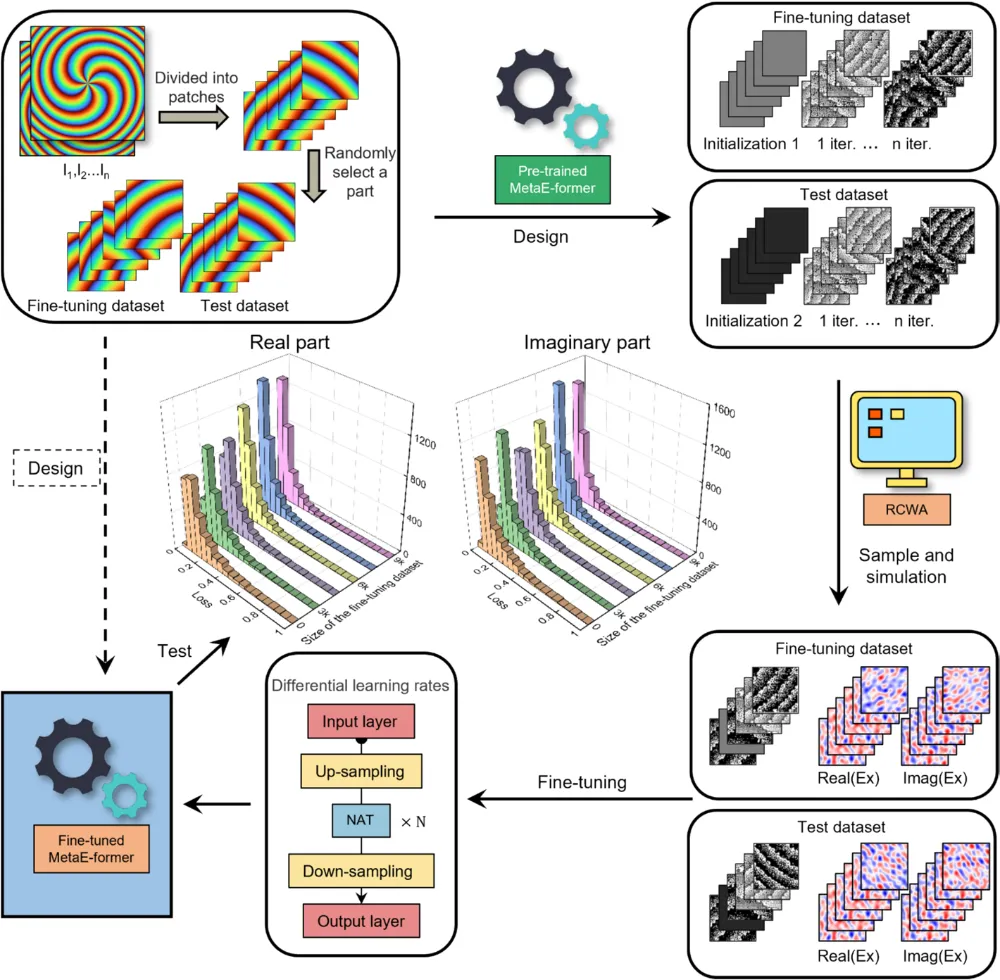
图3 面向新任务的微调。预训练模型参与设计,设计过程中产生的结构经电磁仿真形成新样本,再用于改进模型。图中的误差变化反映不同微调数据量带来的效果。对应原文图 4。 AI 给出的结构能做成真正的透镜吗 研究团队用一片毫米级水浸超透镜回答了这个问题。器件尺寸为 1 mm × 1 mm,工作波长为 1064 nm,设计焦距为 90 μm。为了让这么大的区域都得到优化,团队将其划分成许多小块并行计算,再利用重叠处理改善相邻区域的衔接。 计算中的折射率可以连续变化,制造时却需要明确的材料区域。团队因此在优化后期逐步加入二值化约束,让分布收敛为非晶硅与水两类区域。在模型准备完成后,两块 RTX 3080 Ti 显卡用约 4 分钟完成器件优化,再将结构交给纳米加工。 实验测得数值孔径为 1.31,横向焦斑半高全宽为 0.46 μm,Strehl 比为 0.83,显示出接近衍射极限的聚焦质量。数值孔径超过 1 与器件在水中工作有关,并非空气中光学条件下的异常结果。实测聚焦效率约为 24%,反映落入规定焦区的能量比例。 焦点大小、焦点质量与聚焦效率是不同指标。该实验说明,快速设计能够得到可制造并具有高数值孔径聚焦能力的器件;同时,实验效率与仿真值之间仍有差异,后续器件优化还有提升空间。 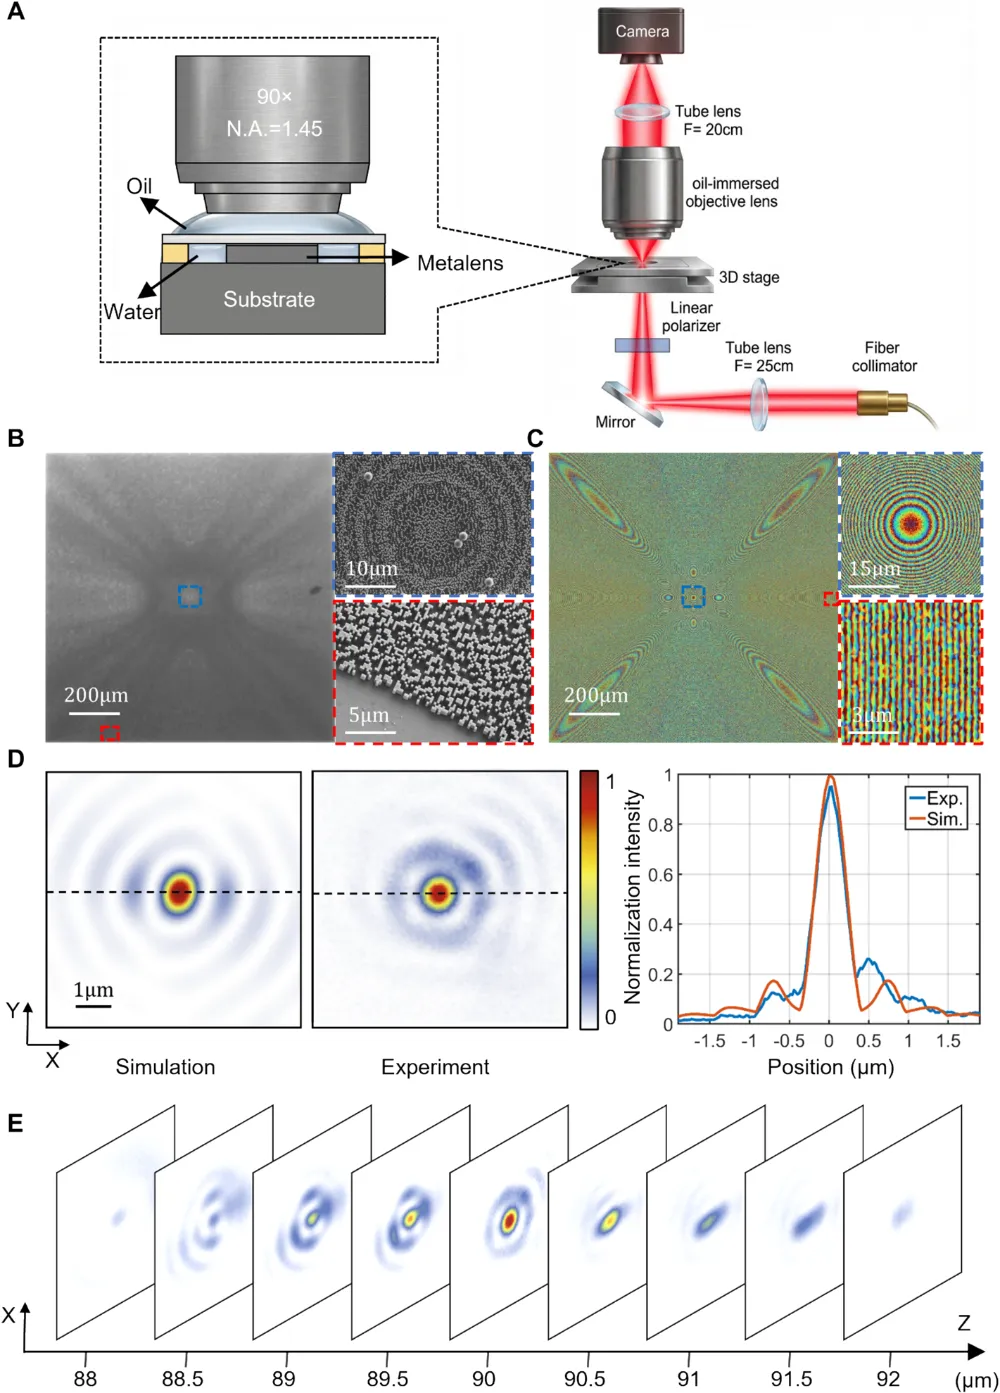
图4 从计算走到样品。图中展示超透镜的测试光路、实物显微和 SEM 图像、预测波前,以及实验与仿真的焦斑对比。最下方的多幅场图呈现光在焦点前后的变化。对应原文图 5。 同一套方法还能塑造什么光 除了把光聚成焦点,团队还设计了 Airy 光束与涡旋光束发生器。前者具有特征性的主瓣和旁瓣分布,后者呈现环形强度并具有螺旋相位。它们对结构的要求不同,适合用来检验模型能否经过微调服务于多种光场目标。 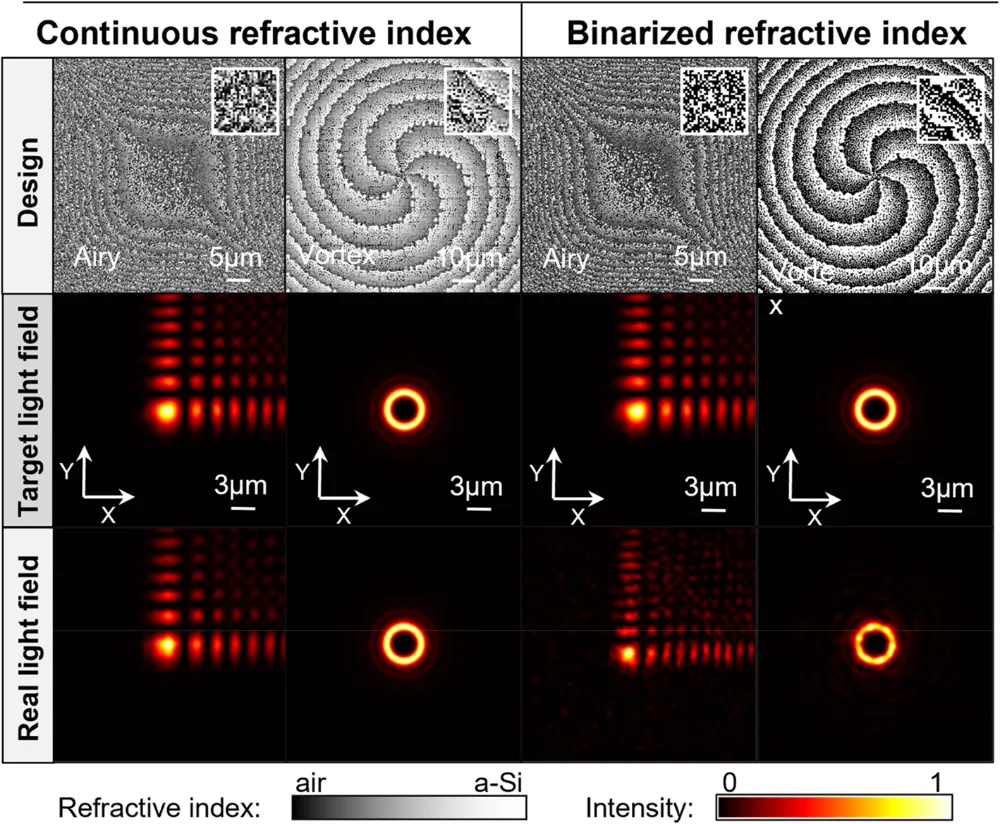
图5 不同光场的数值展示。上排为连续或二值化的自由形结构,中排为目标光场,下排为电磁仿真后传播得到的光场。Airy 与涡旋光束的主要特征均可辨认。对应原文图 6。 连续折射率方案与目标场更接近,转成两类材料后仍保留主要特征,同时出现一定偏差。这提醒我们,AI 设计也要面对真实材料与加工的约束。图中的结构光结果来自数值仿真,超透镜部分则完成了实际样品验证。 这项研究展示了 AI 在光学设计中一种具体而可检验的用法:学习重复出现的结构—电场映射,帮助优化程序更快地搜索可行方案。邻域注意力让较大区域的精细预测更可行,迁移学习让既有模型适应不同任务,实验则检验计算能否落到器件上。未来若进一步覆盖更多波长、偏振与入射条件,这类方法有望为复杂超表面的研发提供更灵活的设计工具。 论文信息 S. Kuang, Z. Sun, B. Fu et al. Rapid inverse design of large-scale freeform meta-optics with the neighborhood-attention transformer. PhotoniX 7, 69 (2026).
免责声明:本公众号旨在传递更多科研相关内容及分享,所有文章图片来源均注明出处,如涉及版权问题,请作者第一时间后台联系,我们将协调进行处理,对于投稿内容文责自负。