ARTICLE · 1127829
开源 AI 标注工具不易:7 个只有项目作者才懂的细节
开源 AI 标注工具不易:7 个只有项目作者才懂的细节
写 v2.0 的时候,整个项目是一个 5000 行的 .py 文件,PyTorch、GroundingDINO、SAM3、Qt 界面全揉在一起。跑是能跑,但任何一行新功能加进去都像拆炸弹。到了 v3.x 把模型、界面、标注、导入导出彻底拆开,这一年来踩的坑才一个个倒出来。
这篇文章分两部分:3 个工程类坑(开发过程中遇到的)+ 4 个标注流程类坑(用户使用中真实会撞上的)。不打算写成教程,只想让你少走点弯路。
代码全部开源,边看边对着仓库读更直观:
🔗 https://github.com/ASH1b1/VisionForge
坑 1 · OMP Error #15:环境变量要写在第一行
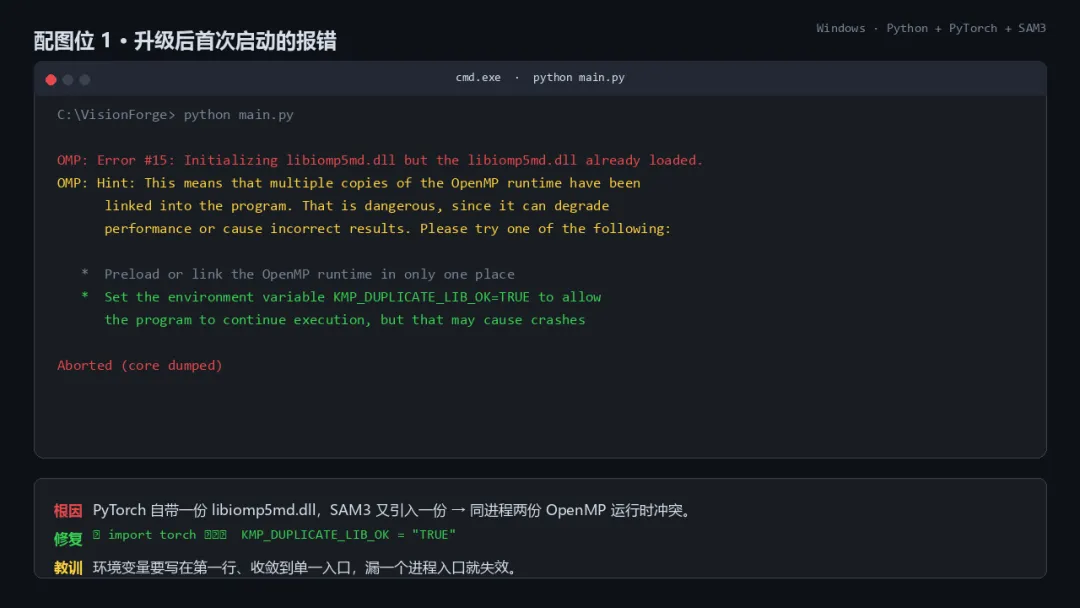
Windows 用户升级之后第一次启动,几乎必崩一次。错误信息是 OMP: Error #15: Initializing libiomp5md.dll but the libiomp5md.dll already loaded.,弹出一长串 C 运行时错误。
根因不复杂:PyTorch 自带一份 libiomp5md.dll,SAM3 又引入一份。同进程两份 OpenMP 运行时直接冲突。
最早我们是在 main.py 里、import torch 之前写一行:
import osos.environ[”KMP_DUPLICATE_LIB_OK”] = ”TRUE”# 然后再 import torch / groundingdino / sam
这句话听起来轻巧,但踩过这个坑的人会告诉你:位置一旦放错,就完全不管用。有同学把这个变量塞到 `__init__.py` 中间,结果 PyTorch 早就静默加载完了。
真正的问题是「有几个入口」。GUI 走 main.py、批量标注走 batch_annotate.py、测试走 pytest、还有各种 python -m。只要有一个入口漏设,或者被某个模块顶层的 import torch 抢在前面(我们当时的 segmentation_utils.py 就是模块顶层直接 import torch),这个变量就等于没设。
v3.1 的解法是收敛成一个入口,src/runtime_env.py:
def bootstrap_runtime_env() -> None:# Must run before import torch. Do not set these in model files.os.environ.setdefault(”KMP_DUPLICATE_LIB_OK”, ”TRUE”)os.environ.setdefault(”TRANSFORMERS_OFFLINE”, ”1”)os.environ.setdefault(”HF_HUB_OFFLINE”, ”1”)os.environ.setdefault(”OMP_NUM_THREADS”, ”1”)os.environ.setdefault(”MKL_NUM_THREADS”, ”1”)
所有进程入口(main.py / batch_annotate.py / 测试 conftest.py)第一件事就是调它,模型文件里不再各自设一遍,segmentation_utils.py 改成延迟 import torch。同时程序启动若捕获到 OMP: Error #15,会直接用中文说明——明确告诉用户"不要手动删 DLL",这是最常见的自救方式。
同样的代码放到Linux 上就不会崩,因为 Linux 的 OpenMP 加载策略更宽松。
总结:OpenMP 冲突在 Windows上经常出现 ,Linux 则不会。同一份代码跨平台表现不一致,是开源 AI 工具最隐蔽的入门门槛。而「环境变量设了几处」这种问题,靠注释和规则是管不住的,只能靠把入口收敛到一处。
坑 2 · Transformers 4.x vs 5.x:参数改名只是开始
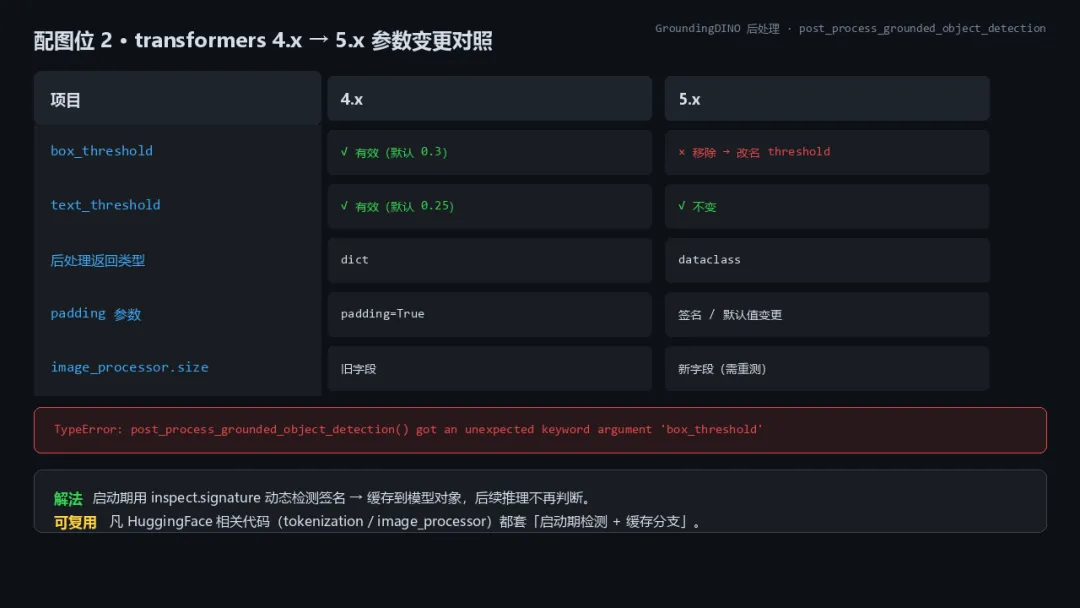
升级 transformers 之后,原本跑得好好的 GroundingDINO 推理全报错:TypeError: post_process_grounded_object_detection() got an unexpected keyword argument 'box_threshold'。
查 changelog 才看到:4.x 的 box_threshold 在 5.x 里改名为 threshold;text_threshold 没变;输出从 dict 改成了 dataclass。只兼容某一个版本,长期肯定撑不住,所以得走动态检测:
sig = inspect.signature(post_process_grounded_object_detection)if ”box_threshold” in sig.parameters:self._proc_kwargs = {”box_threshold”: 0.3, ”text_threshold”: 0.25}else:self._proc_kwargs = {”threshold”: 0.3, ”text_threshold”: 0.25}
启动时检测一次,把分支缓存到模型对象上,后续推理就不用再判断了。这套做法还能再延伸:transformers 5.x 也改了 tokenization 的 padding 参数,改了 image_processor 的 size,凡是 HuggingFace 相关的代码,都可以套用同样「启动期检测 + 缓存分支」的模式。
总结:依赖库的 minor 升级,很容易踩到「同名函数不同签名」。锁版本能短期稳定,长期看却会落后。动态检测比锁版本更优雅,前提是把检测逻辑放到初始化关键路径上,而不是每个推理请求里都跑一遍
坑 3 · 推理与切换模型的线程竞态,以及第三个检测器
v2.0 时期最头疼的一个 bug:用户点了「切换为 SAM3」按钮,界面立刻冻住,几秒后崩溃,错误指向 worker 线程的空指针。
我们的 worker 是一个单独的 QThread,负责跑模型推理。切换模型的逻辑,是先用 `unload()` 把当前模型的权重 `del` 掉,再 `load()` 新模型。如果切换的瞬间 worker 还在推理,`del` 会让模型对象的引用计数归零,C++ 端权重直接释放;而这时另一线程的 PyTorch C++ 扩展层还在访问这块显存,于是立刻 crash。
解法是引入 inference_lease 引用计数:
def acquire_inference_lease(self):self._lease_count += 1def unload_model(self):if self._lease_count > 0:return False, ”推理进行中,请稍候”del self._current_modelreturn True, ”ok”
worker 进推理前 acquire,出推理时 release,无论成功还是失败。unload 时检查 leases,归零才真正卸载。回头看,这个 bug 前后调了一礼拜,主要难点在概率复现:切换模型 100 次才崩 1 次。
而 v3.1 更大的教训是:别再用 if/elif加模型了。 早先代码里到处是「如果当前是 GroundingDINO 就……否则如果当前是 LocateAnything 就……」这样的硬编码分支,每加一个检测器就要改五六个文件,而且必然漏掉一处。
现在检测器收敛成了一套协议(load / unload / infer / signals),由 ModelController 按注册表调度。加一个检测器 = 注册一个 id,而不是再写第四个 if。顺带说一句:LocateAnything 已经从产品里整体剔除了——它的 NVIDIA 研究/评估许可不允许随产品分发,当初把它做成一个「默认关的开关」,本身就是一个错误的架构决策。
总结:单进程多线程加上 GPU 显存管理,是开源 AI 桌面工具的隐形杀手,这类 bug 复现率极低、堆栈也不直观。但比崩溃更致命的,是「靠分支堆功能」——**lease 只是局部方案,注册表才是结构性的方案**。
坑 4 · 标注格式坐标转换,从 5 种表达变成 7 种
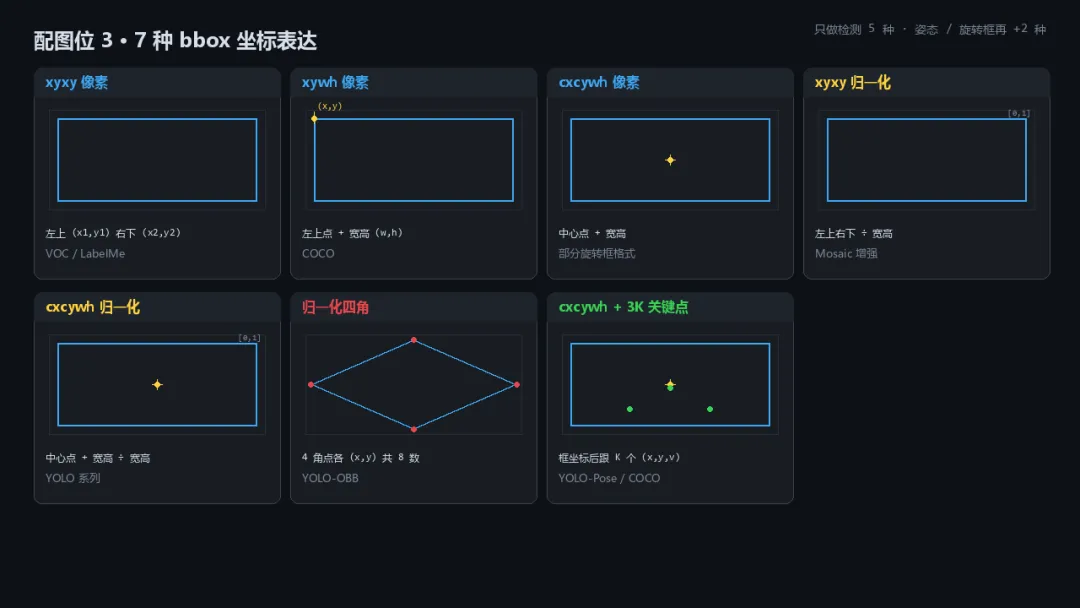
进入标注流程部分,第一个坑就是 bbox 坐标。这块的复杂度,大多数人都低估了。
只做检测的时候,主流 5 种表达要分清楚:
v3.1 加了姿态和旋转框之后,还要再加两种:
导出 YOLO 最常写错的一个:
def xyxy_to_yolo(box, img_w, img_h):x1, y1, x2, y2 = boxcx = ((x1 + x2) / 2.0) / img_wcy = ((y1 + y2) / 2.0) / img_hreturn [cx, cy, (x2-x1)/img_w, (y2-y1)/img_h]
边界有几个容易栽:x2-x1 不能为 0(除零);cx/cy 必须 clamp 到 [0,1] 之间否则训练 Loss 直接 NaN;像素坐标必须是整数个像素,否则和图像读取对不上。
新增两种表达的坑更隐蔽:
旋转框没有唯一表达。四边形是顺时针还是逆时针?起始角是左上还是右上?Ultralytics 有它自己的约定,你必须跟着它走,否则导出后训练时框会转 90°。我们最终按 Ultralytics 的四角顺序实现,并保留一个轴对齐外包框 bbox 用于画布命中——旋转框的命中测试,不是简单的矩形包含判断。 关键点的可见性要单独一维。YOLO-Pose 每个点是 (x, y, v),v∈{0,1,2}分别表示不可见 / 遮挡 / 可见;COCO 用的是float32,靠v=0约定缺失。导出时必须逐点写 v,只写坐标就丢信息了。姿态的框坐标还必须用官方cxcywh,不能用围出来的外接框。
总结:bbox 格式转换看似只有 10 行代码,但生产中 80% 的导入导出 bug 都出在这一步。把转换函数单独抽出来,用单元测试覆盖到每个分支(零宽度、超界、负坐标、四角顺序、关键点缺失),能省下无数 debug 时间。
坑 5 · NMS 不是「一个阈值函数」
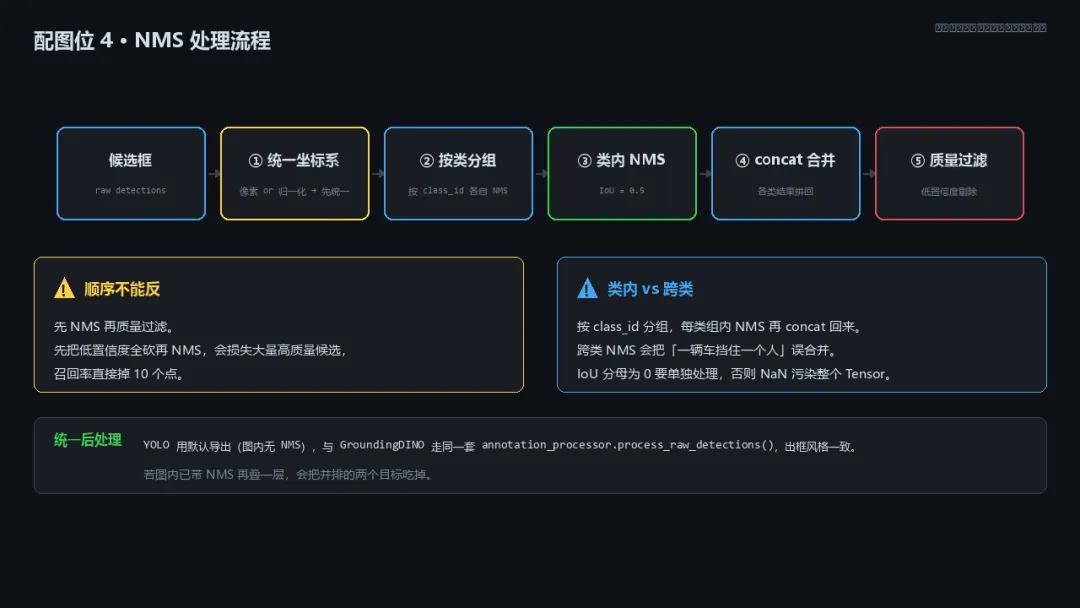
文本提示的自动标注场景里,NMS 是必经之路。但「一个 IoU 阈值就能搞定」只是错觉。
第一个坑是阈值次序。我的经验是先 NMS 再质量过滤,顺序不能反。如果反过来,先把低置信度全砍再 NMS,会损失很多高质量候选,召回率直接掉 10 个点。
第二个坑是「类内 vs 跨类」。一般推荐每类单独做 NMS:按 class_id 分组,每个类别组内做 NMS,再 concat 回来。跨类 NMS 会把「一辆车挡住一个人」这种情况误合并:
groups = defaultdict(list)for box, score, cls in candidates:groups[cls].append((box, score))kept = []for cls, items in groups.items():boxes = np.array([it[0] for it in items])scores = np.array([it[1] for it in items])idx = torchvision_nms(boxes, scores, iou_threshold=0.5)for i in idx:kept.append((boxes[i], scores[i], cls))return kept
第三个坑是 IoU 计算本身要求坐标系一致。两个框一个在像素空间、一个在归一化空间,算出来的 IoU 是 0.2,看着像没重叠,实际是算错了。必须先统一坐标系再算。分母为 0(某个框宽 0)要单独处理,否则 NaN 会污染整个 Tensor。
而引入自定义 YOLO 之后,第四个坑是「NMS 到底在谁那里做」。我们明确要求用户的 ONNX 用默认导出(yolo export format=onnx,图内无 NMS),这样 YOLO 和 GroundingDINO 走的是同一套后处理:annotation_processor.process_raw_detections()。这样阈值、NMS 顺序、字体颜色这些体验完全一致,也避免了「两个检测器出框风格不一样」这种最容易被吐槽的问题。反过来,如果图里已经带了 NMS,再叠一层,就会把并排的两个目标吃掉
总结:NMS 是「看起来直觉」的算法,但在生产环境里,它的实现细节决定了自动标注的可用度。文本提示出框的体验差距,往往就差在这 30 行代码里。
坑 6 · 导入数据集的 5 类问题
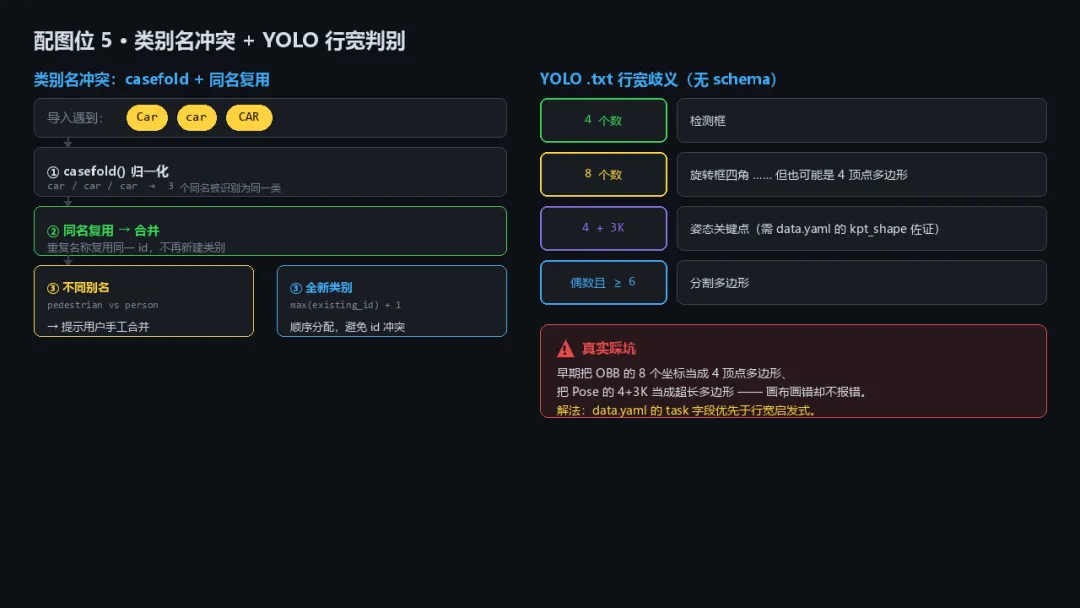
从 YOLO / VOC / COCO 导入历史数据集,是新用户最常踩坑的环节。归类下来 5 类:
6.1 类别名冲突
同一个数据集里出现 Car / car / CAR,是 3 个类还是 1 个?我们用 casefold() 后做同名复用,重复就合并;完全不同的别名(如 pedestrian vs person)则提示用户手工合并。新类别按 max(existing_id) + 1 分配,避免冲突:
name_to_id = {n.casefold(): i for i, n in existing_classes.items()}new_id = max(name_to_id.values(), default=-1) + 1for raw_name in incoming_names:key = raw_name.casefold()if key not in name_to_id:name_to_id[key] = new_idnew_id += 1
6.2 路径基准
跨电脑迁移 .gsproj 工程文件时,绝对路径会全部失效。策略是工程内部一律存相对路径(相对于工程根目录),运行时再用 os.path.join 解析。导入时如果发现是绝对路径,立即 warn 并尝试改成相对路径。
6.3 缺图 / 缺标签的容忍
背景图(无标签)正常导入,不报错。但标注文件引用了一张不存在的图像时,绝不伪造一个 1920×1080 的尺寸去跳过,而是跳过它,并在日志里写一条 WARN,让用户自己定夺。伪造的尺寸会在训练时导致 Loss 异常,排查起来非常痛苦。
6.4 classes.txt 缺失
YOLO 的类名在 data.yaml 的names字段,COCO 在 categories[].name,VOC 在根目录的 classes.txt。三种格式的类名来源完全不同,导入器要分别处理,还得允许用户手动指定类名顺序。类名顺序对不上,是 YOLO 训练最容易踩的坑:数据里是 id=5,7,9,但 names 第 0 项是 car,训练就乱了。
6.5 行宽歧义(v3.1 新增,也是最阴的一个)
YOLO 的 .txt 一行里 class_id 后面跟几个数,没有 schema,只能靠数个数猜:
data.yaml 的 kpt_shape 佐证) | |
后果非常具体:我们早期把 YOLO-OBB 的 8 个坐标当成了 4 顶点多边形,把 YOLO-Pose 的 4+3K 坐标当成了一个超长多边形——数据结构错了,画布上就画错了,而且不报错。
现在的策略是三级优先:
先读 data.yaml的task:字段(pose/obb/detect/segment);
关键点是绝不静默地把 pose / OBB 吃成 polygon。
总结:导入看着是「读文件、解析、塞内存」,其实是在和无数历史数据集拼兼容性。任何细枝末节(大小写、空格、BOM 头、CRLF、行宽歧义)都可能让数据导入失败,而且没有任何明显的错误提示。
坑 7 · 导出数据集的 5 类问题
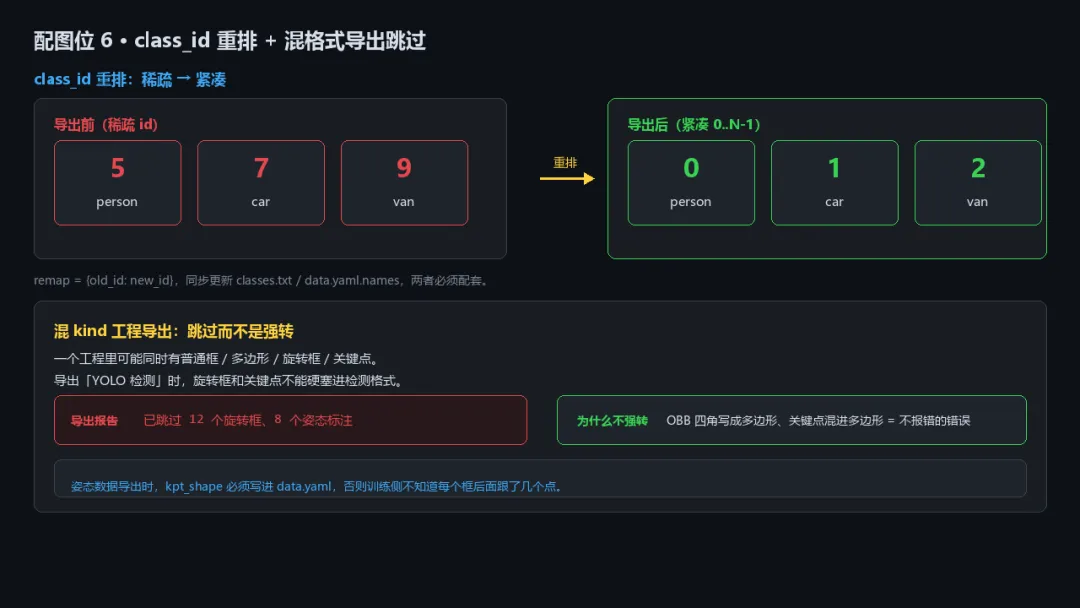
7.1 train/val/test 划分
工程中的数据集按目录推断(images/train/、images/val/、images/test/)。比例分配要可复现,用 random.Random(42) 作为种子;多类别大型数据集用 largest-remainder 算法(每类按比例分,余数大的多塞一张),避免小类被吞光。
7.2 class_id 重排
用户标注的数据集常常是 id=5,7,9 这样的稀疏编号,但训练时 PyTorch / YOLO 默认 data.yaml.names[i] 与标注文件第一列直接对应,必须重排为 0..N-1:
sorted_ids = sorted(existing_id_to_name.keys())remap = {old_id: new_id for new_id, old_id in enumerate(sorted_ids)}for ann in annotations:ann.class_id = remap[ann.class_id]
重排之前,要在工程里同步更新classes.txt 或 data.yaml.names,否则用户导完会发现类别映射全乱了。导出的 YOLO .txt 里写入的是新 ID,data.yaml.names 的索引也按新 ID 排序,两者必须配套。
7.3 SAM3 mask 转 polygon
当SAM3 mask 转 polygon:cv2.findContours + cv2.approxPolyDP 输出的顶点序列首尾不闭合时,导出 LabelMe 时必须手动补点:取首点加到末尾。漏了这一步 LabelMe 打开直接报错。
7.4 跨平台换行符 / 中文文件名 / 编码
Windows 上写文件是 \r\n,Linux 是 \n;中文文件名在 Linux 服务器上没问题但某些训练框架(特别是某些基于 Windows 编写的脚本)会报错;data.yaml 必须 encoding="utf-8"、ensure_ascii=False 写出。方案是统一写 LF 换行、UTF-8 无 BOM、文件名做一次 NFC 归一化。
7.5 混 kind 工程导出要「跳过而不是强转」(v3.1 新增)
一个工程里可能同时有普通框、多边形、旋转框、关键点。当用户选「导出 YOLO 检测」时,旋转框和关键点不能硬塞进检测格式——把 OBB 的四角写成分割多边形,把关键点坐标混进多边形序列,这比报错更糟糕,因为它不报错。
现在的做法是:导出某格式时跳过不兼容项,并明确报告跳过数量(例如「跳过 12 个旋转框、8 个姿态标注」)。同理,标注了姿态的数据导出时,kpt_shape 必须写进 data.yaml,否则训练侧不知道每个框后面跟了几个点。
总结:导出看起来是「内存写文件」,其实是在跟真实世界的脏数据打交道。你预设的兼容性矩阵再全,用户的真实数据也永远比格式规范脏上三个量级。
收尾
v3.1 这一轮把交互点选、顶点编辑、自定义 YOLO 预标、姿态与旋转框的导入导出都补齐了,这一篇算是对应的「避坑指南」。很多坑不是写得不好,是真踩过才知道深浅。
完整代码在 GitHub 上,欢迎对照 Issue / PR 一起讨论:
🔗 https://github.com/ASH1b1/VisionForge
顺带说 labelme
写到这里,估计有人会问:「你这套坑,labelme 用户是不是也踩?」答案是肯定的——labelme 用户最近的浅层痛苦主要是这三件:① SAM3、GroundingDINO 这类 AI 模型要单独去 huggingface 下载,国内网络拉不动的概率不小;② 即便下完也得「打开图 → 输入文本 → 点 Run」一张张触发,没有批量;③ 原生格式是 LabelMe JSON,转 YOLO/COCO 又得写脚本。VisionForge 默认三件都不踩:模型按需挂、批量跑、多格式直出。
你还踩过哪些开源 AI 工具的隐藏坑?是模型崩溃、标注对不上,还是格式不兼容?
系列目录 & 互动
Jade的工坊 公众号连载:
✅ 01 《LabelImg 上一下午,我差点把显示器砸了》 ✅ 02 《文本提示 → 检测框→精细分割,背后到底发生了什么》 ✅ 03 《告别 LabelImg?这套 AI 标注工具安装只要一行命令》 ✅ 04 《开源 AI 标注工具不易:7 个只有项目作者才懂的细节》(本文)
📱 关注公众号「Jade的工坊」回复关键词 VF,获取访问入口、教程索引、读者交流群入口💻 GitHub:https://github.com/ASH1b1/VisionForge
📮这是 4 篇连载的最后一篇,也是一份「年度踩坑合订本」。你最近半年用 AI 标注工具时踩过哪些坑?是模型崩溃、标注对不上,还是格式不兼容?最有代表性的 3 条会整理成 Q&A 单独发布,评论区见。