ARTICLE · 1131264
你电脑里那堆 AI 工具,其实压根不认识你:搭好这 4 个区,它才会越来越像你的助理
每天打开 AI,第一句话是不是又得从头交代:我是谁、做什么、讲给谁听、以前踩过什么坑、这次千万别写成什么样。
说完这些,它才开始干活。第二天换一个对话、换一个工具,又得再说一遍。
这件事很像你每天找一个能力很强的外包同事帮忙,但对方每天早上都会失忆。它会写、会查、会做表格,却不知道你的读者是谁,不知道你讨厌什么语气,也不知道那份两年前的旧方案早就不能用了。
所以我现在越来越觉得:装完 AI 工具,第一步不是立刻让它干活,而是先给它一份能读懂你的档案。
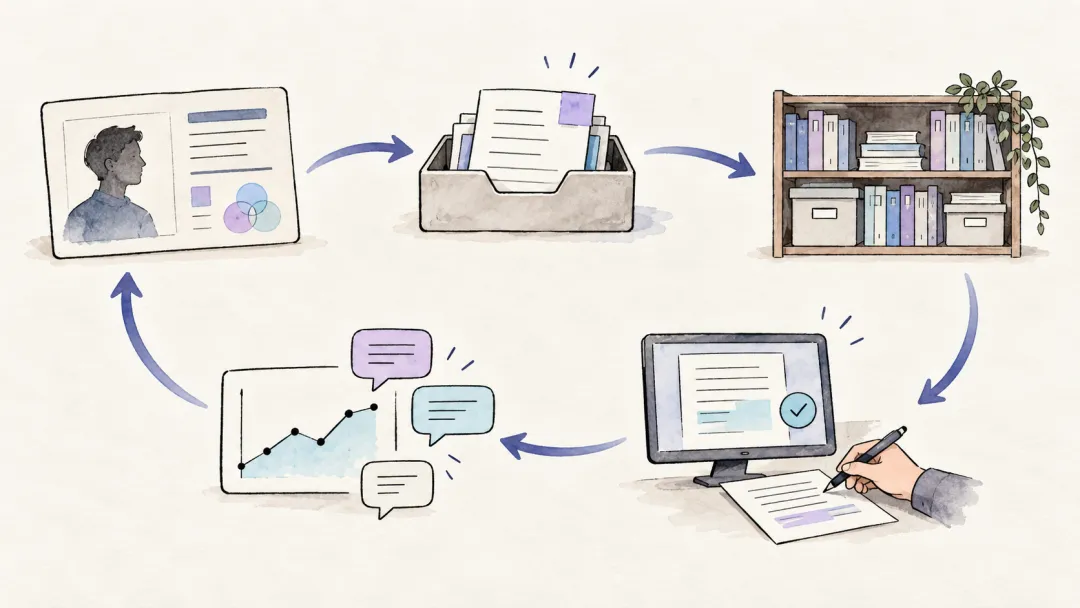
不是把文件一股脑塞进去,而是搭一条会流动的路:你是谁,东西从哪进,什么能留下,成品怎么验收,结果怎么再回到下一次决策里。
这篇就把我踩过的坑,以及后来改成的工作流讲清楚。你不需要先买复杂软件,先用电脑里现有的文件夹、笔记工具或 Agent 工作区,也能把这件事跑起来。
01.
资料多,不等于 AI 认识你
很多教程会教你“建立知识库”:把文档、链接、PDF、课程笔记全丢进去,最好再传几百篇。
这一步不算错,但只做到这里,通常只会得到一个更难找的文件夹。
我一开始就是这样干的。三百多个文件混在一起:对标视频、客户资料、写到一半的稿子、以前的方案,都放在同一个地方。有一次让它帮我写内容,它翻出了一份两年前的废稿当参考,语气和人设全偏了。
问题不是 AI 不够聪明,而是我没有告诉它:谁的优先级最高,哪些内容已经失效,哪些只是临时灵感,哪些才是正在执行的规则。
这也是“资料库”和“个人知识库”的差别。
前者只是保存东西;后者要不断回答三个问题:这是谁的资料?现在还有效吗?下一次任务该怎么被用上?
02.
先搭 4 个区:让每份东西都有去处
我现在会把工作内容分成四个区。文件夹、Notion、Obsidian、飞书、任何 Agent 的项目目录都能照这个逻辑搭,关键不是软件,而是职责不要互相打架。
1. 我是谁:它每次开工先读的底层设定
这里放的不是简历,而是一份持续更新的“个人工作档案”。至少写清五件事:
我在做什么;主要服务谁;我的表达习惯;哪些事实和案例可以使用;这周或这个项目的优先级是什么。
这份档案应该小而新。比起塞进 80 页自我介绍,我更建议每周花几分钟更新一次,把已经变掉的重点改掉。因为对 AI 来说,一份过期但写得很完整的档案,比没有档案更危险。
你可以直接从这个最小模板开始:
# 我的工作档案

我是谁:
我主要服务的读者/客户:
我最常做的三类任务:
表达与交付规则:
不能编造或必须核实的内容:
本周重点与暂不做的事:
下次让 Agent 干活前,不要只说“帮我写一篇”。改成一句:先读《我的工作档案》,再开始这项任务。这个动作看着小,但它把每次临时自我介绍,变成了固定的开工流程。
2. 收件箱:所有新东西先落地,不急着归类
刷到一条不错的对标视频、收到一个客户材料、突然想到一个选题,都先放进收件箱。
这里的规则很简单:只接收,不裁决。
很多知识库越用越乱,是因为人在忙的时候一边收东西,一边强迫自己做分类。最后要么懒得存,要么为了省事全塞进“重要资料”。收件箱就是给这种状态留的缓冲区。
但它也不能永久堆着。每周找一个固定时间,把里面的内容处理成三种结果:进入资料库、转成待办,或者删除。没有第四种“以后再说”。
3. 资料库:只留被确认过、能复用的东西
资料库不是垃圾场,而是下一次任务真正会被调用的参考层。
一条对标视频放进来,最好不只存链接或原片。顺手补一小段说明:它前 5 秒怎么抓人、讲了几个点、叙事怎么推进、哪些表达值得借鉴、哪些只是它的条件不适合照抄。
同样,一份客户资料进入库之前,也应该标上版本、适用项目、敏感范围和失效时间。能不能被 AI 使用,和能不能被你保存,是两回事。涉及客户、隐私、账号或未公开数据的内容,先按你所在团队的权限规范处理,别把“方便调用”变成信息泄露。
4. 输出区:成品必须和原始资料分开
文章、方案、PPT、脚本、代码、复盘,都放到输出区。它的作用不是归档好看,而是让你能回头验收:这个版本最后有没有真的发出去?哪个版本被改过?当时参考了什么?
我会把“人工验收”当成输出区的一部分。AI 给完成品,先自己读一遍:顺不顺,事实对不对,里面提到的经历是不是我真的做过。没问题,再往外发。
输出区里的东西不会自动晋升为资料库。 只有被验证过、下一次仍然值得借鉴的成品,才沉淀回去。否则模型很容易把一份尚未确认的草稿,当成未来的标准答案。
03.
给 AI 的不是一堆文件,而是一条明确的使用顺序
搭完四个区,最重要的是让 Agent 知道先读什么、后读什么。
我更推荐这个优先级:个人档案 → 当前项目说明 → 已整理资料库 → 收件箱里的临时素材。
这相当于先让它知道“你是谁”,再告诉它“这次要做什么”,最后才给它参考材料。顺序反过来,几百份旧资料很可能会把当前目标淹没。
比如你要写一条 60 秒口播,不妨这样交代:
先阅读我的工作档案。
再阅读本次选题说明和指定对标稿。
先给出:目标受众、核心观点、60 秒结构、可借鉴但不照抄的表达。
不确定的事实单独列出,不能自行补写。
我确认结构后,再生成口播成稿。
这比一句“按我的风格写”靠谱得多。因为“我的风格”对模型是模糊词,而档案、指定参考和任务边界是可执行的上下文。
还有一点很关键:别要求它每次“把整个知识库都读一遍”。资料越多,越要挑选。现在的任务需要哪三份资料,就给哪三份;已经过期的资料,明确标为不能参考。AI 能读到很多内容,不代表它会自动替你判断哪份最有权威。
04.
最有价值的一步,是把发出去之后的结果丢回来
很多人的工作流到“AI 写完”就结束了。但这只解决了产出速度,没有让系统变得更懂你。
一条内容发出去后,评论里读者卡在哪、完播在哪掉、收藏来自什么需求、你自己觉得哪里别扭,这些都是比通用教程更贴近你的数据。
不需要一上来做复杂看板。每次只留一条简单复盘就够:
标题:
面向谁:
这次想验证什么:
发布后出现了什么反馈:
下次继续做什么 / 停止做什么:
把这些复盘放回“我是谁”或资料库里,下一次选题时让 AI 连同最近几条反馈一起读。它参考的就不再只是网上通用的“爆款方法”,而是你自己的真实轨迹。
这一步也要克制。一次数据好,不代表规律已经成立;一次数据差,也不必急着否定所有方法。把反馈当成下一轮要验证的线索,而不是自动生成结论的机器。
05.
今天就能开始:不要搬家,先跑一个小闭环
你不用把过去所有文件重新整理一遍。那很容易把“搭系统”做成新的拖延。
今晚花 15 分钟,做四件事就够了:
第一,建一个《我的工作档案》;第二,建一个收件箱;第三,从最近的一条对标内容里,写下它值得借鉴的三个具体动作;第四,下一次交任务前,强制让 AI 先读你的档案。
等这一轮任务结束,再补一条反馈。你就已经跑完了第一圈。
个人知识库不会让任何一个模型突然“永久记住你”。不同工具的记忆、项目文件和上下文能力也不一样。但它至少把最关键的判断从模型手里收了回来:哪些内容是你的现在,哪些是已经失效的过去,下一次任务究竟该站在哪些经验上继续往前走。
以前,我们每回都在向 AI 自我介绍。现在,是让它先读一遍档案,再和我们一起工作。
这不只是让写稿、做方案、做 PPT 快一点。它让你从一个每天都从零开始的人,慢慢变成一个手上有东西、经验能累积的人。
如果只能先补一项,你最想先把哪条规则写进自己的工作档案?
如果你觉得今天这篇有收获,欢迎点赞、在看、转发三连,我们下篇见。