ARTICLE · 1138854
给 AI 以工具,而不是给工具以 AI
先说一件让我有点意外的事。
前阵子我做了个小实验。我用app排好一张传统的八字盘——天干地支、大运、流年,一格一格排得清清楚楚。然后我把这张排好的盘,整段复制,丢给了 Kimi K3,让它把这套符号体系解读一遍。
它解出来了。解读得极其精准。里面提到的几个流年节点,跟我实际经历的事对得上。
我盯着屏幕看了半天。它答得对,这不稀奇。稀奇的是 —— 按我的常识,它根本不该答对。
过去两年,我对 AI 干这活是有定论的:不行。
这套干支体系看着像个符号游戏,底下压着的却是一堆死规矩。你让它排个大运,十次能错七八次。六十甲子的顺序背得乱七八糟,节气交接的日子算不对,起运的岁数更是随口就来。排盘这个地基本来就是歪的,后面它再一本正经跟你讲结构,那不成瞎扯了么?
但这一次它站住了。同样的 Kimi,同样是我,同样的盘。唯一的区别是:我没让它排,我让工具app排完再给它。
我一开始以为撞上它这次没犯病。后来越想越不对劲——这哪是运气。这是我以前把活派错了人。
把这件事拆开看。
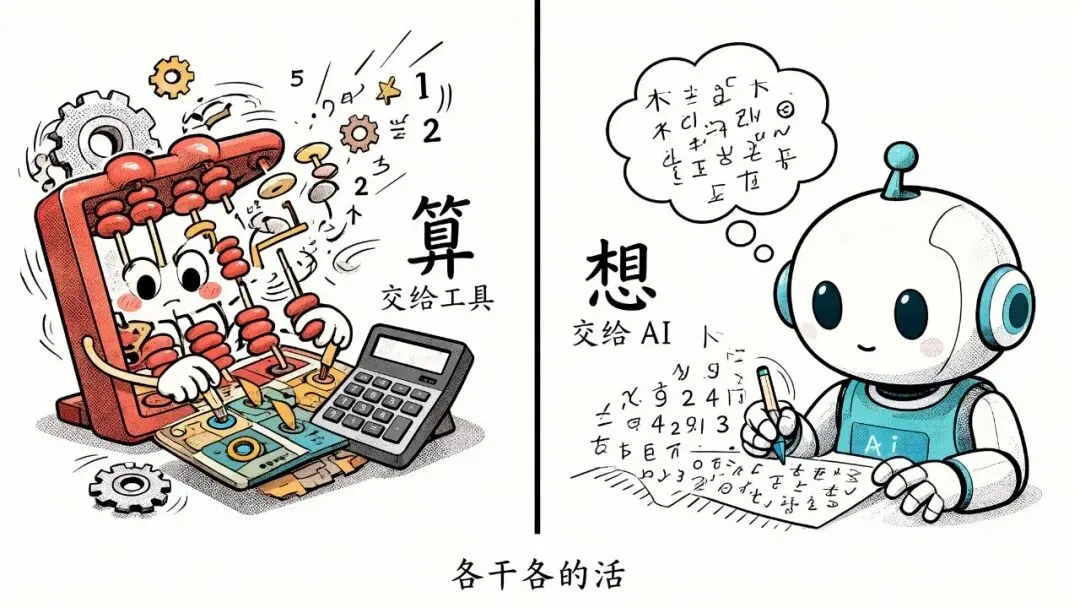
排一张干支盘,本质上是一套纯确定性的历法计算。年月日时怎么折算成天干地支,节气在哪天交接,大运从几岁起、几年换一步,每一步都有唯一正确答案,一分一毫都差不得。这玩意儿是「算」,不是「想」。
而大模型最不擅长的,恰好就是「算」。
它不是一个计算器,它是一个靠概率往外吐字的语言模型。它知道「甲子」后面跟「乙丑」,是因为训练数据里这个搭配见了太多次。可你要它从某个日子开始,一格一格推六十步,中间还夹着闰月、节气、真太阳时——它一定会漂。就像让人闭着眼、听别人报坐标去打《超级马里奥》,你说他掉不掉坑?
它哪是不行。是我让它用嘴去干算盘的活,还怪它算得慢。
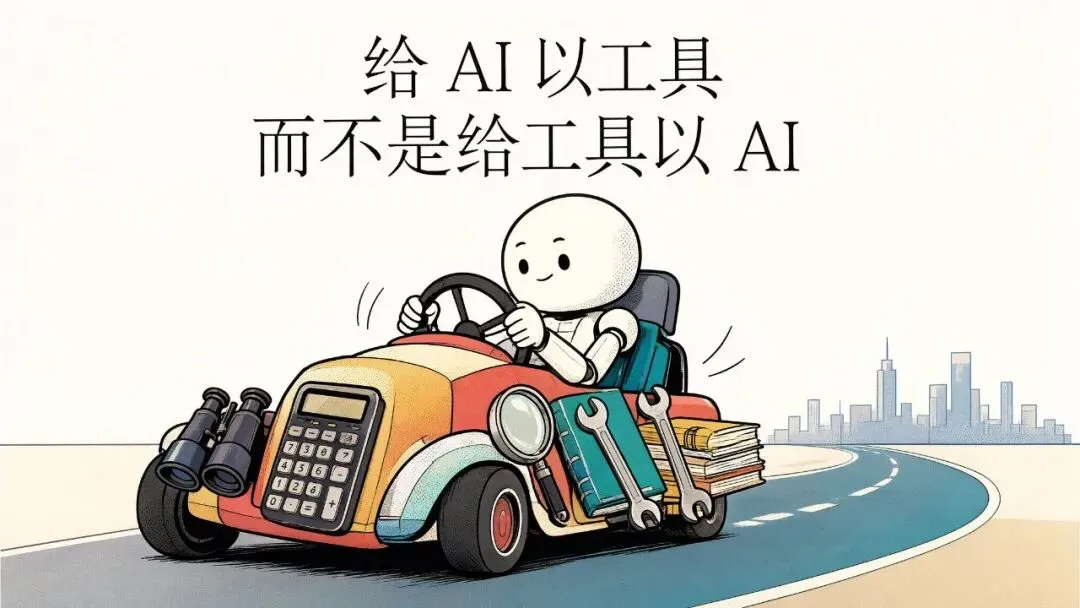
于是就有了这篇文章的题目——给 AI 以工具,而不是给工具以 AI。
这个句式是我偷来的。刘慈欣在《三体》里写过「给岁月以文明,而不是给文明以岁月」,再往上追,是化用帕斯卡那句「给时光以生命,而不是给生命以时光」。套到 AI 上,我实在找不到更贴切的表达。
两个方向听着像绕口令,差的是主体的位置。
「给工具以 AI」,是我们这几年的默认操作。做一个排盘小程序,底下接个模型,加个「AI 智能解读」按钮;做一个写作插件,塞个「AI 润色」。在这种思路里,工具是主体,AI 被塞进去当一个功能。你等于把一个什么都会聊的大脑,硬按在了一格一格的工位上,让它当螺丝钉。
反过来,AI 是那个坐驾驶位的人,工具是它手边的家伙什——需要算,递计算器;需要查,递检索;需要看,递一双眼睛。
一字之差,一个大脑的命就完全不一样了。
这件事,最近有人用最硬的方式证明了。
MIT 的何恺明团队前几天挂出一篇论文,叫 VISTA,在推特上炸了。他们干的事,说白了就一句:没换模型,只给模型换了一套「看」和「记」的方式。
ARC-AGI-3 是今年 3 月出的 AGI 考卷,一堆从没见过的像素小游戏,开局没有任何说明和规则,全靠自己试错摸规则。在此之前,官方考场递给模型的,是一张 64×64 的数字表——人眼里的小人、机关、路线,到模型那儿只剩 4096 个数字。
VISTA 做的第一件事,就是把数字表换回一张图。别的什么都没改。
结果:
| 模型 | 换之前 | 换之后 |
|---|---|---|
| GPT-5.6 Sol | 13.33 分 | 47.32 分 |
| Claude Opus 5 | 40.68 分 | 100 分(满分) |
| GPT-5.6 Sol(全套 VISTA) | — | 99 分 |
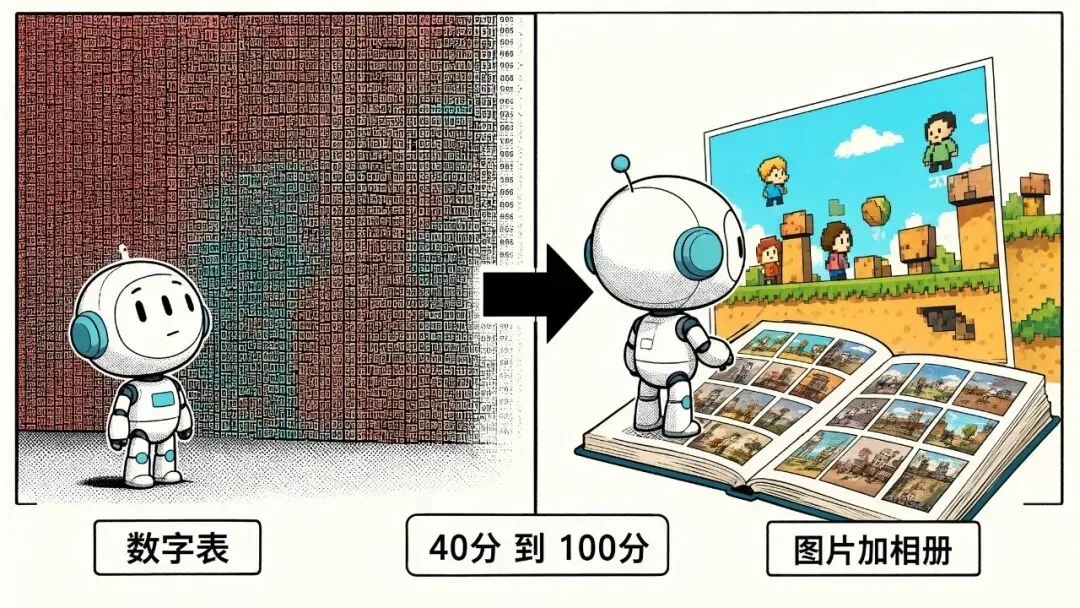
同一个 Claude,一分参数没动,从 40 分干到满分,走的步数甚至比第一次玩这游戏的人还少一半多。
第二件事是给模型配一本「相册」。一局游戏要好几百步,模型看图看一遍,上下文一满就删了。等它想回头核对某一步的画面,那一帧早灰飞烟灭了。VISTA 就把每一帧原样存档,模型想看哪一帧,随时喊一声调出来,还能几帧并排对比、放大角落。第三件事更简单——给它两个笔记本,一本记已经确认的规则,一本当草稿纸。
然后是最反直觉、也最该记住的一组数:
ㅤ ㅤ
给得多,不等于给得对。
论文里有个细节特别像人:游戏里出现一个橙色方块,模型点了一下,方块变成了 X。它没急着往下走,先把操作前后的几帧动画调出来,一帧一帧比对,看懂了才继续。最后它自己在笔记里写了一句:「这就是我要的工具,用它搭天花板,挡住会要命的上升。」
还有个对比我特别喜欢。这个夏天,一帮高手为了让 AI 打穿这场考试,给每个游戏硬写模拟器——光一个跳棋游戏就写了 4000 行 Python。而 VISTA 里的模型,自己在笔记里写了三句话,就把同一套规则拿下了。
写 4000 行代码的,和写 3 句笔记的,用的是同一个基座模型。
ARC Prize 的联合创始人有句话,我觉得会越来越准:未来越来越多的「学习」,会发生在模型权重之外。
现在你再看我那张盘,就明白发生了什么。
排盘那部分——六十甲子、节气、起运时间,是确定性计算,交给工具,一格不错。解读那部分——把一堆天干地支、五行生克,翻译成一段人能看懂的结构描述,是符号到语义的映射,是语言和模式的活。这恰好是大模型的主场。
我翻了翻网上的实测,这事其实有一堆人踩过坑,只是很多人踩完了,结论是「AI 不行」。有个博主拿同一组参数,把几款热门大模型挨个测了一遍,发现通用大模型普遍缺一个严谨的算法引擎,经常在基础排盘和大运时间线上出幻觉。豆包的大运表甚至出现过年份倒挂;DeepSeek 换个参数重测,能把干支属性判错;Kimi 考据一堆古籍原文,但太依赖书本上的静态规则,不懂结合整体结构灵活变通。
这几家的毛病,全出在同一个地方:该算的没算准,该想的没敢想。
而我的做法,无非把两件事分了个工。排盘交给引擎,解读交给 Kimi。 地基先打正,上面那层楼它才盖得起来。
说到这儿,你可能觉得:行,这套盘看明白了,跟我有什么关系?
关系大了。
你回头看看自己手上那些「AI 干不了」的事,有多少是真干不了,有多少只是你没给它工具。
写代码的:你让它凭记忆写,它给你编 API、编函数名;可你要是把真实的报错、真实的源码、能跑的测试递给它,它立马换一个人。编译器、测试、抓取,都是它的工具。
做视频的:你让它「帮我剪个片」,它抓瞎;但你把渲染引擎、ffmpeg、字幕工具接到它手上,它就能一格一格把活干出来。
写文章的:我自己有个体会,让 AI「给我写一篇」,出来的东西又空又硬;但你把原文、把素材、把真实的例子喂给它,出来的东西天上地下。工具给得越实,它才越像在干活,而不是在表演干活。
这两年聊 AI,绕来绕去就三个阶段。有人总结得特别好:
ㅤ ㅤ ㅤ
大多数人卡在第一步,还在琢磨怎么把话说得漂亮点,整那点虚的,指望靠一句咒语让模型封神。真正拉开差距的是第三步——你给它搭的这套家伙什,够不够称手。
所以下次你看着 AI 的答案,心里冒出「这也不行啊」的时候,先别急着换个更贵的模型。
先问自己一句:我是嫌它脑子不行,还是我让它赤手空拳上的?
多半是后者。
VISTA 那帮人已经把这道理摆到桌面上了:同一个 Claude,同一套权重,40 分和 100 分之间,差的是外面那双眼睛和那本相册。
AI 最值钱的地方,是替我们把意思想明白。 算的那部分,本来就该交给工具。
别急着换一个更聪明的它。先看看你手里那副工具,递给它了没有。