ARTICLE · 1141076
迪赢基因合成纠错试剂盒,助力AI时代高质量基因片段规模化构建
点击蓝字 关注我们
AI蛋白设计、抗体发现和大规模功能筛选正在显著加快序列生成速度。过去一次实验可能只需要构建几十条基因,如今越来越多项目需要同时获得数百、数千条高质量基因片段,并尽快进入表达、筛选和功能验证。
但传统基因合成的高正确率,很大程度上依赖“克隆化+挑克隆+测序验证”这一后端筛选过程。对于少量基因,这种模式可以工作;一旦进入规模化构建,逐条挑克隆就会成为时间、人工和交付效率的瓶颈。如果希望不挑克隆或大幅减少挑克隆,单靠传统合成与组装流程往往难以稳定获得可直接用于下游的高质量基因片段。
真正需要改变的,不只是“怎么筛错”,而是把质量控制前移:在进入最终克隆与测序之前,尽可能降低错误模板的比例,让后续筛选从“碰运气”变成更高概率地获得正确序列。
传统基因合成通常经历寡核苷酸合成、PCR扩增、片段组装、克隆、挑克隆和Sanger测序等步骤。寡核苷酸合成和后续扩增、组装过程中产生的碱基替换、插入或缺失,会以一定比例存在于最终DNA产物池中。
过去的解决方式,是把这些DNA分子逐个克隆化,再通过测序“挑出”正确的那一个。换句话说,传统流程获得高质量基因的关键并不只是前端合成,而是依赖后端克隆筛选完成最后一道质量控制。序列数量一旦从几十条扩大到数百、数千条,挑克隆和测序工作量也随之快速增加。
传统逻辑:先合成,再靠克隆筛选“挑对”
→ AI时代:先纠错,再规模化获得高质量片段
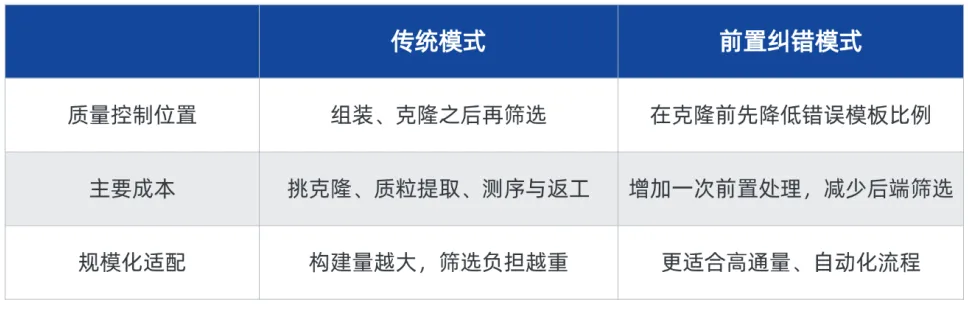
基因片段越长,构建步骤越多,“至少包含一个错误”的累积概率就越高。即使单碱基错误率已经较低,当目标变成较长片段或大批量基因时,未经处理的组装产物中仍可能存在相当比例的错误分子。
传统克隆流程可以把单个DNA分子分离开,再通过测序从中找到正确克隆,因此能够容忍前端产物池中存在一定比例的错误。
但如果希望直接使用组装后的基因片段,或者大幅减少挑克隆,这道“后端人工选择”就不存在了。此时,错误分子会直接进入后续表达、转染、蛋白筛选或其他功能实验,影响实验效率和数据质量。
因此,对于面向AI时代的免挑克隆、少挑克隆和规模化基因片段构建,纠错不再只是一个可选的优化步骤,而是把传统“筛出正确克隆”升级为“直接制造高质量片段”的关键质量控制环节。
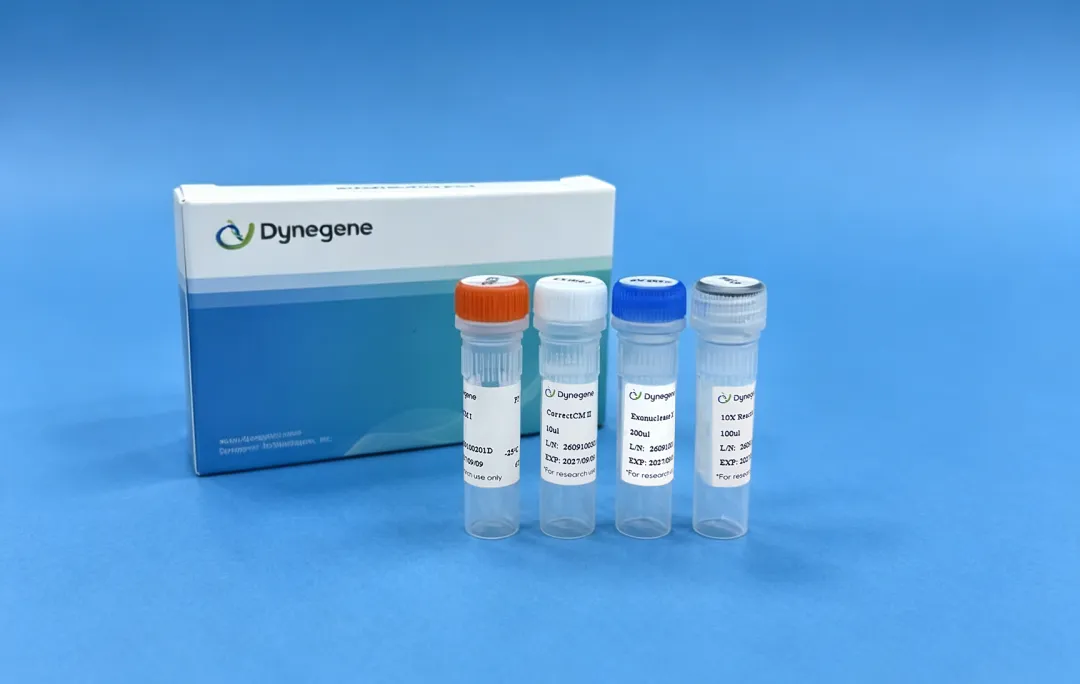
迪赢基因合成纠错试剂盒面向基因合成与DNA组装场景。内部性能验证显示,对于初始平均错误率约为1/1,000bp的DNA片段,经过纠错后整体错误率可降低至约1/10,000bp。
如下图所示,GFP基因的纠错前正确克隆为40.9%;纠错后正确克隆达到96.8%。这一结果说明,通过在克隆筛选之前主动降低错误分子的比例,可以显著提高产物池中正确序列的占比,为免挑克隆的高质量片段流程演进提供基础。
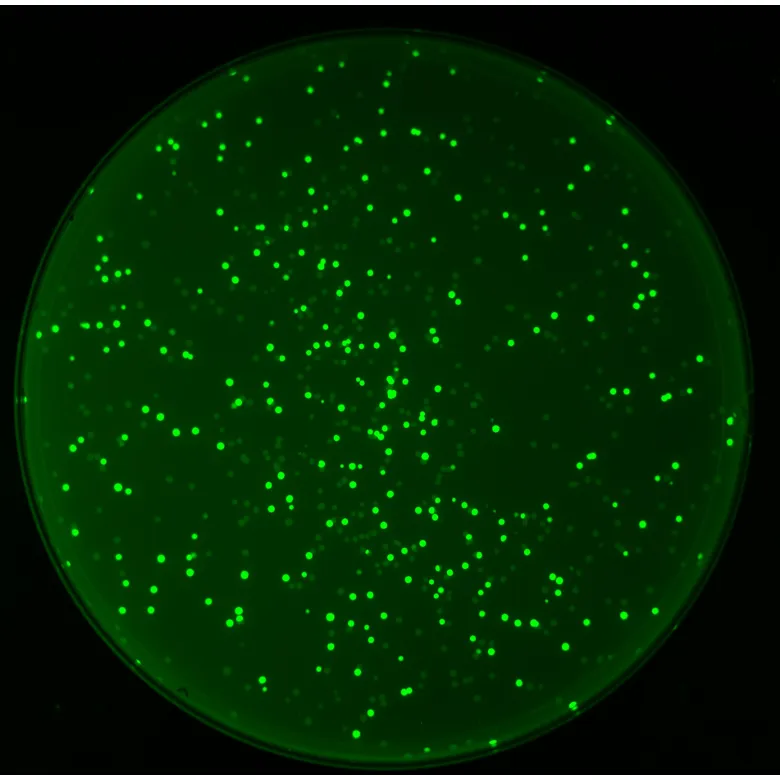
纠错前克隆子正确率40.9%
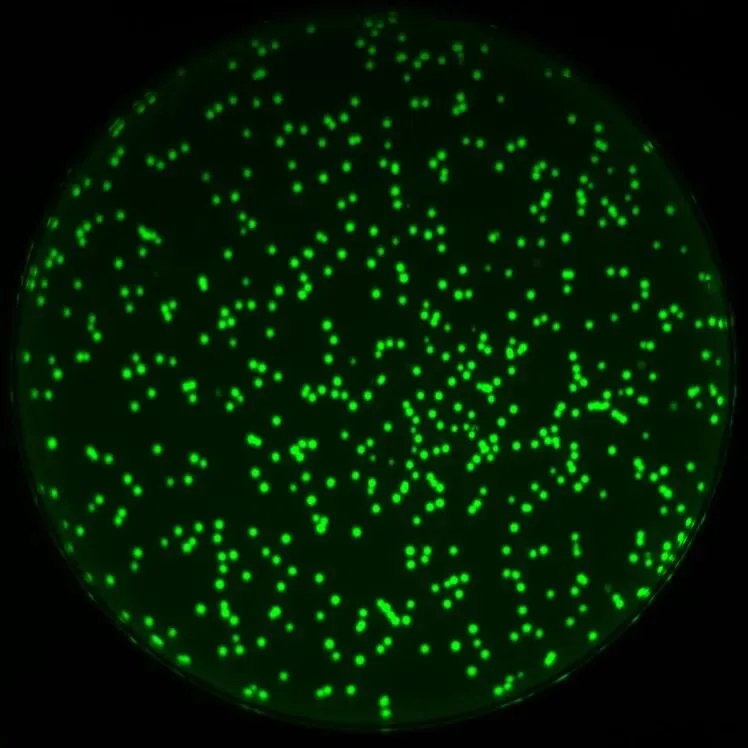
纠错后克隆子正确率96.8%
图.基因片段纠错前后克隆正确率对比(内部实验数据)
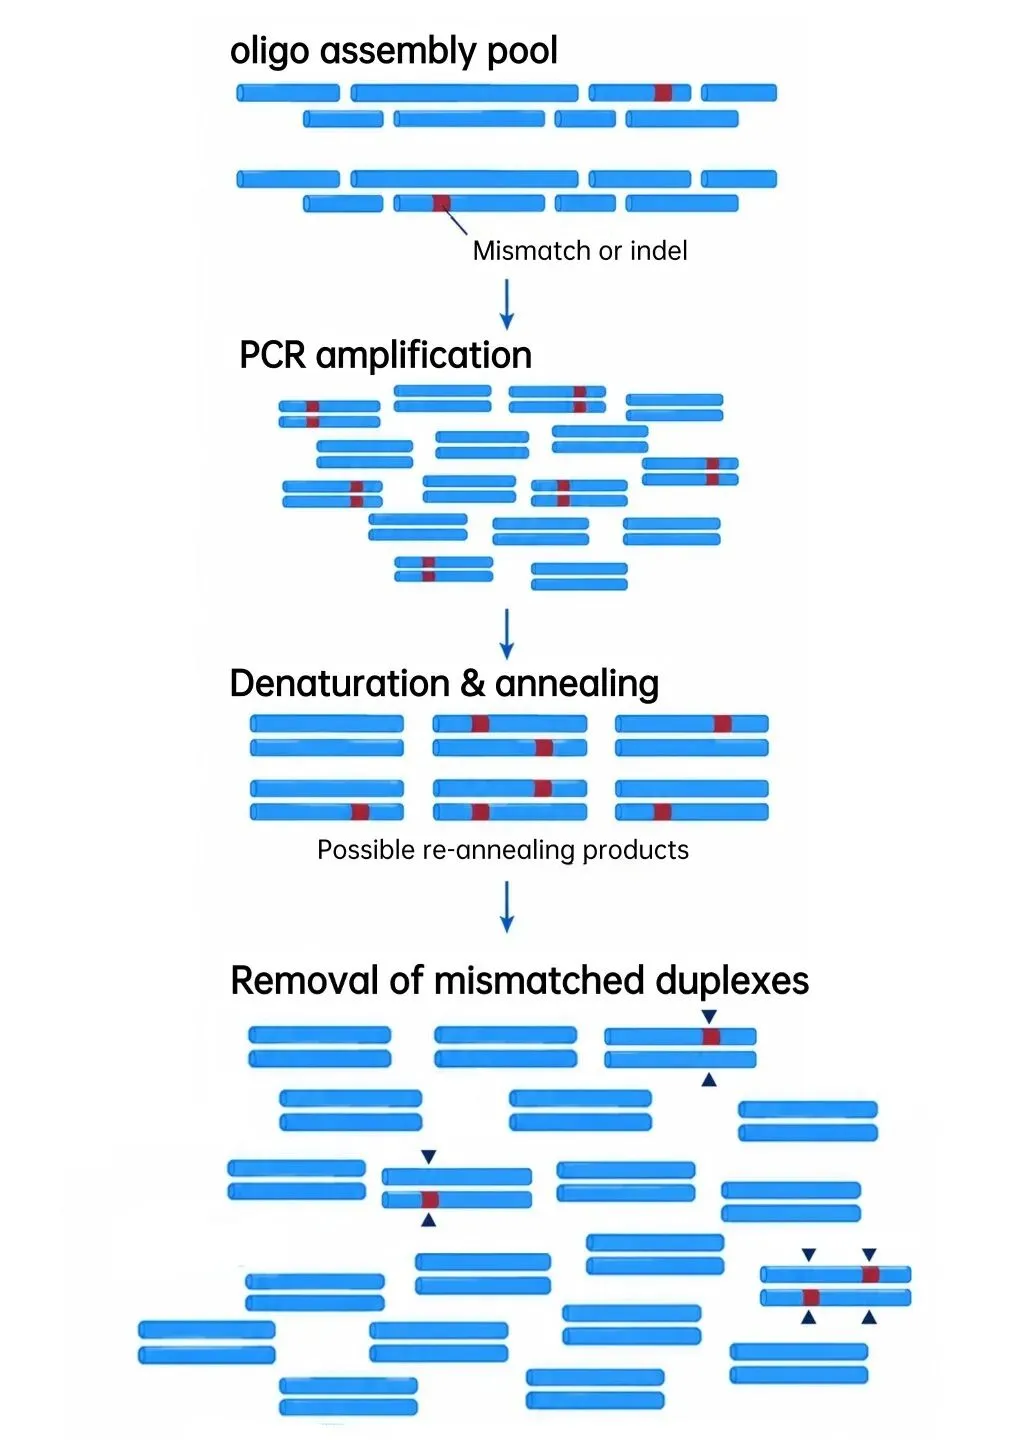
基因合成纠错并不是简单地“多做一步酶反应”,而是改变质量控制发生的位置。其核心思路,是先让正确序列与错误序列在双链DNA结构上形成可识别差异,再通过错配识别与选择性处理,降低错误分子的有效比例,最终富集正确模板。
基因合成纠错技术
扩增或组装后的DNA经过变性与复性,不同分子之间重新配对。含有碱基替换、插入或缺失的序列可形成局部错配结构,为后续识别提供基础。纠错的第一步,就是把原本隐藏在序列中的错误转化为可被分子体系识别的结构差异。
这一步的意义在于:不再等到克隆和测序阶段才发现错误,而是在基因片段仍处于批量DNA产物状态时,就开始主动区分正确分子与错误分子。
通过错配识别与处理体系,对含异常结构的DNA分子进行选择性识别和削减,使错误分子更难进入后续扩增和构建步骤。纠错的目标不是一次反应“清除所有错误”,而是持续降低错误模板的比例,让正确模板在产物池中占据更高比例。
经过纠错处理后,正确模板比例提高,再结合高保真扩增与后续质量控制,可显著降低对大规模挑克隆的依赖。其基本逻辑可以概括为:
高质量合成→高保真组装→错配识别与纠错→正确模板富集→高质量基因片段
最终测序仍然可以作为质量确认手段,但不再承担“从大量错误克隆中寻找正确序列”的主要任务。对于规模化基因制造而言,这种质量控制前移才真正具有可扩展性。
AI正在把生物研发从“设计少量候选、逐个验证”推向“生成大量候选、快速实验筛选”。数字端可以在很短时间内生成成百上千条蛋白或抗体序列,但如果实验端仍然依赖逐条克隆、挑菌和测序,干湿实验之间就会出现明显的速度断层。
对于AI蛋白与抗体研发:高质量基因片段可以更快进入表达和功能验证,减少等待正确克隆的时间。
对于高通量基因库:把纠错前移到片段层面,才能减少数百、数千条序列对应的克隆筛选和测序负担,提升批量构建的一致性与交付效率。
对于自动化与规模化制造:只有当“高正确率”主要由合成、组装和纠错流程本身实现,而不是依靠人工逐个挑克隆,基因构建才真正具备进一步自动化和规模化的基础。
传统基因合成可以依靠克隆筛选获得正确序列,但这种模式天然适合低通量,而不适合序列数量快速增长的AI时代。随着基因需求进入数百、数千条甚至更大规模,逐条挑克隆会越来越难以匹配上游数字设计和下游高通量实验的速度。
如果目标是不依赖大量挑克隆、直接获得可用于后续实验的高质量基因片段,那么仅提高合成或组装单个环节的准确性还不够。必须建立从高质量合成、高保真组装到错配纠错和正确模板富集的完整质量控制体系。
从“合成出来”到“直接可用”,是AI时代基因制造能力升级的关键。迪赢推出基因合成纠错试剂盒,希望将纠错能力标准化、产品化,使其更容易嵌入现有基因合成与DNA组装流程,为高质量基因片段的规模化构建提供基础工具。
迪赢生物高通量DNA合成平台
——AI制药时代不可或缺的底层支撑
AI 制药浪潮下,大模型正在掀起一场生物学革命,我们真正需要的不只是更快的设计能力,更是与之相适配的规模化分子合成与高通量实验验证能力。
作为新一代核酸合成领域的深耕者,迪赢生物高通量合成平台能力正是这一AI浪潮中不可或缺的底层支撑——公司成功打破了现有技术的限制,开发出具有完全自主知识产权的新一代超高通量DNA合成平台,全面提升了DNA合成通量、大幅降低了合成成本,可实现最长360nt、高达435万条不同客户定制化序列的并行合成,同时保持高准确度与高均一性。在AI制药“Design-Build-Test-Learn”的闭环中,迪赢生物以扎实的底层制造能力,为AI大模型的海量设计提供了可靠的落地支撑,成为AI制药时代上游基础设施的重要力量。
基于自主超高通量DNA合成平台,迪赢目前可支持:
✔ 数百万级超大规模寡核苷酸池并行生成✔ 任意兼并碱基设计(R/M/Y/H/B/V/N 等)✔ 多比例复合碱基控制✔ 不等长序列设计✔ 甲基化与特殊修饰碱基设计