ARTICLE · 1155303
注意力源码精读:N-back 掉分,为什么怪 softmax?
Daniel-Gong/attention-precision 用一个手写注意力的 decoder 复现并扩展 Self-Attention Limits Working Memory。仓库 10 月 9 日创建,今天仍在更新。
注意力源码精读:N-back 掉分,为什么怪 softmax?
N 增大,N-back 准确率掉。这篇工作把原因追到注意力分数的分散上,并用一套可干预的注意力实现做验证。
论文|Self-attention limits working memory capacity of transformer-based models(扩展版含 Working Memory Capacity of ChatGPT) 作者|Dongyu Gong 等 论文地址|https://arxiv.org/abs/2409.10715[1] 与 https://arxiv.org/abs/2305.03731[2]代码地址|https://github.com/Daniel-Gong/attention-precision[3]代码日期|仓库创建于 2026-10-09,最后推送 2026-10-11
01 / 先看结论
解决了什么: LLM 在 N-back 任务上随 N 增大性能下降,此前缺机制层面的解释。 改了什么: 训练原始 decoder-only transformer 做 N-back,发现注意力分数逐步聚集到 N-back 位置;注意力矩阵的总熵随 N 增大。分散可能是容量上限的原因。 停在哪里: 仓库分三部分:理论(src/ap/theory)、小模型实验 E1–E9、预训练 LLM 研究 L1–L6。我核对了代码结构和注意力实现,没有跑实验。
先看 src/ap/models/attn.py。注意力是手写的,不是 nn.MultiheadAttention——温度、注意力变体、oracle 注意力和项敲除都从 AttnControl 走。
02 / 问题背景
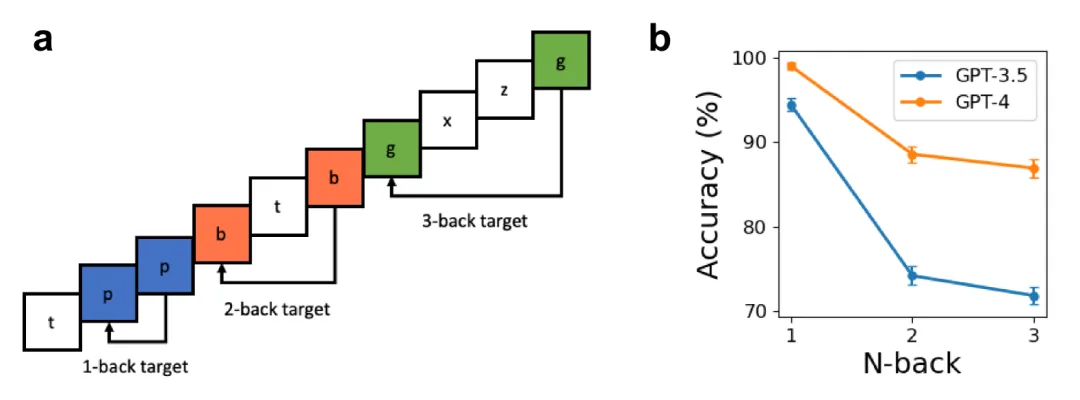
N-back 是心理学的工作记忆测试:看一串字母,当前字母是否与往前第 N 个相同。N 越大,人和模型都越难。ChatGPT 的实证研究(arXiv:2305.03731)先确认了这个现象在 LLM 上存在,NeurIPS 2024 workshop 论文把假设指向自注意力。
解释的难点在于:模型答错时,你分不清是「没记住」还是「检索错了」。这篇的做法是把检索过程暴露出来——记录注意力概率,直接看模型在看哪里。
注意力分数的熵随 N 增大,能不能作为容量上限的机制解释?
03 / 方法拆解
主线:可控的 N-back 数据生成 → 可配置 decoder → 注意力干预 → 度量。
设计一是数据生成器 v2(src/ap/data.py)。字母表 20 个辅音,24 个字母一段,默认 8 个 match。比 workshop 版多了受控 lure:lure_offsets(n) 返回 n-1、n+1、n+2——正好差一点才命中的位置。标签总是从最终序列事后重算,构造上保证正确。workshop 生成器只在 i > N 时拒绝意外 match,i == N 处可能有错标;v2 在每个 i >= N 都拒绝。
设计二是注意力家族(src/ap/models/attn.py)。一个可配置 decoder 覆盖 workshop 模型(residual=False, ffn=False, ln=False, pe="learned", 1 层 1 头)和标准块(pre-LN、残差、FFN)。注意力函数有四种:softmax、sigmoid、ssmax(scalable softmax)、topk。位置编码五种:learned、sinusoidal、rope、alibi、none。默认配置下与 workshop 代码数值一致,tests/test_models.py 里有等价测试。
公式层面看一个量就够:注意力矩阵的总熵 H = -Σ p log p。论文的核心观察是 H 随 N 单调增——同样的检索需求,注意力摊得更薄。topk 和温度都是压这个熵的干预手段。
04 / 源码对照
src/ap/data.py N-back 生成器 v2:lure、变长、事后标签 → src/ap/models/attn.py 手写注意力 + AttnControl → src/ap/metrics.py d'、AUC、lure 剖面、K_eff、MI(attention; label) → src/ap/train.py 配置驱动训练 → configs/ 每个 YAML 一个实验 → results/ 每次运行一行 JSONL(config、seed、git hash、曲线、指标)关键实现一:AttnControl。runtime 干预打到每一层每一头,除非 heads 收窄。temperature 除 logits;oracle_offset 把注意力换成 i-offset 上的一位热;denoise_offset 只保留模型在 i 和 i-offset 上的质量,可选是否归一化。这套旋钮就是「检索精度」的可操作化——论文的机制假设全部从这里验证。
关键实现二:lure 剖面进 metrics.py。d'、AUC 之外有 K_eff 和 MI(attention; label),把「注意力指向」本身当被测对象。这比只报准确率多出一层证据。
与论文的对应:熵随 N 增大、注意力聚集到 N-back 位置这两个结论,对应的代码出口是 record=True 时存下的注意力概率和 logits,配 metrics.py 的熵计算。仓库比论文正文多出来的部分是 L1–L6 的预训练 LLM 研究目录和 slurm 脚本。
05 / 实验配置
模型:d_model 512 默认,1 层 1 头起步,可开残差/FFN/pre-LN。 数据:24 字母一段,8 match,lure 数可配,字母表 20 辅音。 注意力变体:softmax/sigmoid/ssmax/topk 四种,topk 默认 4。 位置编码五种。每个实验一个 YAML,结果一行 JSONL 带 git hash。 理论部分在 src/ap/theory,E1–E9 小模型、L1–L6 LLM 研究分目录。
最影响可比性的是 lure 设置:clean=True 时非 lure 位置避开所有 lure offset,和 workshop 数据不可直接比。
06 / 结果怎么看
论文报告:训练中注意力分数逐渐聚到 N-back 位置;注意力矩阵总熵随 N 增大。10 页 12 图。
我没有跑 E1–E9。results/ 目录里有带 seed 和 git hash 的 JSONL 记录,复算入口是 scripts/summarize.py,输出 mean ± SEM 表。
熵增大是相关性证据,因果证据要靠干预实验:topk 或 denoise 把熵压回去,看准确率是否恢复。这类实验的配置在 configs/ 里,论文哪张图对应哪个 YAML 需要进去对。
07 / 论文与代码
已对应:熵观察(metrics + record)、注意力聚集(record 的概率)、workshop 模型等价(tests/test_models.py)。
实现补充:lure 生成器 v2 修正了 workshop 生成器 i == N 处的潜在错标;四种注意力变体和五种位置编码超出了论文摘要提到的范围。
配置选择:1 层 1 头是 workshop 复现配置,不是缺陷;标准块配置另开。
待核实:理论部分(src/ap/theory)与正文定理的对应,我没有逐条核。
08 / 复现路线
克隆仓库,装 torch,从 configs/ 挑一个 E 系实验跑 train.py。成功标志是 results/ 里新增一行 JSONL,含 config、seed、git hash 和曲线。然后用 scripts/summarize.py 出汇总表。
最容易踩的坑:lure 参数。clean=True 的数据和 workshop 原始数据分布不同,比较时要固定同一种生成设置。
09 / 判断
这套代码的价值在可干预性:AttnControl 把「注意力检索精度」变成可以拨的旋钮,熵不再只是观察量。手写注意力换来了实验自由度,等价测试兜住了复现底線。
限制:小模型上的机制结论外推到 LLM 要走 L1–L6,那部分成本高得多。我没有跑任何实验。
一句话:把「模型记不住」拆成「检索精度」,这个仓库给了完整的实验台。
参考资料
[1] 论文 https://arxiv.org/abs/2409.10715[4] https://arxiv.org/abs/2305.03731[5]
[2] 代码 https://github.com/Daniel-Gong/attention-precision[6]
[3] 关键源码 src/ap/models/attn.py src/ap/data.py src/ap/metrics.py
引用链接
[1]https://arxiv.org/abs/2409.10715
[2]https://arxiv.org/abs/2305.03731
[3]https://github.com/Daniel-Gong/attention-precision
[4]https://arxiv.org/abs/2409.10715
[5]https://arxiv.org/abs/2305.03731
[6]https://github.com/Daniel-Gong/attention-precision