ARTICLE · 1155301
物理 AI 研究进展
——从世界模型到具身基础模型的范式演进
文章结构
摘要
关键词
一、引言
二、概念界定与研究框架
(一)物理 AI 的边界
(二)三层技术栈
三、世界模型:从视频生成到可交互的物理推演
(一)视频预测路线的得与失
(二)潜在空间与显式物理约束
(三)物理一致性的评测困境
四、具身基础模型:从 VLA 到世界—动作模型
(一)双系统架构
(二)动作生成的范式迁移
(三)世界—动作模型的崛起
五、数据引擎:从倒置金字塔到第一视角学习
(一)倒置金字塔
(二)从遥操作到人类第一视角
(三)合成数据与缩放律
六、仿真到现实:迁移技术的进展
(一)并行物理引擎
(二)域随机化与系统辨识
七、评测体系:从单点成功率到泛化度量
八、关键挑战
(一)数据墙与跨本体异构
(二)物理幻觉与因果缺失
(三)长程任务与误差累积
(四)算力约束与产业生态
(五)安全验证与评测标准化
九、趋势展望
参考文献
摘要
物理 AI(Physical AI)指能够感知、理解、预测真实物理世界,并能在其中自主交互以完成各种任务的人工智能模型与系统。它被视为人工智能从数字空间走向实体世界的关键范式跃迁,2026 年被业界普遍称作"物理 AI 元年"。系统梳理该领域近三年的研究进展:首先界定物理 AI 的概念边界与全模态、多维异步性、局域性三大属性,提出"世界模型—具身基础模型—实时执行"的三层技术栈;继而分析世界模型的视频预测路线与潜在空间路线,指出"物理幻觉"是当前模型逼近真实物理规律的主要障碍;随后追踪具身基础模型从视觉—语言—动作模型(Vision-Language-Action Model,VLA)向世界—动作模型(World Action Model,WAM)的演进,剖析双系统架构、流匹配动作生成与统一多模态建模三条技术脉络;进而讨论以"倒置金字塔"为核心的数据引擎、从遥操作转向人类第一视角数据的范式转移,以及并行物理引擎与域随机化驱动的仿真到现实迁移;最后结合 LIBERO、LIBERO-Plus、RoboTwin 2.0、RoboArena 等评测体系的实测数据,指出当前模型在分布扰动下性能大幅衰减、物理一致性远低于人类水平的基本事实,并归纳数据墙、跨本体异构、长程误差累积、算力约束与安全验证五大挑战。认为,物理 AI 的"ChatGPT 时刻"不会由单一技术突破带来,而将通过"世界动作模型统一化、第一视角数据规模化、分层场景落地"三条路径渐进实现。
关键词:物理 AI;世界模型;具身智能;视觉—语言—动作模型;世界—动作模型;仿真到现实;缩放律
一、引言
过去十年,人工智能最深刻的进展几乎都发生在数字空间:语言模型学会了写作与推理,扩散模型学会了绘制图像与视频。然而这些系统有一个共同特征——它们只"说"和"画",却从不"动"。它们对世界的全部认识来自被人类挑选过的文本与像素,从未体验过把一个杯子推下桌子会发生什么。
物理 AI 正是要补上这一课。它的目标不是让模型更善于描述世界,而是让模型能够预测世界如何演变,并在演变之中选择自己的动作。2026 年前后,这一方向从学术议题迅速升格为产业主线:仅 2026 年第一季度,全球物理 AI 领域融资即超过 64 亿美元,此前 18 个月累计流入资金超过百亿美元;ICRA 2026 的世界挑战赛吸引了来自多个国家和地区的 336 支团队逐鹿世界模型赛道;同年 6 月,国内首个"物理智能创新联合体"成立。业内普遍将 2026 年称为"物理 AI 元年"。
热度之下,产业界的判断反而更加冷静。复旦大学张立华教授在世界人工智能大会上指出,AI 模型能感知空间、识别物体,并不代表能在物理空间中顺利完成任务,中间隔着状态建模、物理推演、策略规划、实时控制与安全验证等多个环节。"从看懂到做对",这道天堑正是本领域的核心命题。
要跨越它,仅靠把语言模型做得更大是不够的。语言模型处理的是人类已经压缩好的符号,而物理世界提供的是连续、高维、带噪声、部分可观测的观测流。一个只能做模式识别的系统,无论参数多庞大,都无法替代对重力、摩擦、接触与因果的显式或隐式建模。这正是世界模型被重新置于舞台中央的原因。
从 2022 年生成式模型的爆发,到 2025 年首个开源人形机器人基础模型发布,再到 2026 年世界—动作模型的集体涌现,这一领域的技术脉络已初步成形。图 1 梳理了近五年间的标志性事件。
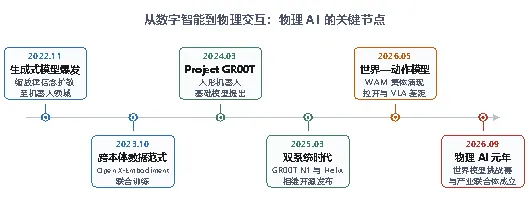
图 1 物理 AI 领域的标志性事件时间轴
本文的组织如下:第二节界定物理 AI 的概念与三层技术栈;第三节讨论世界模型的两条技术路线及其物理一致性困境;第四节分析具身基础模型从 VLA 到 WAM 的演进;第五节梳理数据引擎的范式转移;第六节介绍仿真到现实的迁移技术;第七节审视评测体系的演进与暴露出的问题;第八节归纳关键挑战;第九节给出趋势判断。
二、概念界定与研究框架
(一)物理 AI 的边界
物理 AI 并非凭空出现的新技术,而是物理仿真、机器人学、具身智能与基础模型等多条脉络的集大成者。一个被广泛引用的表述是:物理 AI 是能够感知和理解真实物理世界、能够模拟和预测真实物理世界运转过程、能够在真实物理世界中交互并完成各种任务的人工智能模型与系统。
它与人们熟悉的数字 AI 存在系统性差异。最根本的一点在于:数字 AI 的输出是符号或像素,错误的代价只是重生成一次;物理 AI 的输出是力和位移,错误的代价可能是摔坏的物体,甚至是受伤的人。这一差异决定了物理 AI 在数据、评测与安全三个维度上都面临更严苛的约束。
与之一同被反复讨论的是物理 AI 的三个属性。其一是全模态:系统需要同时处理视觉、听觉、触觉、本体感觉(proprioception)乃至力反馈,任何单一模态都不足以支撑操作决策。其二是多维异步性:不同模态的采样频率天然不同——视觉相机可能工作在 30 Hz,力矩传感器在 1 kHz,而语言指令可能几十秒才出现一次,模型必须在这种非同步的流上建立统一的时间基准。其三是局域性:智能体只能观测到世界的一个局部,外部影响只能通过干预的方式介入,这使其在数学上天然对应一个部分可观测马尔可夫决策过程(Partially Observable Markov Decision Process,POMDP)。
表 1 给出了物理 AI 与数字 AI 的对比。
表 1 物理 AI 与数字 AI 的关键差异
对比维度 | 数字 AI | 物理 AI |
输入空间 | 文本、图像等人类已符号化的数据 | 连续、高维、带噪声的传感器流 |
输出空间 | 符号序列、像素 | 力、位移、关节角度等控制量 |
试错代价 | 极低,可无限重采样 | 高,涉及硬件损耗与人身安全 |
数据获取 | 互联网现成语料,近乎零边际成本 | 需真机采集,人力与时间成本高昂 |
泛化要求 | 分布内插值即可交付 | 必须在未见的物体、场景与任务上成立 |
时间约束 | 秒级延迟可接受 | 关键控制回路需毫秒级闭环 |
评测方式 | 静态基准、自动打分 | 需真机 rollout 或高保真仿真 |
(二)三层技术栈
综合近三年的技术演进,物理 AI 可以归纳为一个三层结构,如图 2 所示。
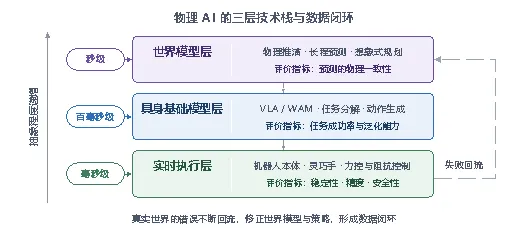
图 2 物理 AI 的三层技术栈与数据闭环
最底层是实时执行层,包括机器人本体、关节模组、灵巧手、力控与阻抗控制器。它的时间尺度是毫秒,评价指标是稳定性、精度与安全性。中间层是具身基础模型层,负责把感知与语言映射为动作序列,时间尺度是几十到几百毫秒,评价指标是任务成功率与泛化能力。最上层是世界模型层,负责对"如果这样做,世界会变成什么样"进行推演,时间尺度可以放宽到秒级,评价指标是预测的物理一致性与长程连贯性。
三层之间并非单向传递,而构成一个闭环:世界模型为具身模型提供想象的"内部试验场",使策略可以在不接触真实硬件的前提下被预筛;具身模型在真实环境中的失败回流,又成为修正世界模型的数据来源。这一闭环的存在,是物理 AI 区别于传统"感知—规划—控制"流水线的本质特征。
形式上,令 st 表示 t 时刻的世界状态,ot 为观测,at 为动作,l 为语言指令。世界模型的职责是学习状态转移的预测分布:
st+1 ~ pθ(st+1 | s1:t, a1:t)(1)
具身基础模型(策略)的职责则是在观测历史与指令条件下输出动作:
at ~ πθ(at | o1:t, l)(2)
式(1)与式(2)共同刻画了物理 AI 的双重学习目标:前者学习"世界如何运转",后者学习"我该如何行动"。二者共享表征、交替训练,正是当前主流架构的设计出发点。
三、世界模型:从视频生成到可交互的物理推演
(一)视频预测路线的得与失
当前主流的世界模型以视频生成为主要技术路线:给定一帧或若干帧画面,预测后续画面的演变。这一路线的吸引力在于数据来源极其充沛——互联网上每分钟都在产生新的视频,而每一段普通视频里都藏着物体恒存、刚性与柔性、遮挡与因果这些物理先验。
国内外的代表性工作密集涌现。英伟达在 ICRA 2026 期间推出面向物理 AI 的开放世界基础模型 Cosmos 3,采用统一的混合专家 Transformer 架构,试图把语言、图像、视频、音频、动作五种模态收进同一模型,使一个框架同时承担视觉语言模型、视频生成器、世界模拟器与世界—动作模型四种角色。智元机器人发布的 GE-Act 2.0 则被称作首个"原生"世界—动作模型:它从随机初始化开始,在具身数据上从头训练,不针对任何评测任务做微调;其自研的 CoAE 编码器能把一帧 256×384 的画面压缩成 24 个 token,仅为 DINOv3 的十六分之一,在 RTX 5090 上生成一个动作块只需 104 毫秒。
视频预测路线已经初步展现出对基础物理规律的把握。根据手持水杯翻转的画面推演出水杯倾斜、水流流出的过程,说明模型捕获了重力与流体的大致行为。但其短板同样明显:物理幻觉(physical hallucination)——画面中物体凭空消失、水流穿透桌面、刚体穿模——至今仍是顽疾。这类错误不是分辨率问题,而是模型缺乏对守恒律与接触约束的显式表征。
(二)潜在空间与显式物理约束
针对像素空间预测的固有缺陷,研究者提出两条改进路径。
第一条是转向潜在空间。与其预测未来的像素,不如预测未来的抽象状态。LeCun 提出的联合嵌入预测架构(Joint Embedding Predictive Architecture,JEPA)是这一思路的原型。2026 年被 ECCV 接收的 VLA-JEPA 是该路线与 VLA 结合的代表:它以 Qwen3-VL 作为视觉语言骨干,视频帧经 V-JEPA2 编码为世界状态表征,一个可学习的潜在动作 token 表示状态之间的转移,预测器在只能看到当前状态与动作 token 的条件下预测未来潜在状态,并与目标编码器的输出对齐。关键在于,未来帧不再是模型输入而只是监督信号,这一设计封堵了信息泄漏通道,迫使潜在动作真正编码"状态为什么会变",而不是"下一帧长什么样"。该模型在 LIBERO 上取得 97.2% 的平均成功率,在引入七类分布扰动的 LIBERO-Plus 上以 78.1% 位列第一,显著高于 OpenVLA-OFT 的 69.6% 与 π0-Fast 的 61.6%。更值得注意的是其在规划效率上的代际优势:潜空间规划只需对小型预测器做若干次前向,V-JEPA 2-AC 单步规划约 16 秒即可在 RTX 4090 上完成零样本抓放,而 Cosmos 系列的扩散式规划需要数分钟,且成功率区间低得多。
第二条是引入显式物理约束。飞捷科思发布的新一代物理世界模型 Fysiverse 采用"显式物理模拟器 + 生成式渲染器"的双驱动架构:以可微分物理仿真引擎作为核心约束与因果引擎,让生成模型只负责视觉表达,而物理推演回归物理学本身。这种分工的哲学很清晰——渲染可以交给学习,因果不该交给学习。
(三)物理一致性的评测困境
世界模型是否真的"懂物理",需要可量化的度量。目前国际上有三个被引用较多的基准,情况并不乐观,见表 2。
表 2 主流物理一致性评测基准上的模型表现
基准 | 评测目标 | 最佳模型成绩 | 人类/上界 | 口径 |
VideoPhy-2 | 生成视频的物理合理性 | 21.9%(困难子集) | —(人评) | 联合达标率 |
Physics-IQ | 图像到视频的物理预测 | 23%(原始榜单) | 100(物理方差基线) | 部分自报 |
Physics-IQ | 同上(统一流水线复测) | 39.5% | 100 | 第三方复测 |
IntPhys 2 | 直觉物理理解 | 57.51% | 96.44% | 评测方自测 |
无论生成式还是预测式,当前模型对物理规律的理解在困难场景下都接近随机水平,与人类接近满分的表现存在数量级差距。这一结论为整个领域划定了清醒的坐标:世界模型可以生成以假乱真的视频,但"看起来对"与"物理上对"之间,仍隔着相当距离。
四、具身基础模型:从 VLA 到世界—动作模型
(一)双系统架构
2025 年 3 月,英伟达发布 Isaac GR00T N1,被称为全球首个开源且可完全定制的人形机器人基础模型。其架构受人类认知原理启发,采用"慢思考 + 快思考"的双系统设计,如图 3 所示。
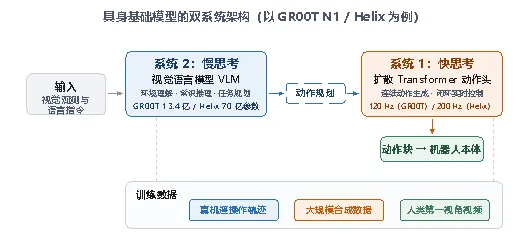
图 3 具身基础模型的双系统架构(以 GR00T N1 为例)
系统 2(慢思考)由视觉语言模型承担,基于 NVIDIA Eagle 与 SmolLM-1.7B 构建,负责解释环境与语言指令、进行常识推理并生成高层动作规划。系统 1(快思考)是一个扩散 Transformer,负责把系统 2 的规划转化为精确、连续的运动指令,闭环控制频率最高可达 120 Hz。公开的 GR00T-N1-2B 检查点总参数量约 22 亿(其中视觉语言部分 13.4 亿),在 L40 GPU 上采样 16 个动作仅需 63.9 毫秒,足以支撑实时控制。值得注意的是,两个系统并非简单拼接,而是在后训练阶段被联合优化。
同一时期,Figure AI 的 Helix 采用了同构思路但参数分配迥异:系统 1 是约 8000 万参数的视觉运动策略,运行频率高达 200 Hz,可同时控制 35 个自由度(含手指、手腕、躯干与头部);系统 2 则是 70 亿参数的视觉语言模型,训练数据约为 500 小时遥操作演示。Helix 的两个纪录值得一提:它是首个能同时在两台机器人上运行的 VLA,使机器人可以在共享的长程操作任务中协作;其后续版本 Helix 02 把控制扩展到全身,在一次演示中自主完成了整套厨房洗碗机的装载与卸载,全程 4 分钟无中断、无重置、无人工干预。谷歌 DeepMind 则于 2025 年 3 月把 Gemini 2.0 多模态模型扩展出物理动作输出能力,形成 Gemini Robotics。
(二)动作生成的范式迁移
在动作表示的层面,领域经历了一次明显的范式迁移。
早期做法是把连续动作离散化为 token,交给自回归 Transformer 逐词预测,代表工作如 RT-2 与 OpenVLA。这条路线的优点是复用了语言模型的训练基础设施,缺点是推理需逐 token 串行生成,频率低,且在精度要求高的连续控制上容易出现量化误差。
新一范式的代表是流匹配(flow matching)与扩散策略。以 π0 及 π0.5 为例,模型不直接回归动作,而是学习一个把噪声输运到动作分布的速度场,用少步积分即可生成整段动作块:
L(θ) = E[ || vθ(aτ, τ, c) - (a1 - a0) ||2 ](3)
其中 a0 为噪声样本,a1 为目标动作块,τ 为插值时间,c 为观测与语言构成的上下文。这一形式使模型可以在单次前向中并行输出整个动作块,兼顾精度与频率。实测数据显示,π0 在 LIBERO 上取得 94.2% 的平均成功率,π0.5 提升至 96.9%,显著高于自回归的 OpenVLA(76.5%)。
(三)世界—动作模型的崛起
2026 年最显著的变化,是"世界—动作模型"(World Action Model,WAM)成为该领域的新命名。传统 VLA 是"看到什么就做什么",本质是条件反射式的模式匹配;WAM 多走一步——先预测"这样做下去世界会变成什么样",再决定动作,这一步之差把机器人从条件反射推向谋定后动。
在 RoboTwin 2.0 的 50 个双臂仿真任务榜单上,这一差距被量化得相当清晰:榜首几乎被 WAM 类方法垄断,Next Forcing、LingBot-VA、Fast-WAM 等模型的清洁/随机化平均成功率在 91.9% 至 94.1% 之间,而 π0.5、X-VLA、π0 等纯 VLA 方法分布在 65.9% 至 82.7% 之间。更有信息量的两个结构性规律是:其一,WAM 与 VLA 的差距随任务时域延长而扩大,在单步任务上领先约 3.2 个百分点,在三步任务上则扩大到 8 至 9 个百分点,说明时序记忆存在复利效应;其二,差距在随机化条件下进一步拉大,π0.5 从清洁到随机掉 5.9 个百分点,而顶级 WAM 的跌幅不超过 1.5 个百分点,说明视频先验吸收了视觉扰动。
技术路线也在快速收敛。智元与上海创智学院联合发布的 τ0-WM 在约 27300 小时的异构语料上预训练(含 17800 小时真机遥操作、6500 小时 UMI 采集与 3000 小时第一人称人类视频),模型仅 50 亿参数,却把动作生成、视频预测与任务评估统一进一个共享预测表示;推理时模型采样多个候选动作,用动作条件视频模拟器"预演"未来,再挑出最有前景的一条,构成"提议—评估—修正"的闭环,如图 4 所示。海外方面,Riemann-1.0 用超过 20 万小时的交互数据,把可执行策略与多本体视觉世界模拟器融进同一个自回归模型,在 RoboTwin 2.0 上取得 94.3%、在 LIBERO 上取得 99.0% 的成功率。表 3 汇总了若干代表性模型。
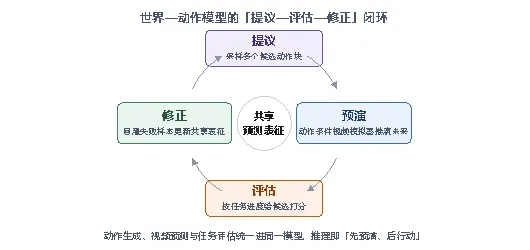
图 4 世界—动作模型的"提议—评估—修正"闭环
表 3 代表性具身基础模型对比
模型 | 机构 | 规模 | 核心架构 | 关键数据 | 代表性结果 |
OpenVLA | 斯坦福等 | 70 亿 | 自回归 VLA | Open X-Embodiment | LIBERO 76.5% |
π0 | Physical Intelligence | 30 亿 | 流匹配 VLA | 跨本体遥操作 | LIBERO 94.2% |
π0.5 | Physical Intelligence | 30 亿 | 流匹配 VLA | 异构混合数据 | LIBERO 96.9% |
GR00T N1 | 英伟达 | 22 亿 | 双系统 + 扩散 Transformer | 真机 + 合成 + 互联网视频 | 实时闭环 120 Hz |
Helix | Figure AI | 0.8 亿 + 70 亿 | 双系统 | 约 500 小时遥操作 | 全身 35 自由度 200 Hz |
VLA-JEPA | 中科大等 | — | 潜在世界模型 VLA | 22 万人类视频 + 7.6 万轨迹 | LIBERO 97.2% |
τ0-WM | 智元 / 上海创智学院 | 50 亿 | 世界—动作模型 | 2.73 万小时异构语料 | 统一预测表示 |
Riemann-1.0 | — | — | 策略与模拟器统一自回归 | 20 万小时以上交互 | LIBERO 99.0% |
DobotWAM | 越疆科技 | — | 世界—动作模型 | 三维空间理解 + 数据闭环 | LIBERO 99.25% |
五、数据引擎:从倒置金字塔到第一视角学习
(一)倒置金字塔
物理 AI 面临的第一道墙是数据。数字 AI 可以近乎零成本地吞下整个互联网,而机器人数据的采集需要真机、人力与时间。传统上,一名熟练操作员录制一段高质量示范动作大约需要一分钟,这使大规模推广极其困难。
业界的应对之道被形象地概括为"倒置金字塔"工作流,如图 5 所示。其逻辑是:专有机器人数据在多样性上注定无法与互联网竞争,不如先"借用"互联网中现成的物理常识,再逐层过滤、合成与提纯,最终蒸馏成任务对齐、紧凑的真实世界数据。
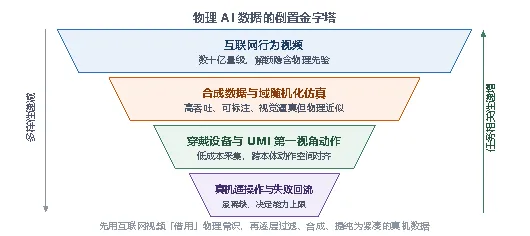
图 5 物理 AI 数据的倒置金字塔
金字塔顶端是数十亿量级的互联网行为视频,用于解锁隐含的物理先验;向下依次是中继层的合成数据与穿戴式设备(如通用操作接口 UMI)采集的第一视角动作,以及核心层的真机部署与失败回流产生的长尾数据。这一结构的关键不在于总量,而在于跨本体迁移能力——谁能把不同机械臂、不同夹爪的经验压缩进一个通用动作空间,谁就掌握了规模效应的密钥。
(二)从遥操作到人类第一视角
2026 年被一线团队普遍视为"人类学习"(AnthroLearning)的元年。行业开始从"遥操作 + 仿真数据"的路径,转向以人类第一视角视频为核心的数据体系。其底层逻辑是"第一性"的:机器人未来也是通过自身的感知系统与世界交互,而第一视角数据天然记录了这一过程,不仅包含动作结果,还隐含了空间关系、时序逻辑与物体的物理属性。
实证效果相当直接。英伟达在 GR00T N1.7 上引入了 EgoScale 数据集,包含超过两万小时、覆盖二十余个任务类别的带传感人类第一视角视频;实测表明,把该类数据从 1000 小时增加到 20000 小时,平均任务完成度提升超过一倍,英伟达称之为"机器人灵巧度的第一条缩放律"。更具冲击力的一项对照实验是:在 DreamZero 的评测中,仅用 12 分钟的人类第一视角视频做联合训练(视频中不含任何动作标签),即把未见任务上的表现从 38.3% 提升到 54.3%。原因在于纯视频数据可以直接嵌入联合目标的视频一侧,无需动作标注即可贡献梯度。
(三)合成数据与缩放律
在真实数据昂贵的前提下,合成数据成为放大器。英伟达的 Isaac GR00T Blueprint 基于 Omniverse 与 Cosmos 构建,只需少量人类示范即可生成海量合成数据集:开发者在 11 小时内可生成超过 78 万条合成轨迹,相当于 6500 小时、约九个月连续人类演示的数据量。把合成数据与真实数据混合训练后,GR00T N1 的性能相比仅用真实数据提升约 40%。GR00T-Dreams Blueprint 更进一步,使 GR00T N1.5 的开发仅用 36 小时即可完成,而纯人工数据收集路线需要近三个月。
缩放律的信号也开始在具身领域出现。智元的实验显示,把训练数据从 300 小时拉升到 3 万小时(100 倍),机器人在陌生场景零样本测试中可完成的精细任务从 39 项增至 76 项——折叠毛巾、嵌套纸杯、插花这些此前完全无法理解的动作,在数据规模足够时"突然开窍",如图 6 所示。Generalist 发布的 GEN-0 被业内视为标志性事件:随着预训练数据与算力持续增加,模型在多任务场景中的性能提升呈现稳定且可预测的趋势,并开始出现跨任务迁移能力。若这一规律成立,竞争逻辑将随之改变——决定系统上限的不再是机器人能完成多少动作,而是模型能否形成对物理世界的统一表征。经验上,这一关系常被写作幂律形式:
L(N) = L∞ + (Nc / N)α(4)
其中 N 为数据或算力规模,L∞ 为不可约误差下界,Nc 与 α 为拟合常数。该式提醒我们:缩放律保证的是"投入有回报",而非"投入即通用",不可约误差下界恰恰对应那些必须由架构或归纳偏置补足的能力。
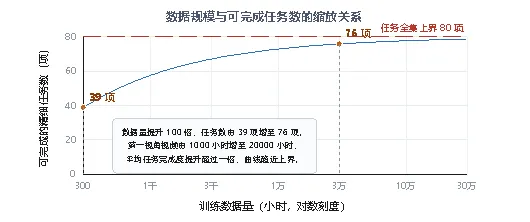
图 6 数据规模与可完成任务数的缩放关系
六、仿真到现实:迁移技术的进展
(一)并行物理引擎
仿真到现实(sim-to-real)迁移是物理 AI 的老问题,2026 年出现了基础设施级的突破。英伟达联合谷歌 DeepMind 与迪士尼研究院开发的 Newton 开源物理引擎,基于 Warp 框架构建,专为机器人学习优化,并兼容 MuJoCo 与 Isaac Lab 等仿真框架。双方合作的 MuJoCo-Warp 预计可将机器人机器学习负载加速 70 倍以上,并通过 DeepMind 的 MJX 开源库与 Newton 同步开放。
这一进展的意义不止于速度。真正的价值在于:当仿真吞吐提升两个数量级,策略搜索与域随机化才能从"采样几百条轨迹"扩展到"采样数百万条轨迹",从而使强化学习在复杂接触任务上变得可行。此外,英伟达、谷歌 DeepMind 与迪士尼研究院还计划让 Newton 支持迪士尼自研物理引擎,用于下一代娱乐机器人。
(二)域随机化与系统辨识
随机化是弥合仿真与现实差距的主要手段。其基本思想是不去精确辨识真实世界的单组参数,而是让策略在整个参数分布上都被训练到稳健。形式化地,若仿真参数记为 ξ(如质量、摩擦系数、延迟、光照),则策略优化目标为:
θ* = argminθEξ ~ P(ξ) [ L(πθ, ξ) ](5)
其中 P(ξ) 为参数先验分布。这一目标迫使策略学会"不依赖任何特定参数"的运动方式,从而在参数漂移时仍能工作。图 7 给出了仿真到现实的主要误差来源与对应缓解手段。
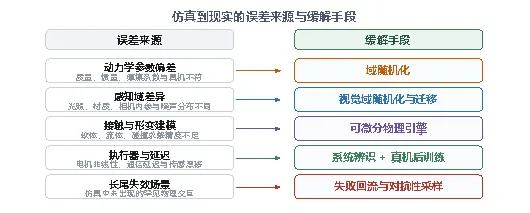
图 7 仿真到现实的误差来源与缓解手段
需要指出的是,域随机化并非银弹。过度随机化会使策略变得过度保守,在真实环境中失去效率;随机化范围过窄则无法覆盖真实分布偏移。当前更受青睐的做法是"仿真预训练 + 真机后训练"的两段式配方:先用大规模随机化仿真获得泛化的运动先验,再用少量真机数据做对齐微调。GR00T N1 的成功部署正是这一配方的直接体现——1X Technologies 在其 NEO Gamma 机器人上,仅用少量后训练数据即完成了策略落地。
七、评测体系:从单点成功率到泛化度量
评测是领域成熟度的镜子。物理 AI 的评测体系在近两年经历了从"单点成功率"到"泛化能力"的重心转移,而这一转移本身揭示了模型能力的真实边界。
LIBERO 长期是 VLA 方向最通行的基准,涵盖超过 130 个任务,覆盖空间关系理解、物体泛化、目标指令理解与长时序执行四个套件。该基准上,OpenVLA 为 76.5%、π0 为 94.2%、π0.5 为 96.9%、OpenVLA-OFT 为 97.1%、Cosmos Policy 与 LingBot-VA 达到 98.5%,而越疆科技的世界—动作模型空弈 DobotWAM 报告了 99.25% 的平均成功率,在 LIBERO-Object 套件上达到满分。另有工作以仅 1 条轨迹预热、结合在线强化学习后训练,在四个套件上取得 99.9% 的平均成功率。
问题恰恰在于,这一基准已经饱和。当几乎所有强模型都挤在 95% 以上,排行榜的区分度便趋于消失——这本身就是最强的信号:真正有判别力的评测已经转向泛化能力,而倍数级的差距恰恰存在于那里。
LIBERO-Plus 正是为此设计的扩展基准,它在标准任务上叠加七类分布扰动:相机、机器人本体、语言、光照、背景、噪声与布局。第三方复测的结果极具警示意义,见表 4 与图 8。
表 4 LIBERO 与 LIBERO-Plus 上的性能衰减(第三方复测)
方法 | 类型 | 标准分 | 扰动后 | 跌幅 |
OpenVLA | 自回归 VLA | 76.5% | 15.6% | -79.5% |
WorldVLA | 统一 VLA + 世界模型 | 81.8% | 25.0% | -69.5% |
π0 | 流匹配 VLA | 94.2% | 53.6% | -43.1% |
π0.5 | 流匹配 VLA | 96.9% | 80.7% | -16.7% |
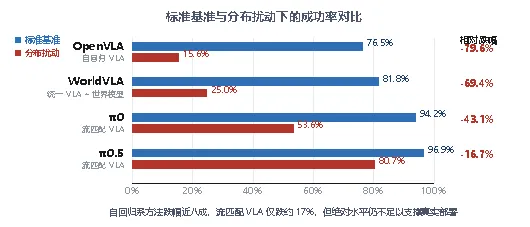
图 8 标准基准与分布扰动下的成功率对比
两个规律值得强调。第一,扰动下的排名与标准基准不一致:自回归系方法跌幅接近八成,而 π0 系仅跌 16.7%,说明标准基准的高分可能高度依赖于对特定视觉分布的过拟合。第二,引入世界模型统一训练带来的增益在扰动下保留得相对较好,但绝对水平仍不足以支撑真实部署——即便表现最好的 π0.5,在扰动条件下也只有八成的成功率。
为逼近真实场景,评测正沿着两条路径演化。一条是提高仿真任务的多样性与双臂复杂度,如 RoboTwin 2.0 提供了 50 个双臂任务;另一条是直接回到真机,RoboArena 采用众包双盲 A/B 评测,在七家机构间对 DROID 机器人上的策略进行对照,被称为机器人领域的"竞技场"。截至 2026 年 6 月,该榜单上 Spirit AI 的 Spirit v1.6 与英伟达的 Cosmos3-Nano-Policy 分列前两位。此外,Ai2 的 MolmoSpaces-Bench 等新一代泛化基准也在快速建立。
八、关键挑战
(一)数据墙与跨本体异构
物理 AI 与硬件本体深度绑定:不同机器人搭载的传感器、关节模组各不相同,导致严重的数据异构。为一款设备采集的动作数据,往往无法直接用于另一款设备。如何构建通用数据集、训练跨平台通用模型,是行业普遍难题。当前的缓解路径包括统一动作空间表征、潜在动作学习以及跨本体联合训练,但距离"一次训练、处处可用"仍有距离。
(二)物理幻觉与因果缺失
如第三节所述,世界模型在困难物理场景下的表现接近随机。根本原因在于,当前主流方法以像素重建或表征对齐为训练目标,而守恒律、接触约束、因果方向这些结构并不在目标函数中显式出现。显式物理约束与可微分仿真器的引入是一条有希望的方向,但其与生成式模型的融合仍处早期。
(三)长程任务与误差累积
操作任务的时域越长,误差累积越显著。RoboTwin 2.0 上 WAM 相对 VLA 的优势随任务步数扩大(从 3.2 个百分点增至 8 至 9 个百分点),从反面说明长程一致性是当前架构的软肋。要支撑数分钟乃至数十分钟的连续作业,模型需要具备可回溯的记忆机制与失败自恢复能力。
(四)算力约束与产业生态
算力是部分地区发展物理 AI 的主要短板。高端算力芯片仍受到外部制约,而物理 AI 对算力的需求集中在两个环节:一是大规模预训练,二是高吞吐仿真采样。国产软硬件生态的完善、以及对国产 GPU 的深度适配,正在成为产业自主可控的关键变量。与此同时,算法专利审查困境、仿真数据与训练模型的资产权属模糊、侵权责任认定复杂三类知识产权难题也随商用推进而凸显。
(五)安全验证与评测标准化
与数字 AI 不同,物理 AI 的错误直接作用于物理世界。这要求建立覆盖硬件失效、感知退化、人机共处的安全验证体系。目前该领域既缺乏统一的测试协议,也缺乏公认的失效模式库。当机器人在产线上以 99% 以上的成功率连续作业数千小时时,剩余 1% 的失败如何被预见与兜底,仍是开放问题。
九、趋势展望
综合上述进展,可以对未来两到三年作出几点判断。
第一,架构将走向统一。世界模型、视觉语言模型、视频生成器与世界—动作模型正在被压缩进同一个多模态骨干。"世界动作模型"这一命名本身,已经预告了世界模型与策略模型的合流。英伟达预告的 GR00T N2 采用全新的世界动作模型架构,据称在陌生环境中执行新任务的成功率可达当时主流 VLA 的两倍以上,计划于 2026 年底发布。
第二,数据范式将围绕第一视角重组。人类第一视角视频提供了唯一具备互联网级规模、且携带物理先验的数据源。若其与缩放律结合,具身智能有望复现大模型曾经历的"能力涌现"曲线。与之配套的,是低成本采集硬件(手持夹爪、穿戴式设备、UMI)与自动标注管线的成熟。
第三,落地将沿分层路径推进。业界的共识是从工业切入、经商业服务过渡、最终进入家庭。工业场景任务价值高、需求明确、数据质量好,是具身智能走向真实世界的第一块试金石。已有案例显示,机器人可在动力电池产线上承担高压测试插头插接等复杂工序,作业成功率稳定在 99% 以上。
第四,评测将决定技术走向。当标准基准饱和,泛化能力、扰动鲁棒性、长程一致性与安全边界的度量,将成为区分模型优劣的核心标尺。图 9 给出了物理 AI 的能力现状与关键挑战之间的关系。
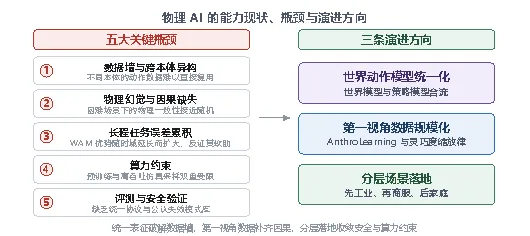
图 9 物理 AI 的能力现状、瓶颈与演进方向
最后需要强调,物理 AI 与生成式 AI、智能体并非替代关系,各类 AI 形态将在不同场景中长期共生。物理 AI 是人工智能发展的高阶形态,但它的成熟不会由某一次单点突破宣告,而将由一连串可复现的工程进展累积而成。从"能看懂"到"能干活",这一公里或许不需要奇迹,需要的只是把每一层都做扎实。
参考文献
[1] 徐凯. 世界模型:物理 AI 的核心引擎[R]. 中国科学院工业人工智能研究所物理智能团队, 2026.
[2] 张立华. 物理 AI 技术瓶颈是完整闭环的基础设施[R]. 2026 世界人工智能大会物理智能创新生态论坛, 2026.
[3] NVIDIA. NVIDIA Announces Isaac GR00T N1 — the World's First Open Humanoid Robot Foundation Model — and Simulation Frameworks to Speed Robot Development[EB/OL]. NVIDIA Newsroom, 2025-03-18.
[4] NVIDIA. Project GR00T: 人形机器人通用基础模型[EB/OL]. GTC 2024, 2024-03-18.
[5] NVIDIA. Isaac GR00T N1.6 与 Cosmos Reason 发布[EB/OL]. CoRL 2025, 2025-09.
[6] NVIDIA. Isaac GR00T N1.7 与 GR00T N2 预告[EB/OL]. GTC 2026, 2026-03.
[7] NVIDIA. NVIDIA Cosmos 3 开放世界基础模型[EB/OL]. ICRA 2026, 2026-06.
[8] NVIDIA, Google DeepMind, Disney Research. Newton: An Open-Source Physics Engine for Robotics[EB/OL]. 2025.
[9] Figure AI. Helix: A Generalist Vision-Language-Action Model for Humanoid Robots[EB/OL]. 2025-02.
[10] Google DeepMind. Gemini Robotics: Bringing AI into the Physical World[EB/OL]. 2025-03.
[11] Physical Intelligence. π0: A Vision-Language-Action Flow Model for General Robot Control[J]. arXiv preprint, 2024.
[12] Physical Intelligence. π0.5: A Vision-Language-Action Model with Open-World Generalization[J]. arXiv preprint, 2025.
[13] KIM M J, et al. OpenVLA: An Open-Source Vision-Language-Action Model[C]. CoRL, 2024.
[14] 智元机器人, 上海创智学院. τ0-WM:统一动作生成、视频预测与任务评估的世界模型[R]. 2026.
[15] 智元机器人. GE-Act 2.0:原生世界—动作模型[R]. 2026.
[16] LEHMANN T, et al. ECCV 2026: VLA-JEPA — Latent World Model Pretraining for Vision-Language-Action Models[C]. ECCV, 2026.
[17] BARDES A, GARIDO Q, et al. V-JEPA 2: Self-Supervised Video Models Enable Understanding, Prediction and Planning[J]. arXiv preprint, 2025.
[18] Generalist AI. GEN-0: Scaling Laws for Embodied Foundation Models[R]. 2026.
[19] 越疆科技. 空弈 DobotWAM 具身大模型评测报告[R]. 2026-05.
[20] 星源智机器人. ω-EVA 具身交互世界模型技术报告[R]. 2026-08.
[21] 飞捷科思. Fysiverse 物理世界模型技术白皮书[R]. 2026-07.
[22] 文远知行. WeRide WITT 物理 AI 认知基础大模型[R]. 2026-07.
[23] LIU Y, et al. LIBERO: Benchmarking Knowledge Transfer for Lifelong Robot Learning[C]. NeurIPS, 2023.
[24] ROBOTWIN 团队. RoboTwin 2.0: A Scalable Data Generator and Benchmark for Bimanual Robotic Manipulation[J]. arXiv preprint, 2025.
[25] 世界机器人大会组委会. 2026 具身智能世界模型评测汇总[R]. 2026-08.
[26] 中国日报. 从"会表演"到"会干活":WAIC 2026 上具身智能更务实[N]. 2026-07-20.