ARTICLE · 1158506
规矩立住,AI 用着才不烧心
前几天我让 AI 帮我写一段回复,交代了一句「别太正式」。它交回来的东西,可太正式,太官腔了——开头「尊敬的」,结尾「谨此」,中间全是套话。
心理学有句老话,叫「别想白熊」。我们越叫一个人别想那只白熊,他就会满脑子白熊。我那句「别太正式」,在 AI 这儿是同一个理儿——你越点出那个词,它越容易反复思索那个词。
还有一次,我让它回一条工作消息,说「委婉点、别太长」。它手里没有标准,只能替我填一个「最可能的长度」,而那个长度显然不符合我心目中的预期,当然委婉更不用说了,用了是会被贻笑大方的程度。这句话同时把后面两节的事埋下了伏笔:边界没写清,验收也没标准。
上期我们聊了「说不清」,把跟 AI 说不清归成了四类。上上期我们聊过,说不清会让人烧心。这期要聊的是另一件事:有些时候我们明明说清了,它交出来的成品还是一坨。把那些烧心的事剥开看,核心常常是同一个——我们没把那些「默认省掉的东西」写出来。
模型的工作方式,是预测「下一个最可能的词」。我们漏掉什么,它就替我们填最可能的那个。我们禁止什么,它反而先把那个词激活了,再吐出来。所以「立规矩」这件事,说白了就是把那几个最常被默认掉的东西,写成字。
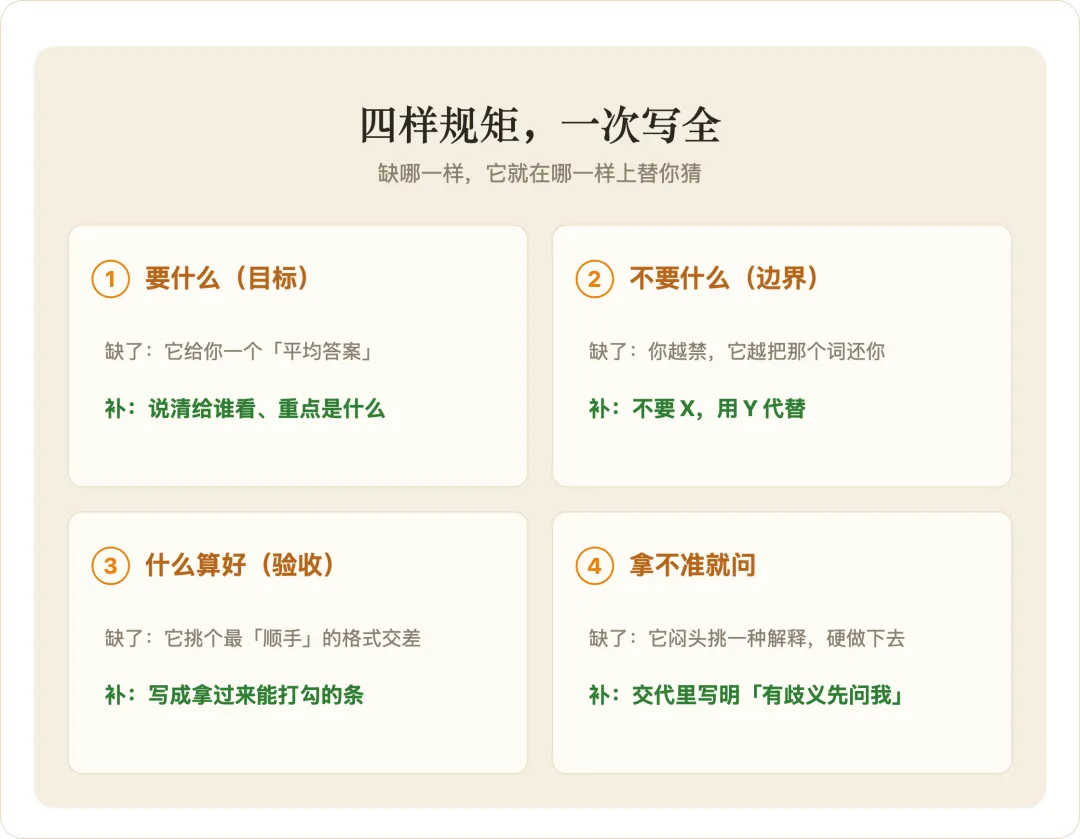
缺掉的东西其实是四样:要什么、不要什么、什么算好、拿不准就问。下面四条,全是上面那句话的推论。
01 要什么(目标)
先说「要什么」。之前我们聊过一篇,讲 AI 给我们的常常是「平均答案」——把所有人的需求搅在一起,给我们一个谁都适用的解。这一节要做的,正好是把那个平均解拽回来,变成「我的解」。
心理学家洛克和拉撒姆两位在 2002 年做过一篇综述,把三十五年的研究拢在一起看,覆盖一百多个任务、四万多个被试。得出来这样一个结论:具体、有难度的目标,就是比「尽力而为」管用。
所以「要什么」的公式很简单。把「帮我写个方案」,换成「一份给老板看的方案,重点是这周做成了哪件事儿」。
同一句话,不写目标和写了目标,差在哪里呢?不写,它给的是泛泛而谈的大纲;写了,它锁死了对象和重点。要什么,就是先把「我是谁、我要它干什么」这件事,从模糊拽到具体,这样生成的内容就会翔实很多。
小结
规矩 ①→一份给【谁】看的【什么】,重点在【哪件事】,做到【什么程度】算完。
02 不要什么(边界)
再说「不要什么」。首先声明:跟 AI 说「别写 XX」,不是标准动作,是最容易翻车的禁止方式。
这事有两派在吵。
一派是官方和论文。官方那边,大厂自己的提示词指南明确建议「说要做什么,不要只说不要做什么」——负向指令会让模型一边记着你的禁区,一边猜你到底要什么,两头顾着,反而不稳。论文那边更进一步:2025 年底一篇预印本(编号 2511.12381),用五千条否定指令、测了九个模型,从机制上证明你越说「不要提 X」,X 反而越容易冒出来。这叫讽刺性反弹,和我们开头那只白熊是同一个东西——要压住一个词,模型得先在脑子里把它激活,结果把它推到了嘴边。论文把这套现象叫「白熊效应」的机器版,还顺手放出了一组叫 ReboundBench 的测试集。两处指向同一件事:负向有副作用。
另一派是真正写提示词的一线工程师。在他们那儿,又有一股相反的经验:对那些「特定、已知会出错的坑」,负向约束反而最管用、最直接——它就拦在那儿,出不了格。
两派怎么和解?禁线可以画,尤其是工程师说的那些硬边界;但别裸画,得配个替身。官方说的「用正向代替负向」,就是那个替身,也就是类似于反义词。要分清楚:那篇预印本的价值,是警告你「裸着写负向会反弹」;「配替身能解决」,这后半句来自官方指南和工程师的实操。
为什么「不要太正式」反而容易得到官腔?就是白熊现场——你越点出那个词,它越容易碰见它。开头那件事,现在能讲通了。
所以「不要什么」的公式,是「不要 X,用 Y 代替」。这招我们之前其实用过,在讲隐私那篇——「动手前把边界写死」,是把不能说的写死。这篇是同一招的另一面,把不想要的写死。正反两面,凑齐了,
小结
规矩 ②→不要【具体的东西】;换成【替身】。(模糊的线就别画了,直接说你要什么。)
03 什么算好(验收)
第三样,「什么算好」。上上期我们聊过「烧心」——说不清、说不好,都在烧 token。还记得开头那句「别太长」吗——「多长算长」我们没说,它就替我们填了一个「最可能的长度」,而那个长度刚好偏长,一轮轮打回,烧的正是 token。这一节就是那个烧心的止损阀:把「好」写成它能照做的标准,少打回,少烧。
我们来看两篇论文。一篇是 2026 年的会议论文(LREC),测到同一件事换种写法、换个输出标准,成绩能差出 2 到 46 个 F1 点。另一篇也是 2026 年的会议论文(EACL),做了两百多次实验,发现只换输出格式、不换别的,F1 能差 40 多个点。不是模型变笨了,是我们没告诉它「好」长什么样,它只能挑一个它最「顺手」的格式——而顺手的不一定是我们要的。
把「好」写成能判断的标准。比如「结尾要有一句给老板的结论」,或者「三段,每段不超过 80 字,第二段必须有一个数字,结尾不要总结」。不是「写专业点」这种有点空的话语,尽量要拿过来就能打勾的条款。
不写标准,它交一版我们嫌不对,打回;再交一版还不对。写了标准,第一版就能对着条打勾,对的留下、不对的改。标准写清楚,一次到位,省下的就是 token,也是我们的耐心。
小结
规矩 ③→【几段】【多长】【必须出现什么】【不要出现什么(配替身)】。
04 拿不准就回来问(反向检核)
第四样,「拿不准就问」。之前我们聊过一篇,警示「别让它顺着我们说」——我们越带着观点问,它越顺着我们回答,反而把我们的偏见坐实,把我们的目标带偏了。这期反过来:上篇怕它顺着我们,这期我们逼它来问我们。同一个「顺」字,方向相反,本身就是钩子。
这节的工具,还是从那本《沟通的艺术》里。书里讲「知觉检核」——描述我们观察到的、提出至少两种可能的解释、请对方澄清。上一回,是我们拿它去问 AI,防自己自以为懂它;这一回,是逼 AI 拿它来问我们,防它自以为懂我们。同一本书的工具,方向相反,这回叫它「反向检核」。
为什么要逼它问?因为模型缺信息的时候,一般不会主动来问你,它会挑一种它觉得最可能的解释,硬做下去。一篇 2026 年的会议工作(EMNLP Findings,新近研究,未经长期重复检验)把模型的默认行为拆得很清楚:面对模糊指令,它要么闷头挑一种解释就往下做(大多数时候),要么每个问题都反问一遍(烦到我们放弃),要么问得含糊等于没问(「你想要哪种风格?」)。教它「什么时候该问、怎么问才问得准」,任务成功率就会有所提升。
所以「拿不准就问」最好是交代里明写一句:「如果我的要求有歧义,先问我,最多三个问题,别自己编造。」「最多三个」是给它装刹车,不然它反问起来没完;「别自己编造」是给它装底线,问不出来也比编一个强。
说个对比。同一个模糊需求,交给下属或者同事,他多半会先跟我们确认一句「你要的是不是这个意思」,确认了再动手;交给 AI,它默认不问,闷头挑一种理解做完,方向偏了,我们事后才发现。这一篇讲的「让它先问我」,就是把 AI 拉回那个「先确认」的习惯——差的就是那句「先问我」。
小结
规矩 ④→不确定的地方先问我,最多【N】个问题,别自己编。
05 反向校验:这套框架哪里会骗人
第一,规矩立太多,它会「迷失在中间」。长上下文里,躺在中间的信息模型最记不住——我们上上期刚引用过这个研究(Lost in the Middle)。我们啪啪列一长串规矩,真正重要的那条若卡在中间,约等于没写。规矩不是越多越好,少而准,大道至简。
第二,目标设定理论研究的是人,类比有边界。洛克和拉撒姆研究的是「人」——人有承诺,会真去够那个具体目标。AI 没有「承诺」这种东西,我们写「具体目标」它照做,但不「在乎」。所以「具体目标对人有用」,不能直接推成「对 AI 必然同样灵」,只能说:把模糊需求写具体,至少省了它猜测我们想法的那一步。
第三,这几篇关键论文都是预印本或新近会议工作——ReboundBench(编号 2511.12381)、Lost in Formatting(EACL 2026)、CIGAsk(EMNLP 2026 Findings)。方向有实验支撑,但都还没经过时间的反复检验,别把结论当定律,只能当成「目前最好的猜测」。
第四,规矩本身也会过期。平台一改规则、模型一升级,我们上个月立的规矩,这个月可能就废了。我们上上期说过「世事变化无常,有些知识是有时效性的」——规矩也得定期回看,不是一次写好就永久有效。
写在最后
回看一眼,四条规矩——要什么、不要什么、什么算好、拿不准就问——都是开头那句话的推论:把默认掉的东西写成字。而这一节的反向校验,是这套工具背面的使用说明:它也有会失灵的地方。
这里有一个能直接抄走的模板,四行填空——
四行填空 · 交代模板
① 要什么:一份给__看的__,重点在__,做到__算完。
② 不要什么:不要__;换成__(替身必须给)。
③ 什么算好:_段,每段不超过_字,必须出现__,结尾不要__。
④ 拿不准就问:不确定的地方先问我,最多_个问题,别自己编。
示例(写年终总结):① 一份给我自己看的总结,重点是今年学会了哪三件事。② 不要写成给领导汇报的口气;用平时跟自己说话那种。③ 每条后面跟一个具体的事,不说空话。④ 如果「学会的事」指不清,先问我,最多一个问题。
上期我们把「说不清」从嘴笨的锅上摘下来,现在能分了;这期把「说不好」从「它不行」的锅上摘下来,现在能写了。
关注「已知序章」,每日读书有收获:一个普通人在 AI 时代怎么学、怎么想、怎么读。
你的每一个点赞、在看、分享,都是我坚持更新的动力,感谢!❤️
参考资料
Locke, E. A., & Latham, G. P. (2002). Building a Practically Useful Theory of Goal Setting and Task Motivation: A 35-Year Odyssey. American Psychologist, 57(9), 705–717.
Anthropic. Prompt engineering overview(官方明确建议「说要做什么,不要只说不要做什么」——正向表述优于负向)。
Mann, L., Saxena, N., Tandon, S., Sun, C., Toteja, S., & Zhu, K. (2025). Don't Think of the White Bear: Ironic Negation in Transformer Models Under Cognitive Load. arXiv:2511.12381.(ReboundBench,5000 条否定指令/9 个 LLM,讽刺性反弹=白熊效应。预印本,未经同行评审。)
Lepagnol, et al. (2026). Format Matters(LREC 2026)—— 同任务换写法、换输出标准,成绩差 2–46 个 F1 点。
Ravikumar, Ibrahim & Batista-Navarro (2026). Lost in Formatting: How Output Formats Skew LLM Performance on Information Extraction(EACL 2026)—— 只换输出格式,F1 差 40 多个点。
Li, Wu & Meng(CUHK)(2026). When and How Should an Agent Clarify? CIGAsk(EMNLP 2026 Findings)—— 模型面对模糊指令的三种默认失败模式。新近会议工作。
Liu, et al. (2023). Lost in the Middle(arXiv:2307.03172)—— 长上下文中间信息最易漏,第 05 节引。
阿德勒, R. B., 普罗科特, R. F. 《沟通的艺术:看入人里,看出人外》(插图修订第 14 版,黄素菲、李恩译,世界图书出版公司,2015)——「知觉检核」perception checking。