ARTICLE · 1163407
火山引擎 EMR AI 助手接入豆包工作平台:让大数据诊断和运维更低门槛、更高效率
任务状态「成功」,作业总耗时「53秒」,但用户依旧觉得“不够快”。
过去, 针对这类 Spark 作业任务上的体感,用户可以通过火山引擎开源大数据平台 EMR 进行数据量化,作为面向 AI 时代的开源大数据平台,EMR 能提供丰富的增强型大数据组件,且 100% 兼容开源,具备极致弹性资源、存算分离架构,可覆盖迁移上云、湖仓分析、多模数据处理等多项业务场景。
随着以豆包工作平台为代表的 AI 生产力工具日益普及,越来越多的用户习惯在办公场景中以对话形式完成工作,EMR也顺势完成形态升级:用户在豆包工作平台即可一键调用 EMR AI 助手,低门槛实现针对企业大数据垂类场景的分析、运维等系列操作,同时基于在大数据领域的持续能力建设和打磨,用户还能畅享 EMR AI 助手提供的包括大数据垂类 Agent Loop 定制优化、安全防护等方面,更稳定、更高效、更安全、更精准的大数据能力。
从“切换系统”到“一次对话”:
降低用户使用的四项门槛
传统模式下,当用户觉得一个 Spark 任务“不够快”后的排查路径大概是:打开 EMR 控制台,查作业状态,翻执行日志,看资源队列,检查集群服务健康度,再结合经验判断根因。
整个过程涉及多个页面、多种指标、多条命令——每一步都需要专业知识。
但在接入豆包工作平台后,EMR AI 助手(EMR Agent)能以连接器形式出现在用户日常工作中。用户无需切换控制台,无需提前熟悉 Spark、YARN、队列、资源规格和日志检索路径,只需用自然语言描述问题,或提供作业 ID、集群、队列等关键信息,即可发起诊断。
对用户来说,EMR AI 助手能从四个维度降低使用门槛:
1、首先是入口门槛。在豆包工作平台中直接唤起 EMR Agent 能力,用户不必再单独查找诊断入口。
2、其次是使用门槛。用户只需用自然语言描述“帮我诊断这个作业”“这个队列为什么慢”等问题,连接器就能够自动调用对应诊断能力。
3、然后是知识门槛。诊断结果会把底层指标、日志和运行状态组织成可理解的结论,减少用户自行拼接多源信息的成本。
4、最后是企业级门槛。EMR Agent 通过大数据领域垂类 Agent Loop 的定制优化、安全防护、性能、准确性优化等完成垂类能力建设和打磨,给豆包工作为用户提供更稳定、更高效、更安全、更精准的大数据服务能力。
从“看指标”到“得结论”:
53秒耗时压缩到10秒的极致体验
EMR AI 助手接入豆包后,可以将原本“人工查指标、翻日志、判断根因、再给建议”的全链路流程,压缩成一次简单对话;同时,对于常见的作业失败、运行慢、资源使用不合理、队列拥塞、集群服务异常和告警排查情况,用户也能够更快获得结构化诊断结论。
比如,针对反馈的“作业总耗时53秒还不够快”,用户通过和 EMR AI 助手自然语言对话就能直接开启任务诊断,并能清晰找准两个影响任务速度的问题点:
1、53秒中有44秒(占比83%)的时间花在 Pod 调度和容器启动等冷启动环节,真正计算时间仅占据6秒;
2、整个作业过程中资源严重超配,8 vCPU / 31.8GB 的内存使用率不足 0.01%,浪费约 75%。
除了陈列影响因素外,EMR AI 助手的诊断结论还能为用户提供可执行的优化建议:可将 Driver/Executor 规格下调至 2C/4G 量级;高频查询改用预拉起的 Spark SQL Warehouse 计算组。
数据显示,经过优化后方案可将CU消耗降低 约75%,任务耗时也能从 53秒 缩短至 10秒 左右,用户体感作业效率得到极大提升。
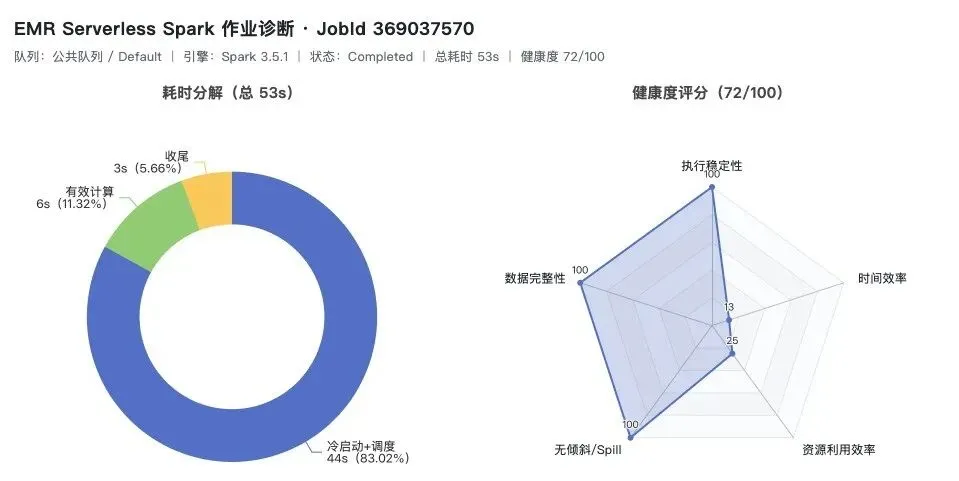
此外,EMR AI 助手输出的诊断结果还支持在豆包工作平台中复制、转发或继续追问,便于研发、运维和业务等不同岗位的员工协同处理。
对比传统的排查流程,诊断不仅更及时和更完整——用户一旦发现异常即可随时发起,减少等待人工支持和跨系统排查的时间,而且结果可覆盖任务状态、资源使用、执行耗时、失败信息和优化建议;在进一步优化上还能给予更多可落地执行的策略补充,不只是向用户讲清楚“发生了什么”,而是能给出包括资源调优、运行方式调整、队列治理和服务检查等在内的全链路建议,确保用户能够看得懂、知道怎么做。
从“通用”到“专业”:
优选深耕大数据场景的引擎底座
相较于市场上涌现的通用型诊断助手,EMR AI 助手的核心优势在于它的专业性。
从一定程度上来说,企业场景下的大数据诊断并不属于通用对话,它需要理解 Spark 执行计划、YARN 资源调度、HDFS 存储状态、ZooKeeper 服务健康;还需要知道一个慢任务该先查冷启动还是数据倾斜,一个报错该先看日志还是先看配置。
其中不仅涉及到大数据领域的专业知识,还需要有足够多的且历经实践的解决方案和参考样例沉淀,所以通用型诊断助手或许可以回复简单提问,但面对“ Spark 作业耗时异常”这类需思考并回溯诊断过程并逐步拆解的问题时,是否有足够的专业知识和实践经验,将直接决定向用户输出的回复和解决方案是否可用。
火山引擎开源大数据平台EMR在字节跳动内部已经实现 100% PrestoSQL、85% SparkSQL 任务覆盖,并在互联网、电商零售、金融科技等多个行业落地获得实效:有境科技核心任务耗时缩短 40%、算力成本减半;米漫科技资源消耗下降超 60%、精准营销任务提速 20%+……
而作为 AI 时代EMR形态的升级,接入豆包工作平台的EMR AI 助手拥有同款的大数据场景专业能力,用户在豆包工作台即可一键复用。
从“看别人用”到“自己能用”:
只需三步
目前,EMR AI 助手已经上架豆包工作台,用户只需三步骤,就能轻松调用。
第一步:打开豆包工作,点击左上角的插件·技能·伙伴,点击研发运维分类,点击火山引擎 EMR AI 助手的安装。
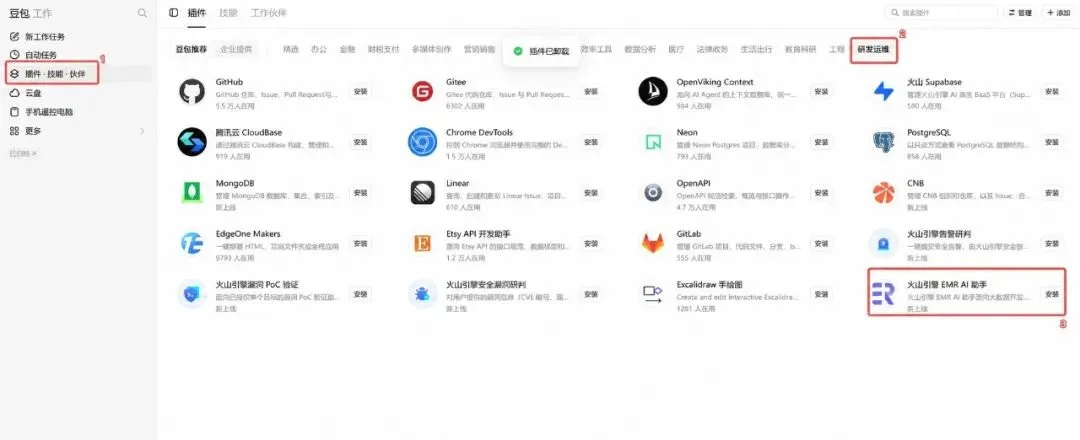
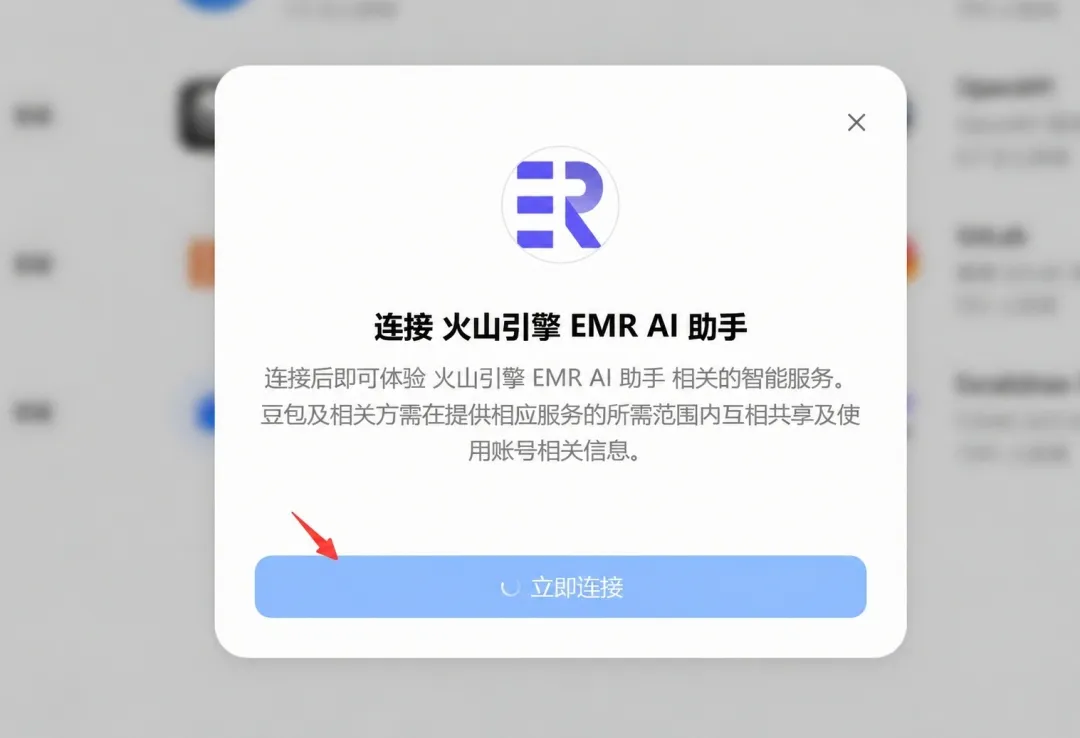
第二步:在弹出的页面中点击立即连接,浏览器跳转火山官网登录后回到豆包。
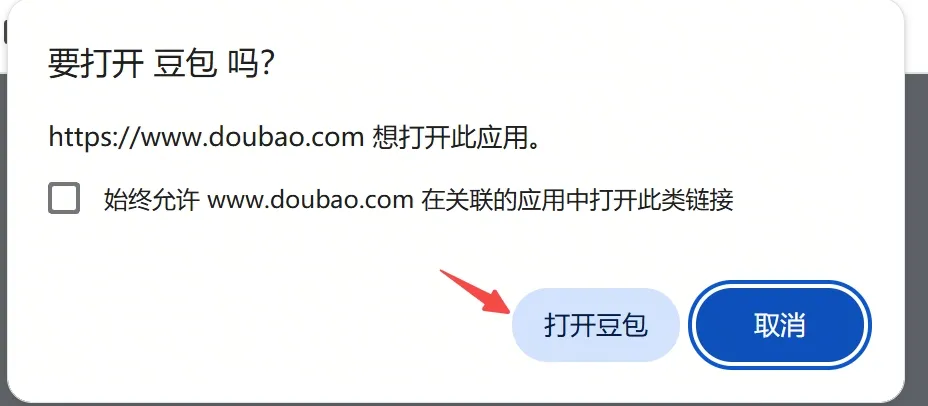
第三步:新建一个工作任务,注意到插件中已经包含 EMR Agent 连接器,此时即可进行调用。
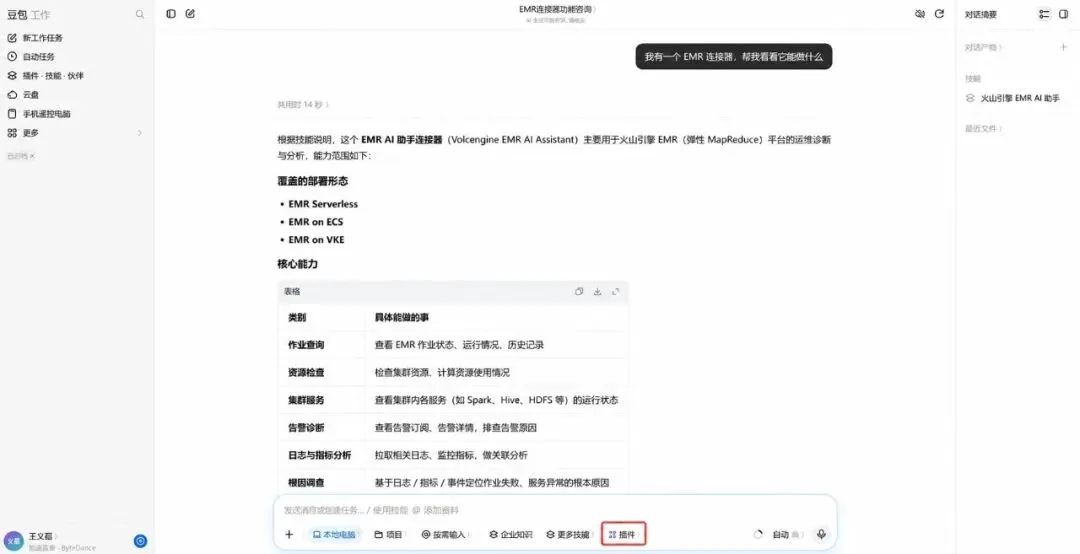
当越来越多的用户选择豆包工作平台作为日常办公的伙伴,EMR AI 助手也将更专业的大数据场景能力提供给更多用户:从实际问题出发,一句话就能调用专业的数据引擎诊断能力。
全链路诊断+问题阐述+调优方案输出,帮助用户更低门槛、更高效地完成任务排查和优化,将更多精力从“找问题”转移向“做决策”,进一步创新 AI 时代下的企业生产力。