ARTICLE · 1165513
REA 能让 AI 拆开任何软件,但复刻的产品只有 45% 能用
一周涨了约 12 万星,GitHub Trending 榜首连坐五天,连 A 股的复盘文章都把它和网络安全板块的异动写在一起。
一个开源项目,火到这个程度。
但真正该看的不是这些。是另外两组数字,并排放着。
一组来自它的完整重建仓库:55 个函数、45,380 次与原代码的比对、33 个函数编译后字节一致。另一组来自那个复刻 Photoshop 的项目,写在它自己的 roadmap 里:"可用于真实工作,约 45%"。
同一套工具,一端能做到逐字节一致,一端是"还不能拿去干活"。这中间的落差,才是这轮热闹里没被讲清楚的事。
先校准一件事:REA 不是一个大模型,也不是一个新的破解工具。
全称 Reverse Engineer Anything,作者是 GitHub 上的 morluto,MIT 协议。形态是 MCP server 加命令行工具,装法只有一行:npx rea-agents setup。
它做的事其实只有三件:
▪接引擎。把 Hopper、Ghidra、IDA、JADX、Binwalk 这些各自为政的逆向工具,收成一个入口。以前人要自己挑工具、学 API、在程序之间搬证据,现在由 Agent 按目标类型自己选。
▪管状态。从反编译切到抓包、再切回来,线索不断。这是它相对那些更早的同类插件的真正增量。
▪留证据。每条结论都带出处——文件摘要、字节区间、JSON 指针,并且强制标注"这次没查实什么"。
第三条最容易被忽略,但它决定了这东西和"让模型猜"是不是一回事。逆向工程天生跟不完整的信息打交道:二进制里没有注释,符号常被剥掉,很多地方只能靠上下文推。高手和外行的差别,往往不是谁猜得准,而是始终分得清哪一步是看见的、哪一步是推的。REA 把这条自觉写进了输出格式。
把产出摊开看,三档之间的落差大得不像同一个工具干的。
一档是单函数级,已经能做到逐字节可验证。 官方 showcase 那个 DX-Ball 音效声像函数,还原出的 C 代码通过了 3,205 组行为比对,用旧版编译器重放,生成的机器码和原程序 63 个字节完全一致。更要紧的是它背后那个完整重建仓库:55 个持续维护的 C 函数、45,380 次比对、33 个函数编译后字节匹配——这个仓库是 10 月 7 日建的,就在爆发期里。
二档是算法和架构级,功能等价、实现自写。 一款验证器 App 的六位验证码,被还原成可手动调时间的网页,133 组测试一致;Notion 的剪贴板桥,从渲染进程一路追到主进程。这一档给的不是代码,是"它到底怎么运转"的说明书。
三档是完整软件级,能跑通,但离能用很远。 这一档的数字最有信息量:
保真度也是实测出来的:那个 Photoshop 复刻对 309 个 PSD 测试文件能原样重存 307 个,但 170 个参考文件里只有 115 个渲染逐像素一致;Patch、Content-Aware Move 这些常用工具还缺着,生成式 AI 那一层基本是零。
最能说明问题的是它自己的 roadmap——10 月 3 日那句"再花 140 到 220 个 Agent 小时就能到 95% 对齐",几天后被它自己标成了"过于乐观"。
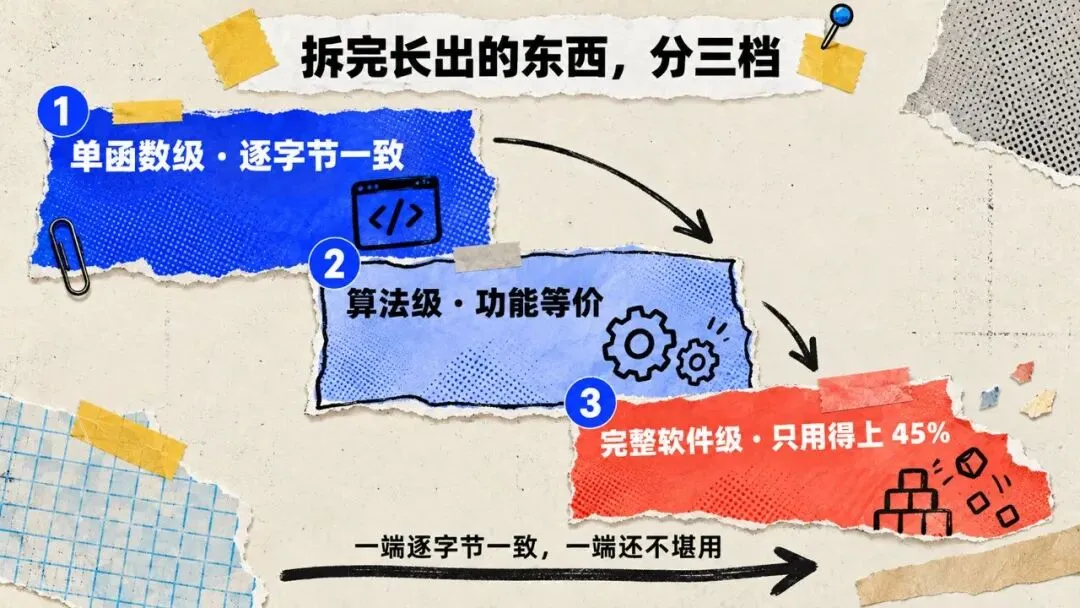
▲ 一端是逐字节一致,一端是自评 45%
为什么会这样,其实不难理解。 拆开一个功能,你面对的是一段边界清晰的逻辑;做一个产品,你面对的是一堆没人会写进文档的东西——十年前的旧文件格式、用户已经形成的操作习惯、异常情况下的表现、以及"别人都不这样但我这样会出事"的经验。前者可以靠比对验证,后者只能靠时间和用户教。
复刻一个功能的边际成本,已经塌到了接近零;复刻一个产品的边际成本,一点没动。前者是几百个 Agent 小时,后者是十年攒下来的边缘情况、文件兼容性和肌肉记忆。
现在把反方的声音也摆上来。
专业逆向圈对这轮热潮并不买账。逆向工程教材《Practical Reverse Engineering》的合著者 Elias Bachaalany,转发 REA 的推介时只回了一个词:炒作。他的意思是,让 AI 接上逆向工具,Ghidra MCP、IDA MCP 这些项目一年多前就在做了。调试器 x64dbg 的作者 Duncan Ogilvie 也说,他不认为给模型暴露更多工具就能让它表现更好——而已有用户抱怨 REA 塞给 Agent 的工具说明太长,很快就把上下文挤满。
更难啃的是加固。法国安全团队 Quarkslab 今年花了几周,把模型放进沙箱去破几个层层加固的二进制文件,结果是没有一个样本被真正破解——模型会绕道、会挑最容易的路径,最后交出一份看着像样、其实是编出来的报告。反方那边同样有料:有论文用符号仿真,在没有大模型的情况下,照样还原出了商业混淆器保护下的控制流图。攻防两边,谁都没能一把掀翻对方。
还有一类东西它怎么都碰不到:跑在机房里的那一半。社交关系链、风控模型、推荐算法,全在服务端。能拆开装在自己电脑上的客户端,拆不开别人服务器里的逻辑。
这里还有一个反讽值得记住。这场"AI 拆软件"的浪潮里,跑得最快的那个复刻项目,公开说自己"特别小心不碰 Ghidra"——因为一旦反编译,它的净室主张就失效了。
净室是软件行业用了几十年的老办法:一组人拆对方的产品、只写功能说明书,另一组没见过对方代码的人照着写,中间隔一道墙——那道墙就是日后打官司时的证据。而现在,同一个 Agent 既读反编译结果、又写新代码,墙没了。所以真正跑得动的人,反而绕开了拆。
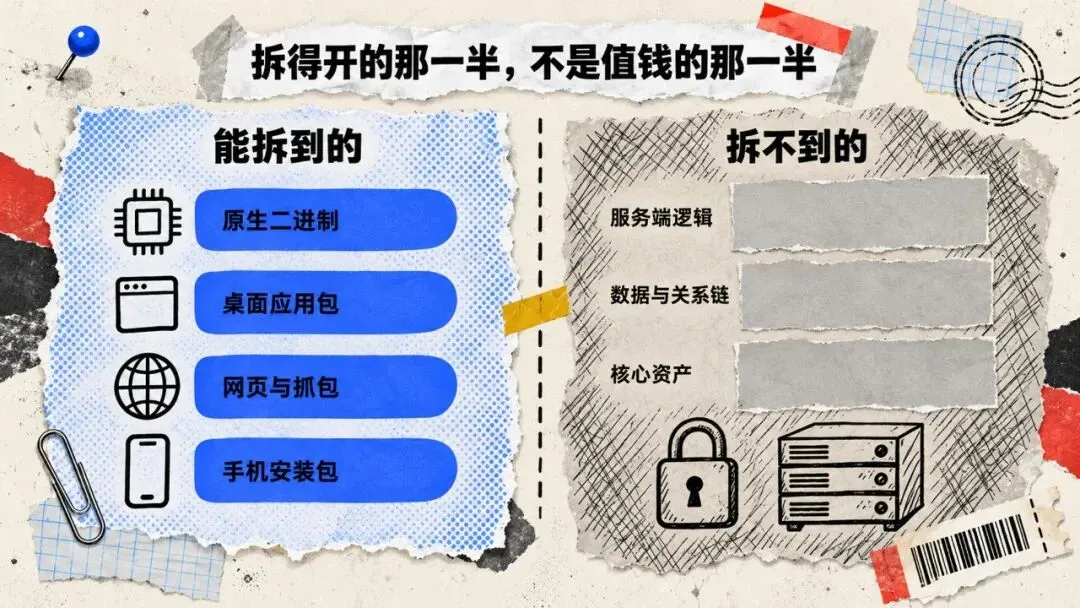
▲ 拆得开的那一半,不是值钱的那一半
最后说影响。它没有让软件变得可复制,它让软件的"功能层"变得可替代。
而"功能层"这三个字,恰好是过去二十年里最容易被当成"产品"的那一层。功能一旦能被拆、能被复刻,它就不再是壁垒。留下来的是三样东西:积累的数据、服务端的逻辑、迭代的速度。
受影响最直接的,不是那些体量大的国民级应用,是功能单一的付费小工具——用户买它往往只为一个任务,替代品只要那一半够用,就有机会撬走续费。企业软件反而更稳:旧文件要兼容、团队要协作、出了事要有人负责,这些迁移成本本身就是壁垒。
法律在这里只是一支,不是全部。《计算机软件保护条例》早就写明,著作权保护不延及软件的思想、处理过程和操作方法——也就是说,它保护的是"怎么写",不是"做什么"。真正卡住人的往往是合同层:商业软件的用户协议普遍禁止反编译。拆开看是一回事,照着做一个是另一回事。
这轮热度里,有一半的报道在喊"软件的天要塌了"。但把三档产出并排看,那个 45% 已经把答案写在脸上了。
留一个可以验证的判断,值得单独记下来:
1如果半年内,有复刻项目的自评"可用于真实工作"能过 70%,并且有真实用户把付费软件换掉——那"功能层贬值"就是真的
2如果这些项目的自评长期停在 40% 到 60%,只在演示里好看——那被改写的就只是"看懂"的成本,不是软件的生意
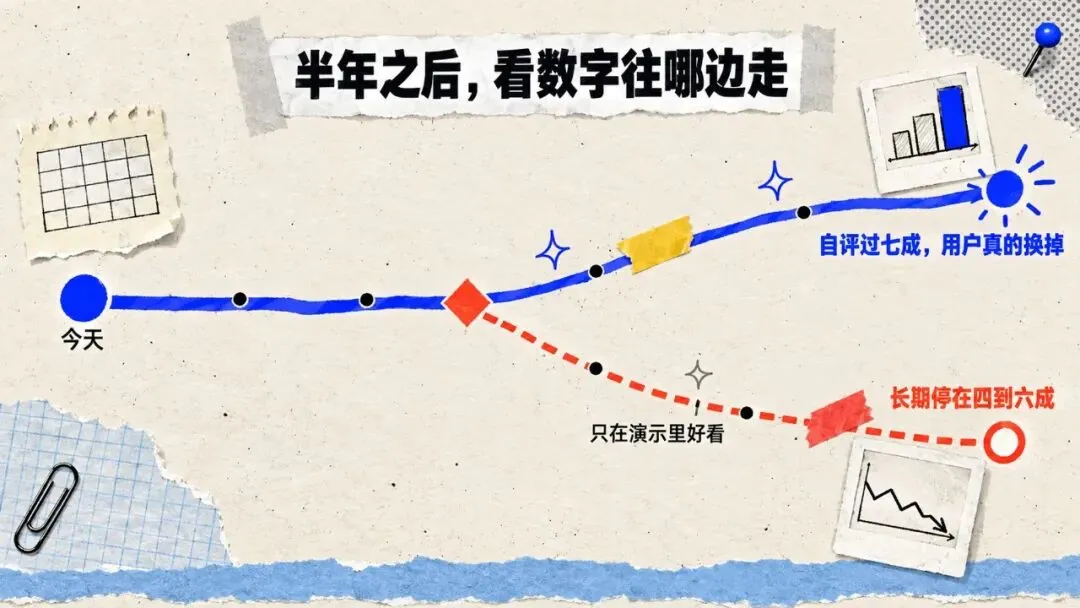
▲ 半年之后,看自评数字往哪边走
▪REA 官方仓库(morluto/rea)与 GitHub REST API 实测数据(2026-10-12);官方站点 rea.tools
▪GitHub Releases API:rea-agents v6.4.0(2026-10-11)
▪DX-Ball 完整重建仓库自陈数据;PhotoCraft / WordCraft / GridCraft 项目 roadmap 自评(2026-10-03 至 2026-10-10)
▪极客公园《一周 10 万星,AI「逆向一切」,但大家不要过于兴奋》;36 氪《号称"逆向分析一切"…》
▪法国 Quarkslab 加固二进制测试(2026 年初);Pushan 论文(2026 年 3 月)
▪《计算机软件保护条例》第六条、第十七条
三点说明。 一、文中的星数与自评百分比都是截至 10 月 12 日的口径。这类项目几天一变——同一个 Photoshop 复刻,三天内星数翻了六倍,roadmap 也在天天改。引用前请回仓库核对当日值。 二、"自评"是项目方自己公布的,不是第三方评测。Quarkslab 与那篇论文的数据同样为公开报道与论文口径,未经本号复现。 三、文中"功能层贬值""跑得快的人反而绕开了拆"属于分析判断,不是厂商原话。
你手机或电脑里,有没有一个软件,你花钱买的其实只是一个功能?评论区说说它是什么。
点个关注 ✨,精彩不迷路 ❤️
觉得有用,点个「赞」和「在看」;有不同判断,评论区聊。
免责声明:本公众号所发布的内容来源于互联网,我们会尊重并维护原作者的权益。由于信息来源众多,若文章内容出现版权问题,或文中使用的图片、资料、下载链接等,如涉及侵权,请及时告知,我们将尽快处理。