ARTICLE · 1176069
NeurIPS最有用的一集:如何让AI审稿人给高分?
如何让 AI 审稿人给高分?
看到这个问题,估计不少人已经准备「逐字学习」了。
来自弗吉尼亚理工大学、马里兰大学和 MBZUAI 的研究者,找来 60 篇 ICLR 2026 投稿,让 GPT-5.5 和 Claude Opus 4.8 按照 10 种不同策略改写。
研究方法和实验数据要求尽量保持原样,创新性、贡献和实验结果的表述则可以调整。
60 篇论文最终生成了 1200 份改写稿,再交给 30 种 AI 审稿配置逐一打分。
测试中,部分 AI 审稿人的评分确实会受到论文写法的影响。但评分最稳定的那套配置,区分不同论文的能力却接近随机水平。
8 月我们就报道过这支团队的前作,当时他们研究的是论文换种写法,AI 审稿分数会怎么变。
这一次,研究团队进一步提出了 RobustReview 评测基准和 SciCore 双分支审稿方法,尝试减少论文表达方式对 AI 审稿的影响。
论文标题:
A Missing Piece for Trustworthy AI Reviewers: From Benchmarking Rhetorical Robustness to SciCore Review
论文地址:
https://arxiv.org/pdf/2609.39027
项目地址:
https://github.com/c-steve-wang/Robust_Review
一篇论文改出 20 个版本
研究团队先筛选出能够匹配 arXiv 源文件的 ICLR 2026 投稿,按人工平均审稿分数划分为六个区间,每个区间随机选取 10 篇。
改写直接在完整的 LaTeX 论文工程上进行。这些修改主要围绕论文的表达方式展开。研究者可以强化创新性的表述,调整研究范围和实验结果的呈现方式,或重新组织贡献、改变技术语言和句式复杂度。
此外,还有多维度联合改写、连续两轮或三轮改写,以及根据审稿反馈引导的修改。
GPT-5.5 和 Claude Opus 4.8 分别按照这 10 种策略生成改写稿,每篇论文得到 20 个新版本,连同原稿共 21 个版本。
改写须尽量保留原有方法、实验数值和结论,并经过编译检查与内容保真审核。
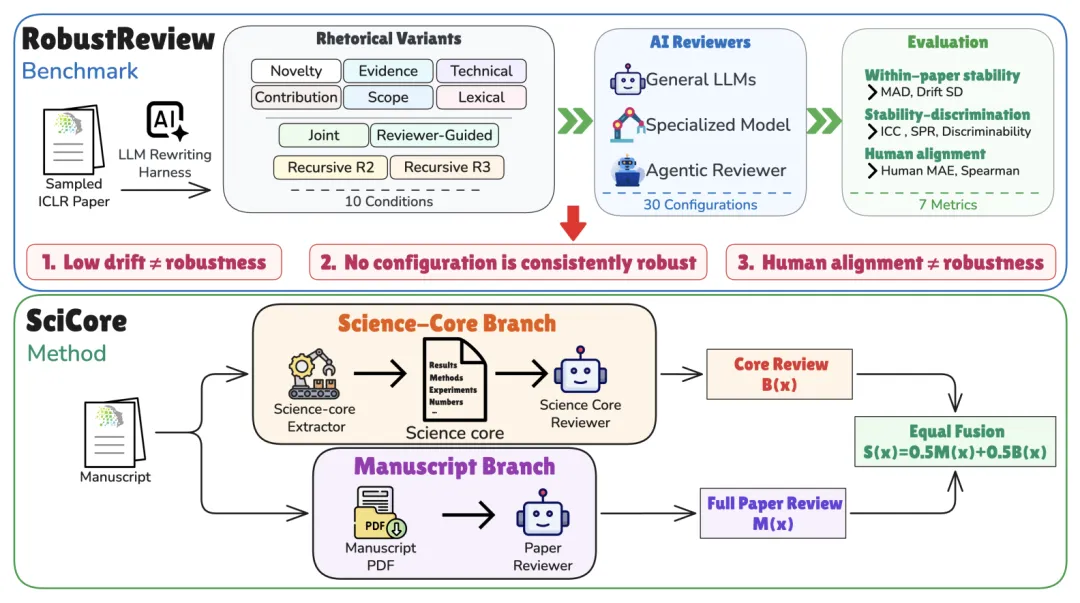
〓 RobustReview 评测框架与 SciCore 审稿流程
八款通用大模型分别采用标准、严格和持续强调科学内容三种审稿策略;另外三个专用审稿模型和三个 Agent 审稿系统,则沿用各自原有的审稿流程。
一个审稿配置如果对所有论文都打 6 分,不管论文怎么改,评分漂移都可以是零。这样的稳定显然没有审稿价值。
研究团队因此将修辞鲁棒性归结为两项要求。同一篇论文换种写法,科学评价应尽量稳定;面对不同论文,评分仍要保留足够的区分能力。
评测中,MAD 和评分漂移标准差衡量同篇论文的评分变化,ICC、信号保留比(SPR)和论文区分能力则检验稳定性与区分能力能否兼顾。AI 与人工平均审稿评分的一致程度另行评估。
写作 AI 的评分即使接近人工审稿结果,论文换种写法后,判断仍可能改变。
评分最稳,也可能分不清论文
Gemini 3.5 Flash-Lite 采用标准审稿策略时,平均绝对评分漂移(MAD)仅为 0.205,在 30 种现有配置中最低。单看改写前后的评分变化,它似乎是最稳定的。
但它的论文区分能力只有 0.511,接近 0.5 的随机参考水平,组内相关系数(ICC)仅 0.199。
所谓论文区分能力,就是看同一篇论文不同版本的评分,是否比不同论文之间更加接近。0.511 接近随机参考水平,并不代表论文质量预测准确率为 51.1%。
研究团队将这种低漂移、弱区分能力并存的现象称为虚假鲁棒性。评分变化很小,也可能因为模型对不同论文给出的分数过于接近。
相比之下,GPT-5.5 在持续强调科学内容的审稿策略下,MAD 为 0.476,评分变化比 Gemini 更明显。但它的 ICC 达到 0.697,论文区分能力为 0.682,三项联合鲁棒性指标均领先其他现有配置。
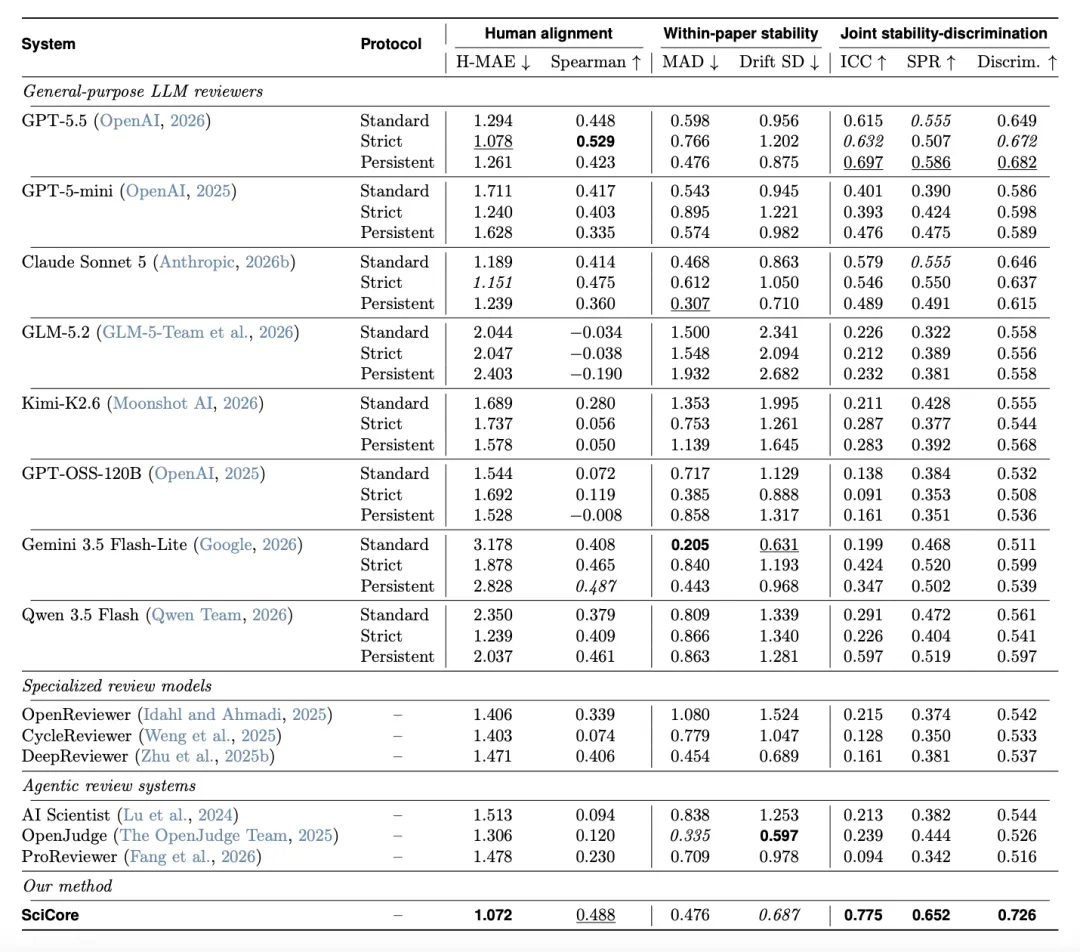
〓 不同 AI 审稿配置的修辞鲁棒性及与人工评分的接近程度
仅靠提示词强调科研内容,也未必有效。Claude Sonnet 5 采用这一策略后,MAD 从 0.468 降至 0.307,但 ICC 从 0.579 降至 0.489,论文区分能力也由 0.646 降至 0.615。
同篇论文的评分漂移减少了,联合鲁棒性却反而下降。
GPT-5.5 的两种审稿策略也各有取舍。严格审稿与人工平均评分的排序更接近,持续强调科学内容的策略则在联合鲁棒性指标上表现更好。
综合各项测试,30 种现有审稿配置没有一套能在不同改写条件下始终保持鲁棒。反复提醒模型只关注科研内容,也无法保证获得稳定的改善。
给 AI 审稿加一份科学内核
SciCore 让两条审稿分支分别工作。一条由 GPT-5.5 按严格规则评估完整论文 PDF。另一条先提取 Science Core,再由 GPT-5.5 依据这份结构化科研记录独立审稿。
Science Core 是一份结构化科研记录,涵盖研究问题、方法与假设、实验结果、复现信息,以及作者说明的局限。
提取时,模型须尽量保留关键公式与具体数值,将实验表格完整转写;原始图像不直接保留,无法可靠读取的信息则明确标记。
提取阶段客观记录论文报告的方法、结果和研究主张,不提前评价研究质量。随后,审稿模型再判断主张是否有充分证据支持、实验对照与消融是否充分,并区分论文本身缺少证据和内容提取失败两种情况。
同一篇论文换了写法,提取出的科学内容记录仍然高度相似。以 GPT-5.5 为提取器,原稿与改写稿的 Science Core 在文本嵌入空间中的平均余弦相似度为 0.978;与其他论文原稿对应的记录相比,则约为 0.62。
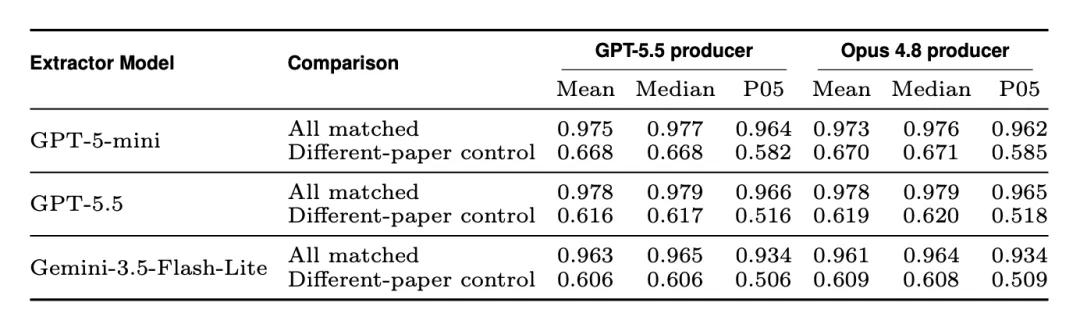
〓 不同提取模型下,Science Core 的同篇稳定性与跨篇差异
这组结果为 Science Core 的内容标准化提供了实验支持。不同写法的同一研究,提取出的科学记录仍然接近,同时保留了不同论文之间的差异。
后续审稿因此可以更多依据相对稳定的科学内容表示,减少原始措辞的干扰。
单独审查 Science Core 也有代价。采用专门适配的审稿策略时,这一分支的 MAD 降至 0.292,但与人工平均评分的绝对误差达到 1.461。
SciCore 因而保留完整论文的严格审稿分支,让两路总体评分各占一半。
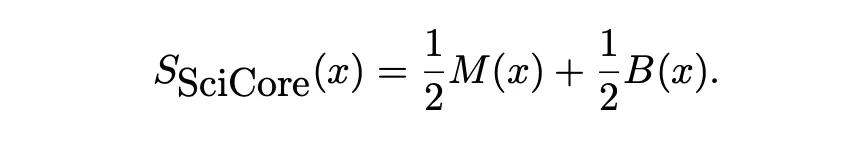
其中,M(x) 是完整论文严格审稿的总体评分,B(x) 是科学内容分支采用适配规则得到的评分。
与 GPT-5.5 按严格规则审查完整论文相比,SciCore 将 MAD 从 0.766 降至 0.476,减少约 38%。
ICC 提升至 0.775,论文区分能力达到 0.726。其信号保留比(SPR)为 0.652,三项联合鲁棒性指标在主要比较中均居首位。
SciCore 与人工平均评分的绝对误差为 1.072,接近完整论文严格审稿的 1.078;Spearman 排序相关系数为 0.488,略低于后者的 0.529。
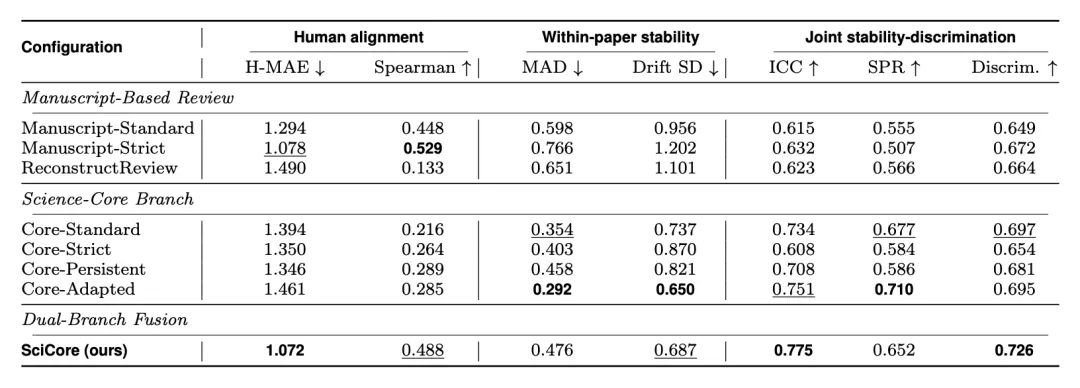
〓 完整论文、科学内容分支及双分支融合的消融结果
研究团队还测试了先用 Science Core 重建完整论文、再按标准规则审稿的方案。在本次实验中,它的七项指标均不及直接对 Science Core 进行标准审稿。
此外,作者还考察了两条分支的融合权重。增加科学内容分支的占比,通常有利于修辞鲁棒性,但与人工平均评分的接近程度会下降。各占 50% 的方案兼顾了两方面表现。
图中的三组子图对应三种完整论文审稿策略,不同颜色的曲线表示各项评价指标。纵轴为归一化后的表现,虚线标记 50% 的融合权重。
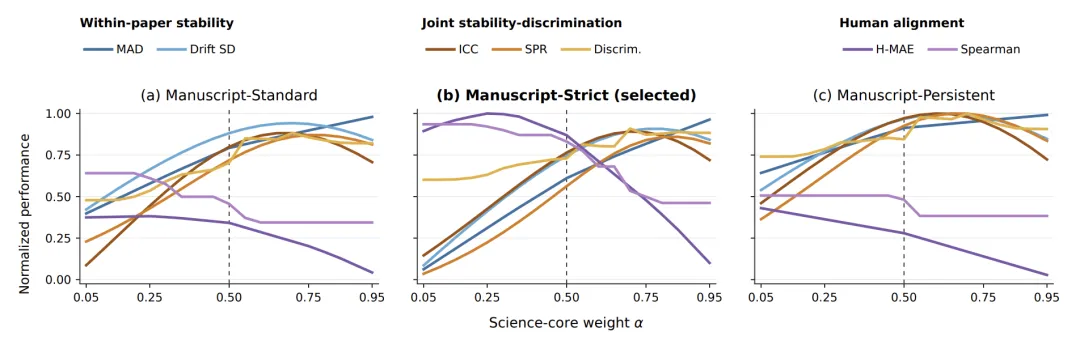
〓 不同融合权重下的修辞鲁棒性与人工评分一致性
单独审查 Science Core 可以减少修辞变化带来的评分漂移,但与人工评分的接近程度会下降。保留完整论文审稿分支,正是为了弥补这一不足。
双分支融合后,SciCore 在三项联合鲁棒性指标上取得领先,同时保持了与人工评分相近的绝对误差。
评分融合也要做对照
两份评分取平均,本身就可能减小波动。为了检验 SciCore 的性能提升是否主要来自这一操作,研究团队又加入了多种完整论文审稿的评分融合对照。
将 GPT-5.5 的严格审稿和持续强调科学内容的审稿结果取平均,ICC 为 0.758,论文区分能力为 0.715;SciCore 分别达到 0.775 和 0.726。
如果将标准审稿也加入,三套策略的平均结果在 ICC 上达到 0.781,略高于 SciCore。不过,其论文区分能力为 0.715,仍低于 SciCore。
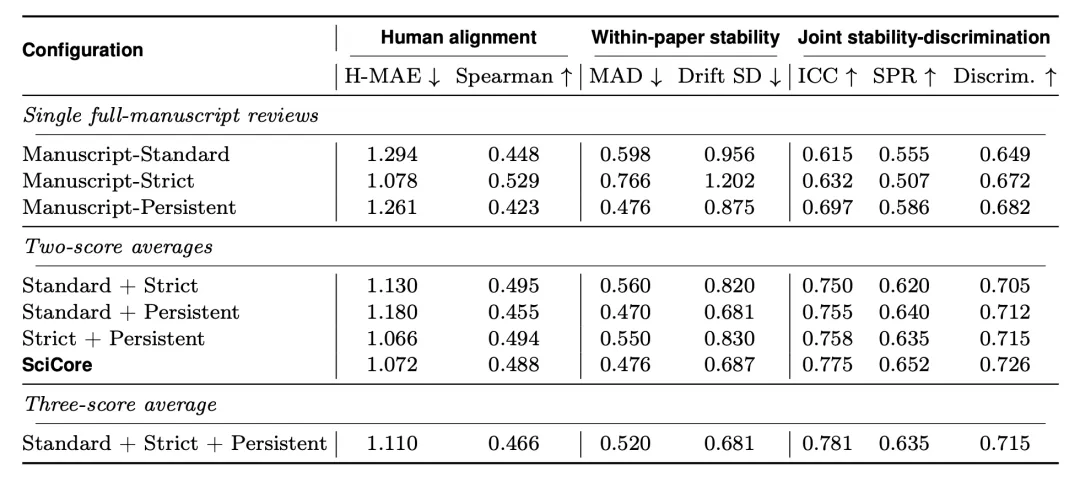
〓 SciCore 与完整论文多策略评分融合方案的对照
研究团队还对同一份 PDF 进行重复审稿,以检验模型自身的评分波动。SciCore 和完整论文严格审稿的 MAD 分别为 0.320 和 0.329,差距很小;面对不同的修辞改写版本,两者则分别为 0.476 和 0.766。
随后的 5000 次按论文组进行的配对 Bootstrap 重采样,也支持 SciCore 相比严格审稿在五项鲁棒性指标上的改善。
科学内容分支还在 GPT-5-mini 和 GLM-5.2 上进行了跨模型测试。
相比各自对完整论文的标准审稿,GPT-5-mini 在 MAD、评分漂移标准差和 ICC 上有所改善,但 SPR 与论文区分能力下降;GLM-5.2 的七项指标均有所改善。
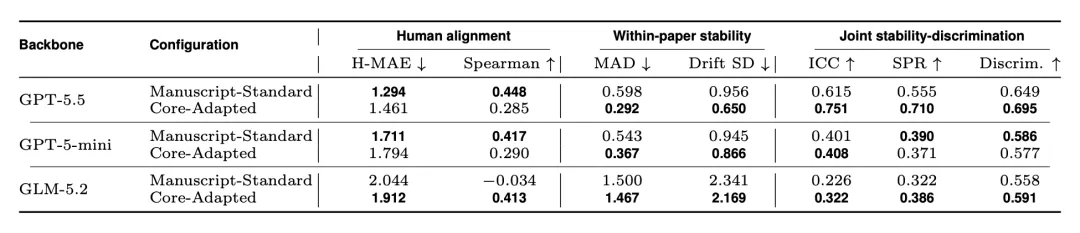
〓 不同底座模型下科学内容分支的跨模型测试
综合评分融合与重复审稿对照,SciCore 的改进不能简单归因于两次评分取平均。相同 PDF 的重复审稿结果,也支持其改写鲁棒性的改善。
科学内容分支确实提供了额外收益,但具体效果仍取决于底座模型。完整 SciCore 双分支能否在其他模型上取得类似效果,还需要进一步验证。
结语
这项研究没有给出一套能让 AI 审稿人稳定打高分的写法。
实验发现,调整论文的表达方式就可能影响部分 AI 审稿人的判断,而仅靠提示词强调科研内容,也难以获得稳定的改善。
RobustReview 提供了一套检验方法,SciCore 则通过科学内容分支改善了修辞鲁棒性。至于这套方法能否在更多模型和学科中取得类似效果,还需要进一步验证。
扫描二维码添加小助手微信