ARTICLE · 1176792
你的 AI 助手每次都在重新认识你
本期 · 深度观察
让 AI 写周报、做方案分析,早就是很多人的日常。但每一次开始之前,你都得先把资料翻出来、把背景交代清楚,它才可能真正动手。换一个任务,这套开场白还要再走一遍。拖慢智能体的,多半不在模型身上。它每回都要从头认识你,这一趟就是成本。
引子:一个更笨的问题
过去两年,所有人的注意力都在模型跑分上。参数、榜单、上下文长度,每一项都在往前赶。可在真实的工位上,卡住日常使用的常常是一件更笨的事:你手上那些资料,智能体不知道它们放在哪,也不知道该从哪一页翻起。
于是每个新任务的开场白都是同一段。先翻资料,再交代背景,然后它去查找、阅读、整理,才能真正开始。资料越多,这段开场白越长。
一、每次任务,都要重讲一遍
反复处理这些已经存在的资料,花掉的是三样东西:时间、token,还有准确率。手里的资料一多,开场白就跟着变长,漏掉东西和出偏差的概率也一起上去。
更麻烦的是这部分活不产生新价值。同一份项目文档读到第三遍,并不会让文档变得更好。这笔工作量跟着你的资料一起增长,却不会随着模型变强而消失。
这笔账还会随着资料变多而放大。手上只有几份文件的时候,多讲两句背景没什么;等到几百份文档压在手里,每回重新过一遍,就变成了实打实的成本。
把交代背景这一步提前做完,做出来的东西可以叫它一份底稿。以后每开一个新任务,智能体对着底稿开工,不用再从白纸开始。
openJiuwen 给出的说法是八个字:一次采集,反复使用。
二、你的资料,缺的是一份目录
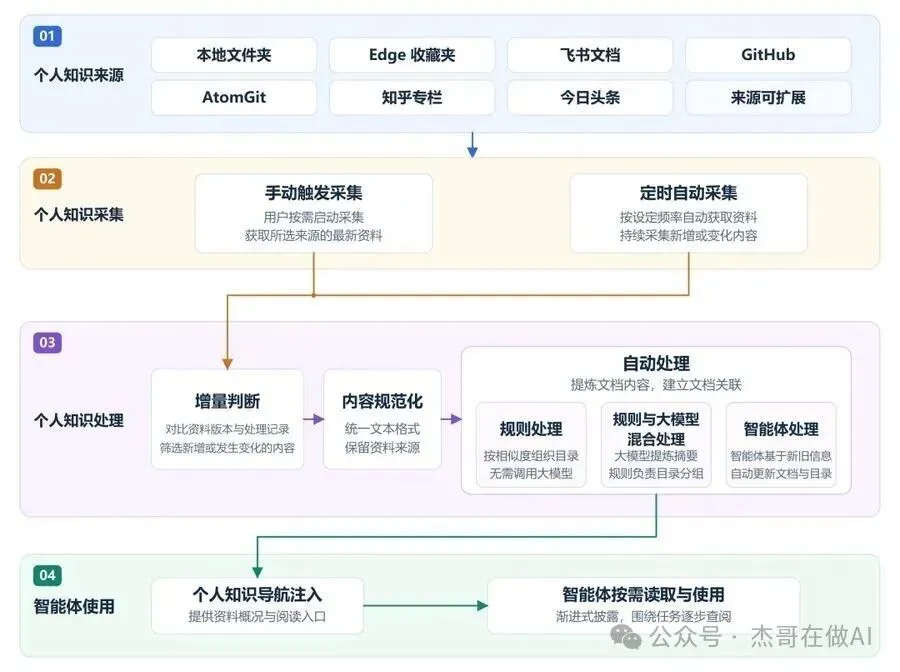
知识空间围绕四层展开:来源、采集、处理、使用。目标是把用户日常攒下的资料,转成能持续复用的任务背景。
能接进来的来源列得很长。Edge 收藏夹、本地文件夹、飞书文档、知乎专栏、今日头条,再加上 GitHub 与 AtomGit。哪些进来,由你决定,每个来源还能分别配置。
采集有两种节奏。想更新的时候手动发起一次;也可以设成定时自动,按你定好的频率持续获取。系统会比对来源标识、版本号和采集进度,判断哪些是新内容、哪些发生了改动,只处理这一轮的增量。来源管理页面会显示进度和最近状态,频率随时能改,正在跑的采集也能停。
还有一点容易被忽略:更新走的是增量。新资料进来之后,系统会结合已有的知识做补充和修改,不会把它们重新洗一遍。整套知识就存在同一批纯文本文件里,随着时间一点点长厚。
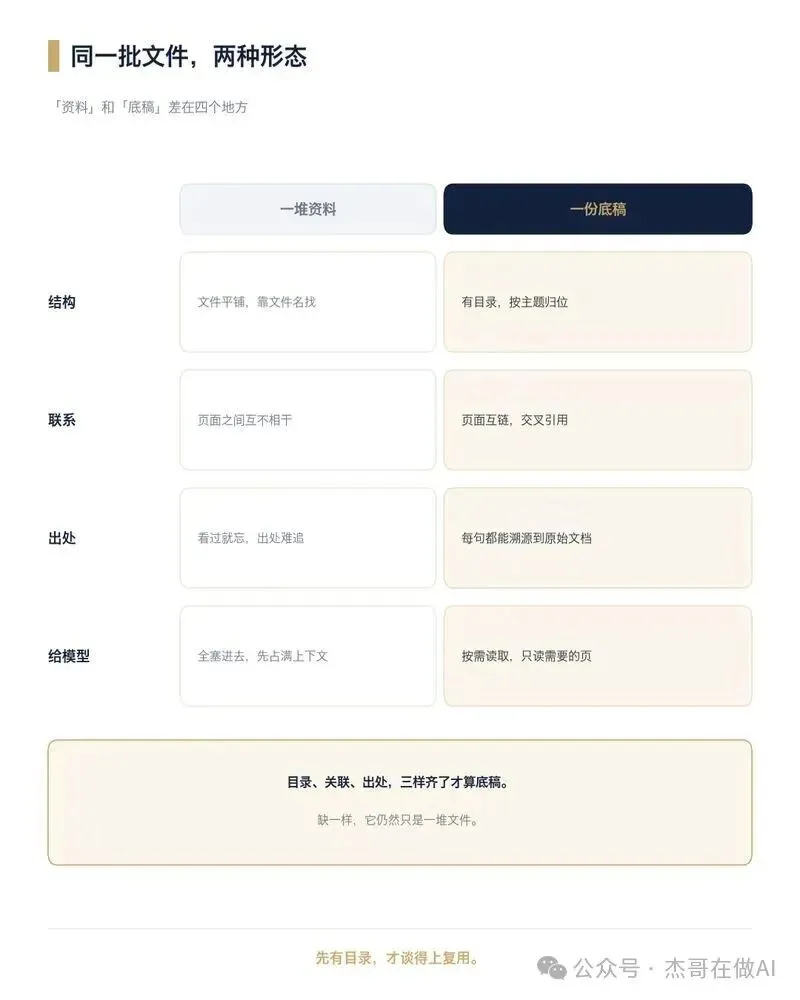
整理完的东西,不再是一堆平铺的文件。它有目录,页面之间能互相链接,每一段内容都能追回原始文档。
这一步才是关键。模型不缺阅读能力,它真正缺的,是一份能告诉它从哪一页开始的目录。
另外,能接的来源还会继续扩,这份名单没有封死。
三、三档整理,成本差得很远
网页、文档和代码,各有各的结构;同一个主题的内容还可能散在好几个来源里。系统把格式先统一,再提炼内容,按主题归成目录和页面。
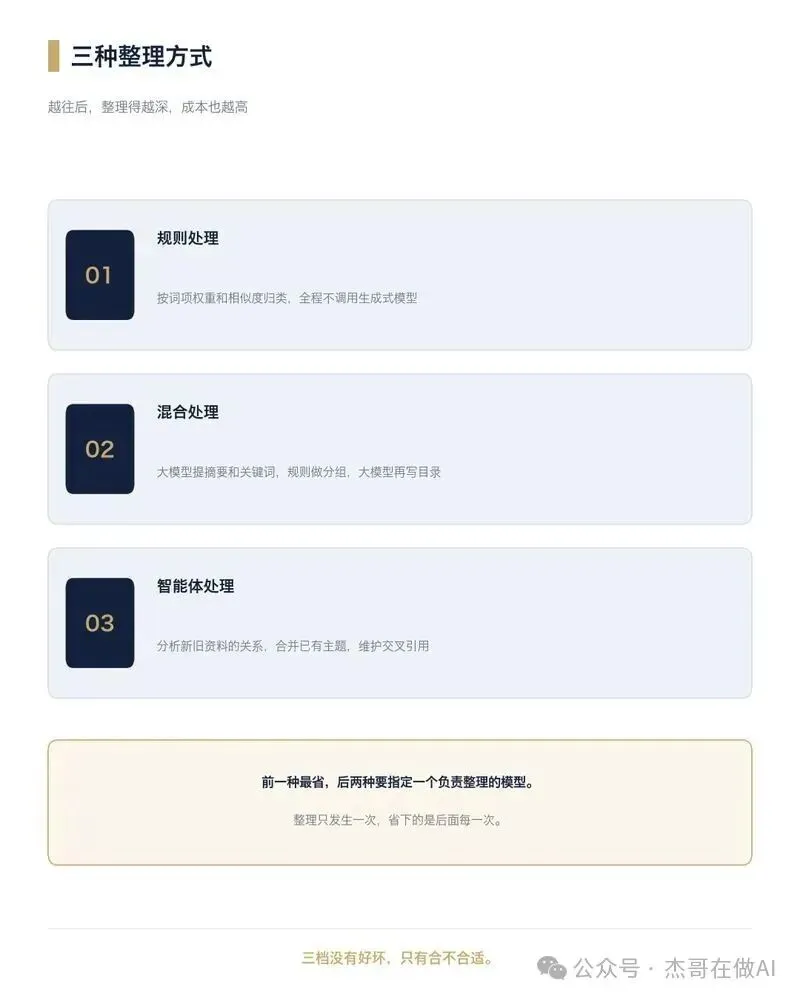
整理方式有三档,按需要挑。
第一档是规则处理。靠的是 BM25 的词项权重,加上内容之间的相似度,把相关页面按主题归到一起,目录和页面之间的链接也一并维护起来,这一档全程用不上生成式模型。
第二档是混合处理。先让大模型把标题、摘要、关键词都提出来,规则接手做主题分组和目录搭建,最后再让大模型补上目录标题与简介。
第三档是智能体处理。由智能体分析新资料和老知识之间的关系,优先合并或更新现有的主题页面,必要时新建文档,并且同步把目录说明和文档之间的引用关系维护好。
后两种需要另指定一个模型来负责整理。整理完之后,它会核对一遍目录结构和来源引用,验过之后才开放给查阅和智能体使用。
整理这事只做一次是不够的。采集到新资料之后,它会自动并进已有的主题:该合并的合并,该新开的页面新开,目录也跟着调整。
用户还可以用文件树、图谱或者搜索找到内容,打开正文阅读,再顺着来源标注追回原始资料。
四、先给目录,再给页面
资料整理好之后,用起来只有一步:在任务输入区的「+」菜单里把智能体接进知识空间。
收到输入后,智能体先看到的是这份空间的整体概况和阅读入口,知道手上大概有什么;然后顺着目录和文档链接,围绕当前问题一步步往下读,把需要的背景补齐。
官方把这种方式叫渐进式披露。类比很朴素:像刚接一份新活,先翻目录和项目简介,再挑自己真正需要的那几份文档。
举个例子。把一批关于某个开源项目的资料接进来,整理完直接问「介绍一下这个项目」,它翻的是知识空间里的文档,答出来的内容会带上核心机制和落地案例,也能指出这些话来自哪几篇。
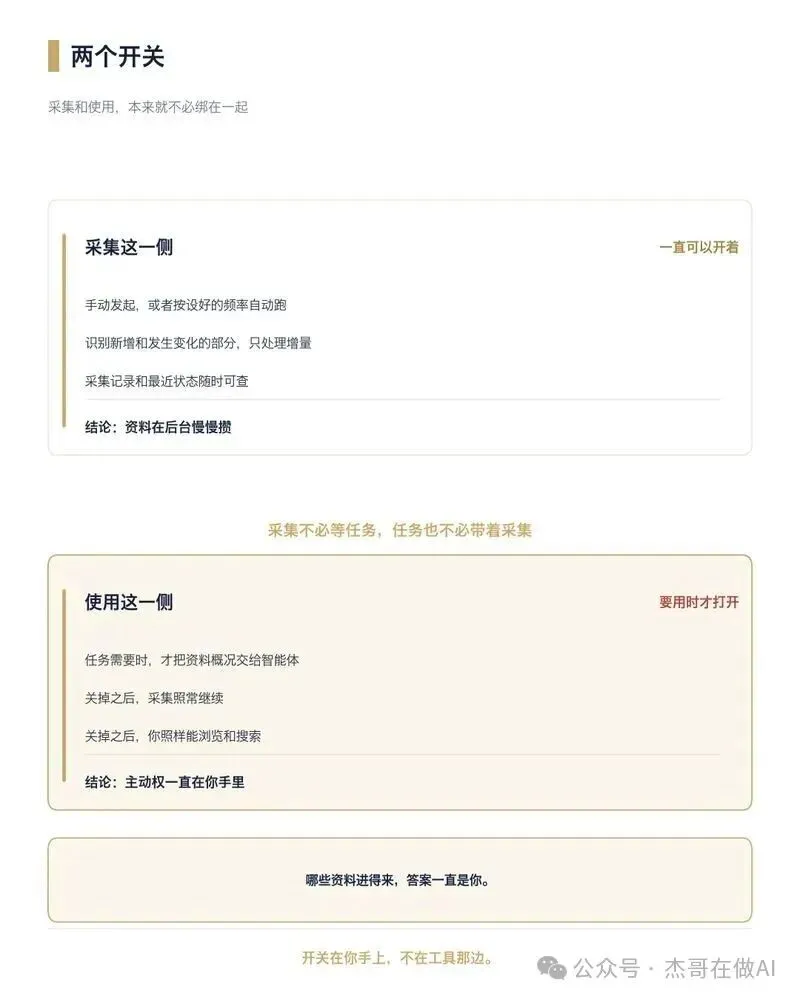
采集和使用是两件事,也各有各的开关。你可以让它一直在后台采集整理,等真正要用的时候再打开任务使用;关掉使用之后,资料照样继续采集,你也照样能自己浏览和搜索。
这一步的分寸也留给了用户。你可以先让系统默默采集几周,等知识攒出手感了,再决定要不要让它参与任务。
哪些资料进来,智能体什么时候能用,两个决定权都在你手上。发起任务的时候,你只需要盯着这次要解决的问题,剩下的背景由积累顶上。
五、三个数字
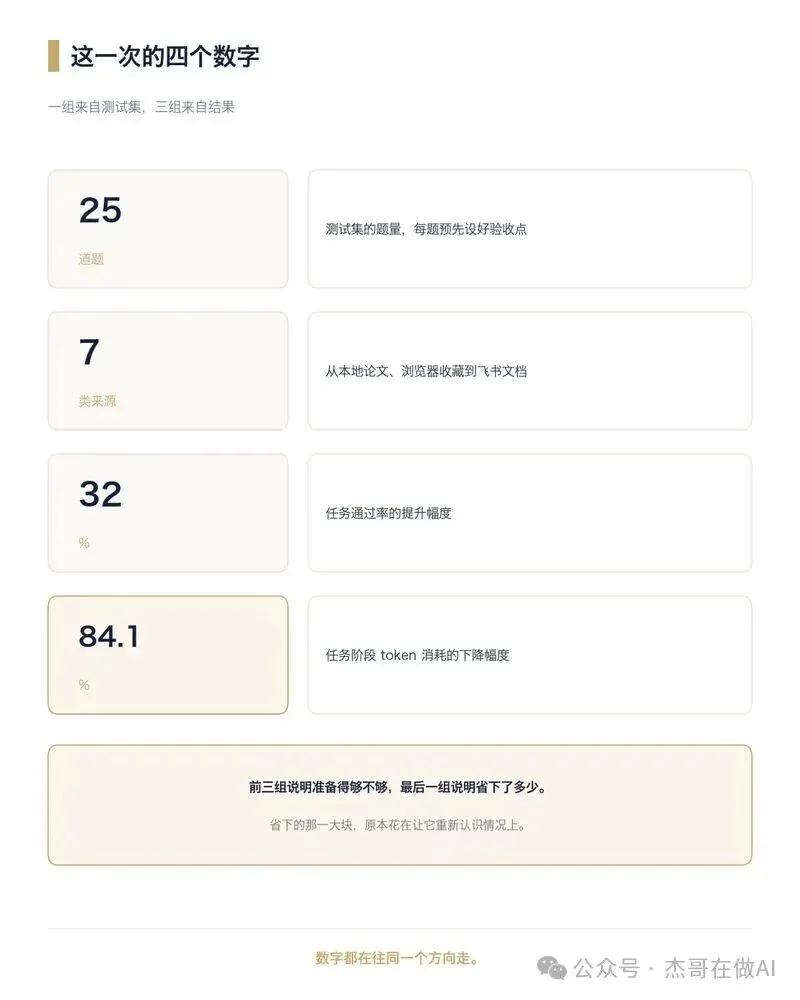
光说省时间不够,得看数字。团队自己搭了一套测试集,一共 25 道题,资料横跨七类来源,题目分几种类型:只从一处找答案的、要把几处拼起来的、换个问题再复用一次的、故意缺一块事实的,还有跟资料完全无关的。每道题都预先设好了验收点。
团队还先跑了两组对比测试。有知识空间的那一组,能把客户档案、项目材料和工作计划串起来,给出具体的项目总结和下一步安排;另一组缺了项目背景,找了多次还是没找到,只能给出一份通用的会议准备框架,然后回头请用户补资料。
结果三组:任务通过率提高 32%;任务总耗时少了 76.2%;任务阶段花掉的 token 少了 84.1%。
第三个数字要多看两眼。它说明在今天的很多任务里,token 有相当大一部分用在了让模型重新了解情况上,真正解题的开销只占其中一部分。
原文也把话说清楚了。这次实验用的是智能体那一档,预处理阶段本身也会消耗 token;这部分开销可以挑一个擅长整理、价格更低的模型来压住,而整理结果会在后面的任务里反复用到,成本也就一点点摊薄了。
说白了,这笔钱花在前面,后面每开一次任务,都能少准备一遍。
四个数字,两个方向 · 原创信息图
· 完 ·
如果这篇内容对你有用,欢迎点亮在看 · 分享给朋友,一起把手里那些资料变成随时能用的底稿。