ARTICLE · 1184383
你的AI助手正在偷偷记住你的一切
AI Agent隐私安全深度科普
你的 AI 助手正在偷偷记住你的一切——而有一类产品,连造它的人都看不到你的秘密
先说一个反直觉的事实:让更多人不敢用 AI 的,不是 AI 不够聪明,而是它太"懂你"了。
调研数据(Cisco,2025):92% 的组织把数据隐私列为采用 AI 工具的首要顾虑;另一项调研(Menlo Ventures)里,还没用上 AI 的人中,71% 给出的理由就是隐私。而斯坦福的一项研究更是直白:六家主要 AI 公司,都被发现默认在用用户的聊天数据训练模型。
聊天机器人时代,泄露的只是一次对话。但 AI 正在进化成 Agent——它会记住你的日程、你的偏好、你凌晨三点的emo、你发过的每一封邮件。它越有用,你被"记住"的就越多;被记住的越多,你就越脆弱。
于是,一个新方向正在 2025–2026 年快速升温:Private Agent,隐私保护型智能体。今天这篇文章,把它讲透。
一、Chatbot 泄露一句话,Agent 泄露"你这个人"
传统 AI 聊天是"一问一答":你问,它答,会话结束,明文即弃。泄露面有限。
但 Agent 完全不同。它要持续替你干活——替你读邮件、管日历、订机票、盯行情。为了做到这些,它必须持有你的凭证、你的文件、你的长期记忆。这意味着:
一个 AI Agent 持续为你工作的前提,是它必须持续持有你的数据。这不是隐私政策的疏忽,而是产品形态本身。
—— 改写自 Bee 创始人 Steve Korshakov 2026 年 7 月的演讲
这家叫 Bee 的公司(2025 年 7 月被亚马逊收购)做了个可穿戴设备,记录你听到的一切。他们的测算:单个用户一年产生约 1000 万 token 的语音数据——戴上它不到一周,你周围的人就足以拼出你的全貌。
于是他们提出了一个不那么体面、但极其关键的问题:
"到底什么能阻止发布这套代码的人,自己偷看你的数据?"
注意,这个威胁模型里,坏人不是黑客,而是做这个产品的人自己——它的员工、管理员、以及被传票调阅数据的任何人。传统 Agent 的隐私靠《用户协议》保证,而 Private Agent 要的是:保证写在架构里,写在数学里,写在硅片里。
二、"私有部署"≠隐私:先看懂这三级
市面上"本地部署""数据自主可控"的说法满天飞,但真正的隐私是分级的,弄混了会吃大亏:
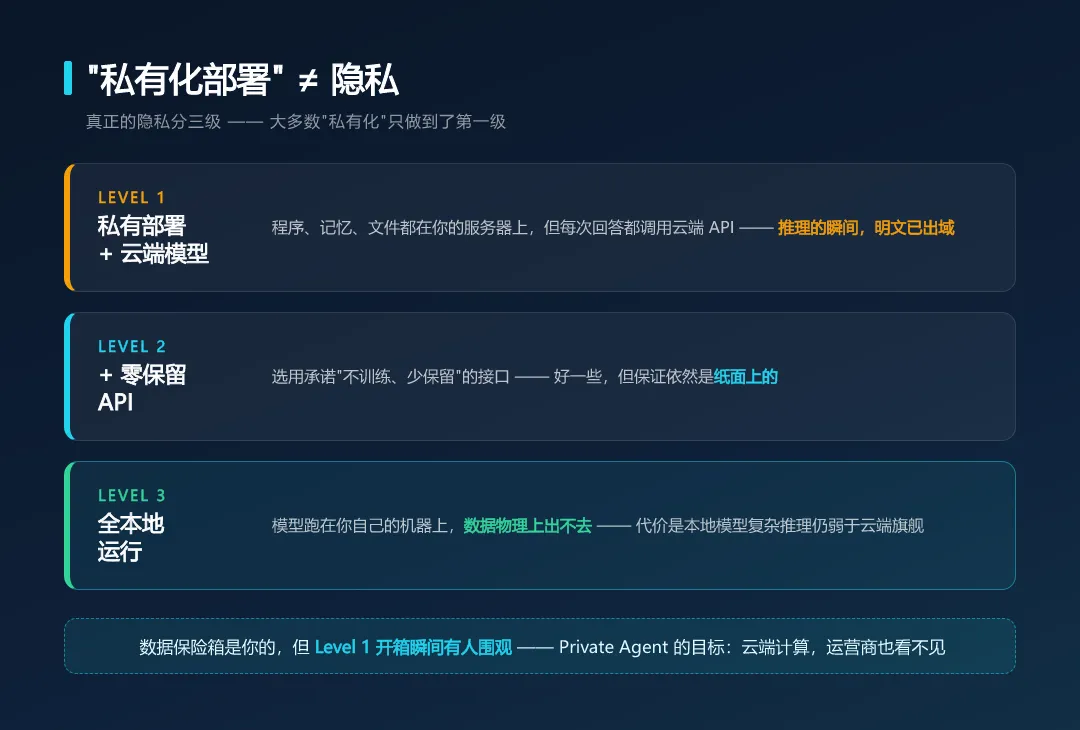
| Level 1 | ||
| Level 2 | ||
| Level 3 |
绝大多数自认为"私有化"的部署,其实停在 Level 1——数据保险箱是你的,但开箱瞬间有人围观。真正的 Private Agent 目标是:即使计算发生在云端,你的数据也对云端运营商不可见。
三、做到这一点的技术,拢共六件套
听起来玄,拆开看每件都不神秘:
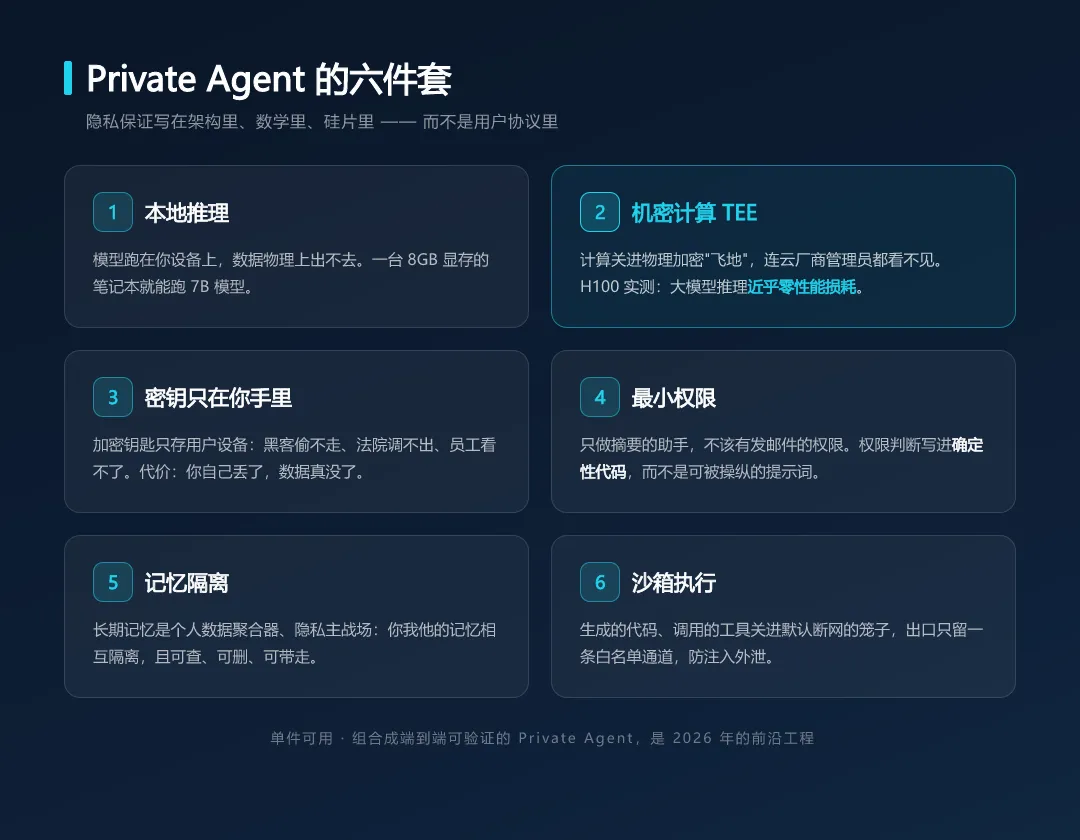
1. 本地推理
模型跑在你设备上,数据物理上出不去。Ollama、llama.cpp 都是干这个的——你现在用一台 8GB 显存的笔记本,就能流畅跑 7B 模型。
2. 机密计算(TEE)——这是 2025 年最大的变量
如果算力必须用云的呢?把计算关进一块物理加密的"飞地":连云厂商自己的管理员、甚至操作系统都看不到飞地里的数据。NVIDIA H100/H200 已支持 GPU 级机密计算,实测对大模型推理几乎零性能损耗。"为隐私付性能税"这个借口,正在消失。
3. 密钥只在你手里
加密数据的钥匙只存在你的设备上,厂商拿不到、也造不出备份。没有恢复后门,就意味着黑客偷不走、法院调不出、员工看不了。代价也很直接:你自己丢了设备,数据真没了。
4. 最小权限
只做摘要的助手,就不该有发邮件的权限。更关键的一层:权限判断必须写在确定性代码里,而不是提示词里——因为提示词是可以被攻击者操纵的。
5. 记忆隔离与可删除
Agent 的长期记忆是个人数据聚合器,是隐私的主战场。你的记忆必须与你我他的记忆物理隔离,且随时可查、可删、可带走——这不是功能,是 GDPR 和《个人信息保护法》的硬要求。
6. 沙箱执行
Agent 生成的代码、调用的工具,关进默认断网的笼子里跑,出口只留一条白名单通道。否则一条藏在网页里的恶意指令,就可能诱导它把你的密钥发到攻击者的服务器(这种攻击 2025 年已被多次实测成功,业内叫 Prompt Injection,是 Agent 时代的头号威胁)。
四、巨头和开源社区,都交出各自的答案
| Apple | ||
| Google | ||
| Amazon / Bee | ||
| 开源社区 | ||
| 国内路径 |
一个值得注意的细节:Google 发布 Private AI Compute 时,做了件前所未有的事——公开了服务器上运行代码的密码学指纹,并承诺接受第三方审计。当你无法亲眼验证时,"可验证"至少让撒谎变得困难。
五、泼一盆冷水:它还没到"放心交出一切"的程度
作为一篇负责任的科普,必须说清楚短板:
① Prompt Injection 还没被解决。攻击者把恶意指令藏进网页、邮件、甚至图片里,诱导 Agent 泄密。OpenAI 自己都公开承认:这类攻击"可能永远无法被完全解决"。目前的防御(双模型隔离、权限闸门)能把攻击成功率从 50% 压到个位数,但压不到零。
② 加密和好用,天生打架。"密钥只在你手里"意味着没有找回机制,普通人丢一次设备就清零。如何在"无后门"和"能恢复"之间找平衡,还是开放问题。
③ 算力与模型的鸿沟仍在。本地模型日常问答够用,复杂推理仍落后旗舰云端模型。全本地路线的体验天花板,取决于你钱包里 GPU 的厚度。
一句话现状:组件成熟了,系统还没成熟。TEE 推理、本地运行时、记忆隔离、注入防御,每一件单拎出来都可用;把它们组装成一个端到端可验证的 Private Agent,是 2026 年的前沿工程。
六、普通人现在能做什么?三步走
第一步,分级处理你的数据。买奶茶聊天用云端 AI 没问题;看病历、合同、财务报表,换成全本地方案(Ollama + AnythingLLM 这类组合,桌面上点两下就能装好)。
第二步,把记忆留在自己手里。别把个人记忆、笔记、偏好存在任何厂商云端;用可自托管的记忆方案,并养成定期导出的习惯。
第三步,给 AI 的权限做减法。每给一个 Agent 接一个工具(读邮箱、传文件),就当发一张门禁卡——问一句:它真的需要吗?
写在最后
AI Agent 的进化方向是"越来越懂你",而 Private Agent 要回答的问题是:这份"懂",能不能只属于你一个人。
过去我们用隐私政策信任厂商,未来我们会用架构和数学信任它们。当"看不见你的数据"从承诺变成物理事实,AI 助手才真正配得上"助手"两个字。
如果这篇文章对你有启发——
👍 点个赞,让我知道这个方向有人关心;
👀 点个"在看",转给那个总往云上贴合同的朋友;
💬 留言聊聊:你的 AI 助手知道你多少秘密?你敢让它"记住你"吗?
参考与声明:本文基于公开资料整理,核心信息来源包括 Apple Private Cloud Compute 技术文档(2024)、Google Private AI Compute 发布公告(2025-11)、Bee 公司隐私架构演讲(2026-07)、OWASP LLM/Agentic 应用安全榜单(2024-11 / 2025-12)、Cisco《AI 安全调研》(2025)等。文中引用的第三方调研数据为二手转述,已尽量标注原始出处与时间;个别市场预测数据存在不确定性,仅供参考。