ARTICLE · 1184577
翻完大量官方文档,才看懂 Hypit 真正价值并不是克隆爆款
大家好,我是Bite。
最近比较着迷刷短视频,发现不同平台"爆款"是有套路的同样的钩子、同样的节奏、同样的信息密度,换个主角、换个产品又能跑一遍。我在想这些都是同类剧本的产品是否有类似逆向一切的rea一样的工具来拆解呢?
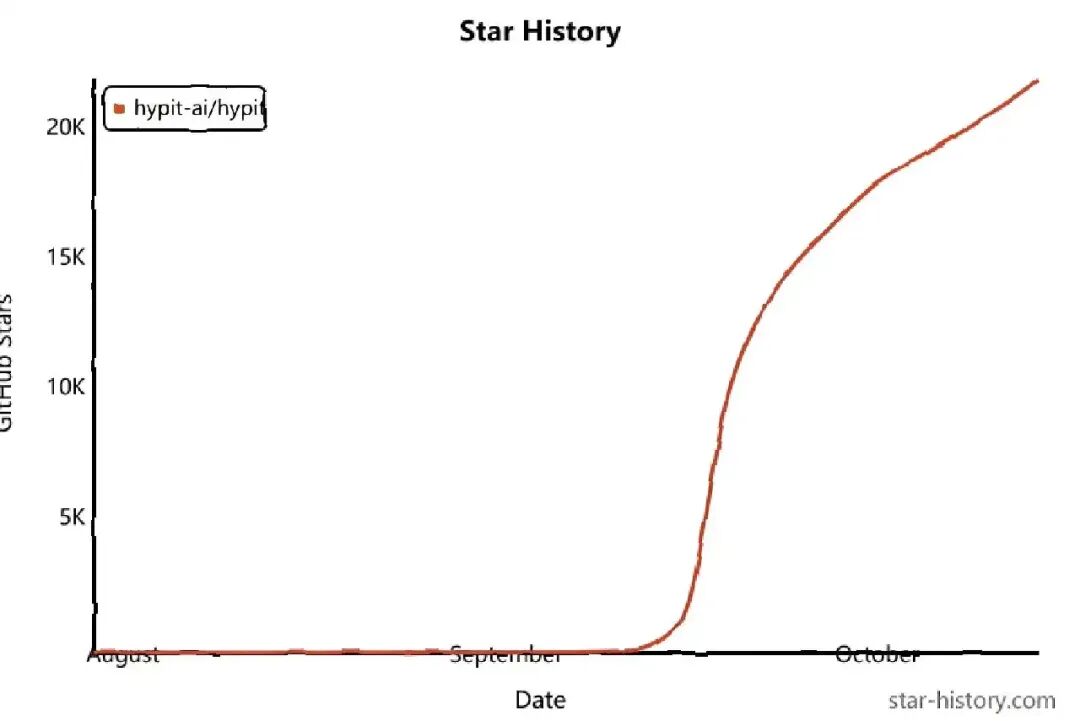
刚好这些天刷GitHub就发现了把这件事做到极致的一个开源项目:把整条视频拆成代码,让 AI agent 像改代码一样改视频。它叫 Hypit,2 个半月涨到 22k 星,Trendshift 日榜榜首。
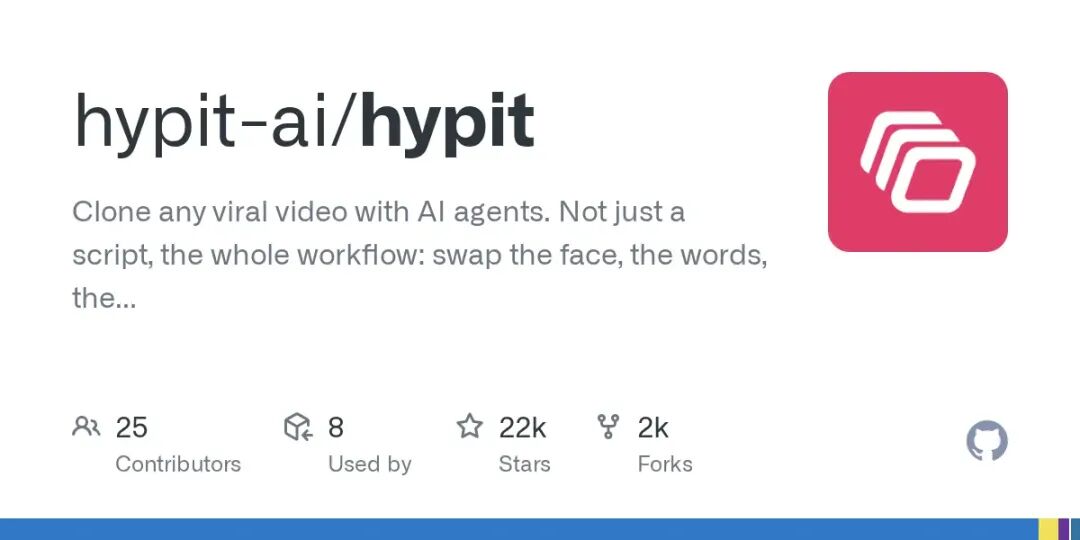
但我要先说的一个问题是:它的口号是克隆任何爆款视频,甚至写着换脸。技术思路值得学,营销话术里的那部分,劝你别碰。 这篇我把它拆开看,好的坏的都说清楚。
它到底做了什么
Hypit 给 AI agent 造了一门"视频语言"——SVML(视频标记语言),配套一个编译器。你丢给 agent 一段视频,它把这条视频还原成一个完整的工作流:素材、字幕、B-roll、特效,全部锚定在词上,而不是秒上。
关键在于它的形态:不是点一下生成一条片,而是写一份可编译、可复用、可批量变体的源代码"。左侧是 SVML 源码,右侧是实时渲染出的视频,改一行代码,视频立刻变。
这跟 Runway、Pika 这类纯生成工具有本质区别:那些是"生成器",Hypit 是"编译器 + DSL"。视频从此变成了一种可以被版本控制、被 review、被 diff 的资产。
三个真正有含金量的设计
第一,SVML 是一门货真价实的语言,不是配置项。 我翻了它仓库里的示例源码(examples/ranking-football/reference.svml),开头是 <?svml using="@hypit/markup@1"?>,然后 <import> 引入一堆组件包——脚本、文本、媒体、FishAudio 语音、GPT Image、Seedance、WhisperX 字对齐……像引 npm 包一样。叙事写在 <script> 里,台词用 <HOST> 包裹,@{...} 是词级锚点,|| 是断句标记。生成模型、语音、字幕、特效,全部是插拔式的组件。
第二,锚定"词"而不是"秒"。 这是它最聪明的一处。传统视频工程里,字幕、音效、特效都绑在时间轴上,改一句台词,后面所有时间点全要重排。Hypit 把每个元素锚到具体的词上,你删一句话、换一段字幕,时间轴自己重新流动。这也是"一条命令出 100 个变体"能成立的技术底座——变的只是词,结构不动。
第三,生成模型是可选件。 一条工作流可以只编译字幕、动态图形、代码渲染的视觉,完全不调生成模型、不付模型服务费。官方给的三条示例片(足球辩论、播客切片、街头采访)成本分别是 1.07 / $1.09——当然这是官方自报、只算模型调用那部分,你的 Coding Agent 订阅和本地算力另算。
安装与部署
安装一条命令:
npx skills add hypit-ai/hypit -g装完是个 skill,Claude Code、Codex 都能直接用。然后进任意目录,跟 agent 说一句:
/hypit Clone this video: /path/to/video.mp4, and replace the ranking content with a comparison of Hypit with other AI video products.或者不丢参考视频,直接描述:
/hypit Make a ranking video that puts Hypit in S tier.agent 自己会检查环境、要凭据、生成素材、编译成片。它自己免费,模型服务走你选的供应商。
上面这条是官方示例GOAT DEBATE一段 20 秒的足球排名视频,Ronaldo 排 D 档、Messi 排 S 档。整片用 Seedance 2 Mini 生成 A-roll、GPT Image 2 生成 B-roll 和 2K 人像、WhisperX 做字对齐,64 个 headless Chromium 并发渲染,总成本 $1.15。三个克隆变体:旁白换成香蕉猫、排名倒过来让 Ronaldo 成 GOAT、把球员全换成科技创始人——同一个爆款结构,三条不同的片。
换句话说,传统剪辑软件把视频当成一条时间轴,AI 生成工具把视频当成一次性的 prompt 结果,而 Hypit 把视频当成一份程序。程序的好处是能复用、能 diff、能分支、能批量重跑——你改的是"源码",重跑一遍就是新片,而不是在时间轴上手动拖动几十个图层。对内容团队来说,这意味着"一条跑量的片"可以沉淀成可复用的模板资产,而不是一次性消耗品;团队里谁改了什么、为什么改,全在 Git 提交记录里,和管代码一个样。
哪些人真用得上
批量做 UGC 口播、营销短视频的团队:把验证过能跑量的那条片当模板,换产品、换价格、换 CTA,一天出一堆变体。 做多语言分发的:一条片出十种语言,改一行台词,时间轴自己重排。 想用代码管视频资产的开发者:把视频工作流纳入 Git 版本管理,模板可复用、可 review。 预算敏感、想省模型费的:字幕、动态图形、代码渲染视觉这条路,不用生成模型也能出片。
两条红线,必须先说清楚
红线一:合规。 它的卖点"克隆爆款 + swap the face"直接踩在 deepfake 换脸和肖像权的灰区上。官方示例里"换脸""换声音"是真演示。研究它的视频即代码思路可以,但别把拆出来的别人的脸、别人的声音、别人的爆款结构直接搬进你的产品——尤其未经授权的真人换脸,在多数司法辖区是明确的侵权甚至违法。 只分析你有权使用的内容,这条比任何工具技巧都重要。
红线二:它不是标准开源。 别被 README 徽章上的"Apache-2.0"骗了。点进去看 License 文件,全称是"Hypit Open Source License"——基于 Apache-2.0 改的,额外加了三条限制:不得用它的代码运营多租户 SaaS 服务、不得商业再分发(除非书面授权)、不得移除 CLI 里的 LOGO 和版权信息。GitHub 官方标注是 NOASSERTION(非标准协议)。用它出片没问题(产出归你),但想把它嵌进你自己的商业产品去卖,得先谈授权。
两个观望点:项目才 2 个半月,0.3.x 阶段连 SDK 迁移指南都出了两份,接口还在快速变动;open_issues 目前 12 个看着少,但生态和文档都还浅,组件包生态刚起步,眼下复杂特效多半得自己写组件。
我个人的看法
客观说,Hypit 最有价值的东西不是"克隆爆款",而是它无意中回答了一个真问题:当 AI agent 接管内容生产时,视频该以什么形态被管理? 它的答案是"视频即代码"可编译、可复用、可批量、可版本控制。这个方向我是看好的,它把 Runway 那类一次性生成往前推了一步,推到了可工程化的资产这一层。
但"克隆爆款/换脸"这个定位,我认为是它给自己埋的雷。技术上它确实能克隆,可一旦用户真的拿它去做未经授权的换脸和爆款搬运,背锅的首先是用户,其次是这个项目自己一个靠"克隆别人"立命的产品,很难长成被严肃对待的基础设施。我猜作者也意识到了,所以 README 里反复补一句克隆是最快的入口,不是唯一的用法。
所以我的态度很明确:学它的 DSL 和编译器思路,做你自己的原创视频;别碰它营销话术里的克隆和换脸。 技术是干净的,用技术的方式,脏不脏全看你怎么用。对想批量做原创短视频的人来说,它值得一试;对冲着克隆爆款去的人来说,先想清楚合规边界再动手。
GitHub开源地址:https://github.com/hypit-ai/hypit
点击下方卡片,关注极客AI开源圈
本号持续更新实用有趣的开源项目。如果你不想逐篇翻阅往期文章,可以直接关注公众号【极客AI开源圈】,在后台留言与号主互动交流。
如有收获,请您点个赞+分享+推荐,很多您呐!