ARTICLE · 1190946
AI测试26:Skill 写了却不生效?就卡在这3个地方
AI 测试 · 第 26 篇
AI测试26:Skill 写了却不生效?就卡在这3个地方
写进文件里的东西,AI 默认只当建议。三个卡点各配一个能判对错的改法,再附一张按症状倒查的表。
同一句话,敲在聊天框里它照做,写进 SKILL.md 里它当没看见。
先把答案给你:
写进文件里的东西,AI 默认只当「建议」;只有写成能判对错的步骤,再配一个「成品长什么样」,它才会把它当「规则」执行。
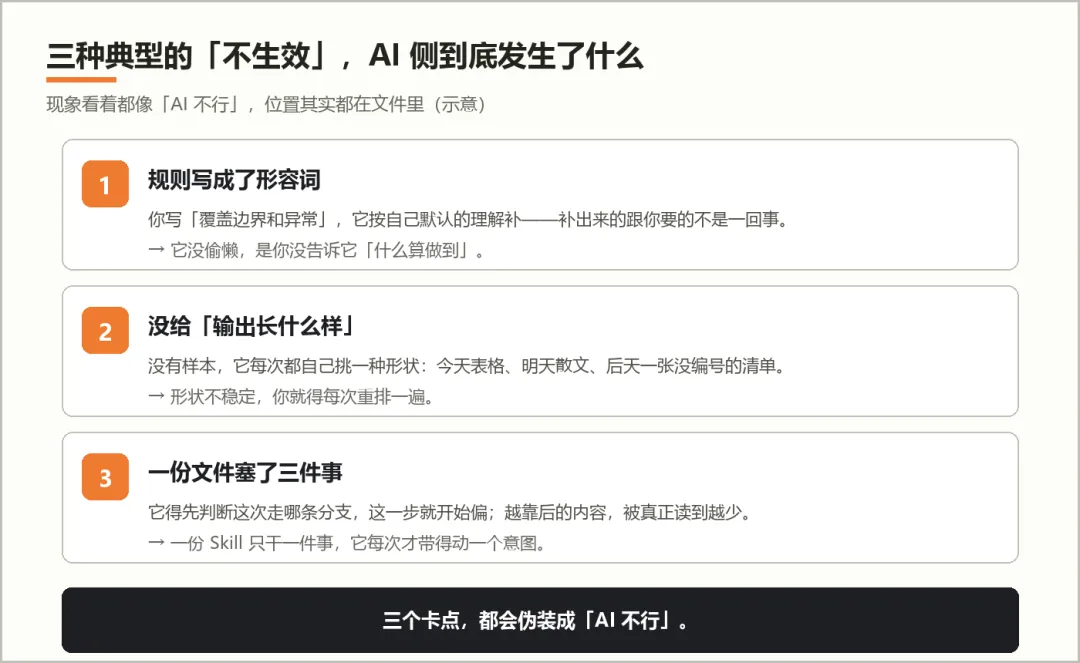
一份 Skill 用起来不好使,九成卡在这三个地方:
先把这篇在合集里的位置说清楚,免得你读到一半发现是旧内容:02 讲过 Skill 是什么,15 手把手从零搭过一个,24 讲 Skill 该从哪条路来,25 讲生成用例之前该把哪几条规则写死。那四篇解决的都是「怎么把它写出来」。这篇只回答一件事:已经写出来了,用起来不对,该往回查哪里。
说这三个卡点之前,先交代一件我自己刚踩的坑——它跟本篇讲的是同一件事,只是换了个位置。
我手里有一份自己写的发布前自检清单,九节,写得很细:版式怎么换、素材怎么补、排期怎么错开,一条条都在上面。结果连着两篇稿子都没读它,只把能跑的脚本跑了。
脚本覆盖不到的那几节,全漏了:版式连着五篇长得一模一样,正文里找不到一处真实素材,两篇稿子还挤在同一天成稿。
后来我的做法不是「下次记得读」,而是把能脚本化的那几节全部写成脚本,挂进发布命令里——跑不过去就是跑不过去,不用谁记得。
写进文档只算提醒,做成脚本才算规则。 这就是我自己花了两篇稿子的代价换来的结论,也是这篇要讲的东西:你以为你交代过了,和它真的照着做了,中间隔着一整套「怎么写」。
(下面出现的 SKILL.md 片段和输出都是示意,用来说明写法,不是某个工具的真实界面;换成你们自己业务的时候,判据得你自己定。AI 给你的任何产出,也必须人工抽验过才能进流程。)
STEP 01
卡点一:规则写成了形容词,不是判据
先看一段几乎每个第一次写 Skill 的人都写过的样子:
# 接口测试用例生成
## 怎么做
1. 解析接口文档
2. 设计测试场景
3. 覆盖边界和异常情况
4. 输出格式规范的用例
读起来每一句都对,但每一句都没法判对错。
对你是「我已经交代清楚了」,对它跟「你看着办」几乎没有区别。它会按自己最熟的那套默认理解去补,而它默认的那套,跟你们业务的判据不是一回事。
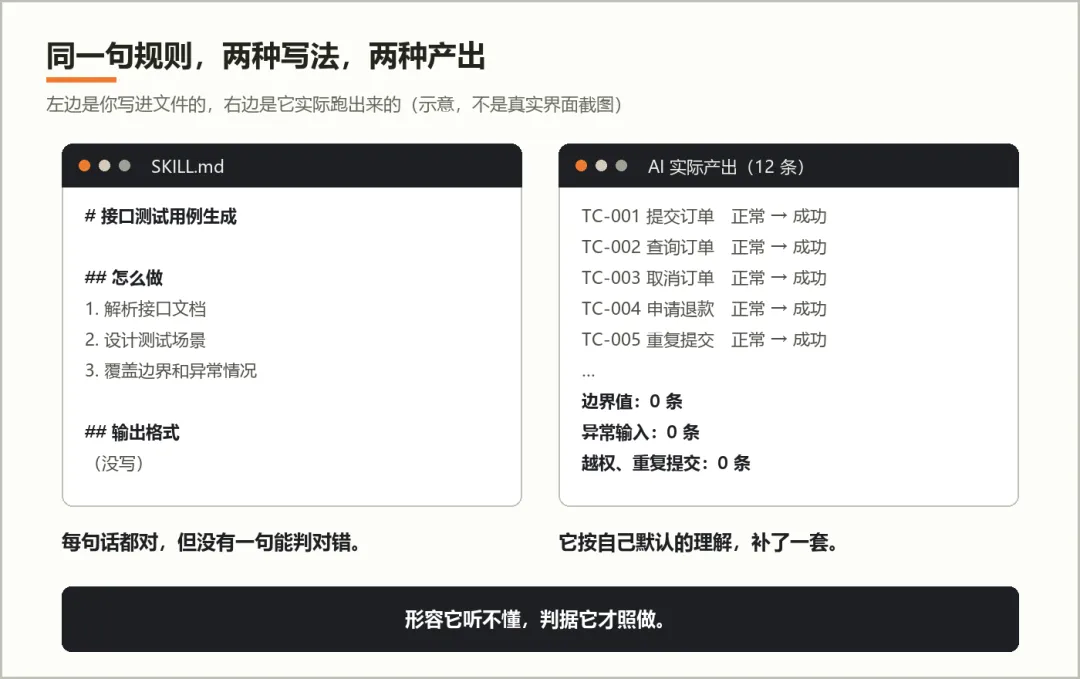
改法只有一个动作:把形容词换成能判对错的完成条件。
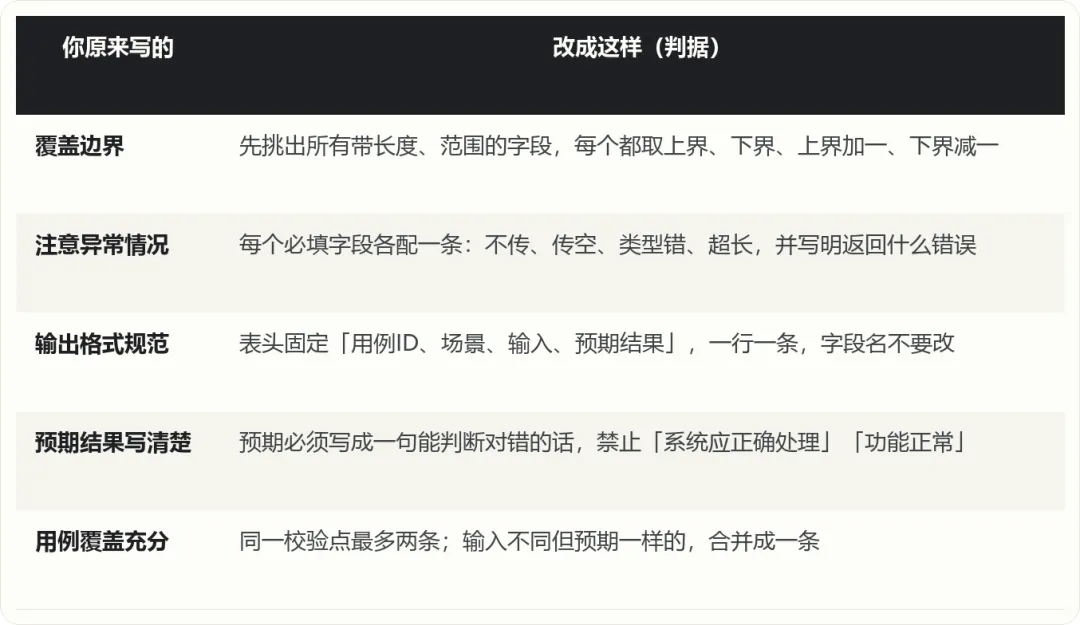
对着这张表看规律:每条规则都得能回答「做到什么程度算做到」。 答不出来的,就还是形容词。
有个更快的自检办法,你现在就能试:把你 SKILL.md 里的每条要求,拿给一个不懂你业务的同事看,问他「你怎么知道我做到没做到」。他答不上来,AI 一样答不上来。
(刚转行的同学(P1)这里最容易卡住——不是你不会写,是你还没攒够「哪些地方会出问题」的素材。先去用,把踩到的坑记下来,那些坑本身就是判据。)
STEP 02
卡点二:只说了怎么做,没说做完长什么样
第二个卡点更隐蔽,因为它表现出来的不是「不出东西」,而是「每次出的东西都不一样」。
同一份需求,今天给你一张表,明天给你一段散文,后天给你一个没有编号的清单。用一次还行,要用十次、二十次,就得每次重排一遍。
根因不在流程,在缺一个「成品的样子」。
「输出格式规范的测试用例」
「按下面这个表头输出,一行一条,字段名不要改」
说形状,不说形容词
前者是形容,后者是形状。AI 对示例的服从度,远高于对描述的理解度。 你给它一个样子,它基本照着那个样子来;你只描述「要规范」,它就按自己的审美给你一个「规范」。
所以从今天起,「输出长什么样」这一节一定要有东西,哪怕只有三行:
## 输出长什么样
| 用例ID | 场景 | 输入 | 预期结果 |
|---|---|---|---|
| TC-001 | 参数缺失 | 不传 phone | 返回 400,提示「手机号不能为空」 |
注意最后那行:它不是一条真实用例,是一个「长什么样」的样本。有了它,AI 就知道「预期结果」那一栏要写成一句能判断对错的话,而不是「系统应正确处理」。
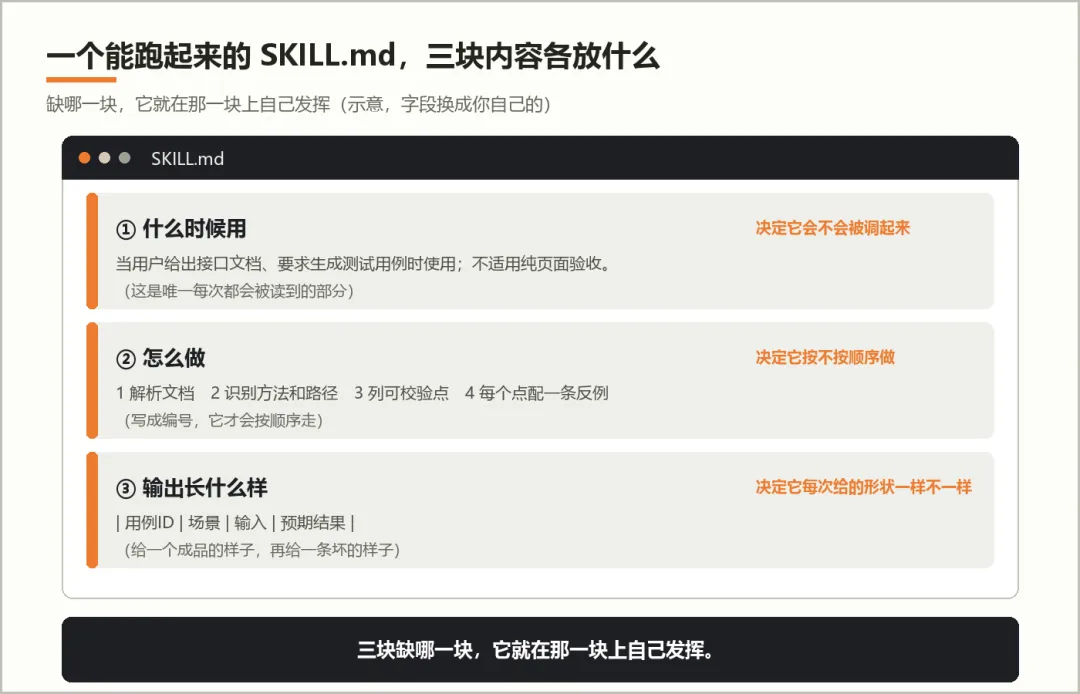
这里还有个频繁被忽略的细节:示例里最好带一条「坏的样子」。 比如在同一节里补一句「不要输出『系统应正确处理』这种预期」,比只说「预期结果要明确」有效得多——人对反例的记忆比正例牢,模型也一样。
(功能测试做了两三年的(P2),你手上一定有那种「别人写就得打回来重写」的模板。那份东西直接贴进文件就行,它比任何教程都好用。)
STEP 03
卡点三:一份文件塞了三件事
前两个卡点都在「怎么写」,这个卡点在「写多少」。
SKILL.md 最容易变成一锅粥:写用例的规则、出报告的格式、分析日志的步骤,全塞在一个文件里。你以为是「一次搞定」,实际结果是:
一句话:一份 Skill 只干一件事。 这不是洁癖,是它每次执行只能带一个明确的意图。
那到底该放什么?有一个挺好用的分法:
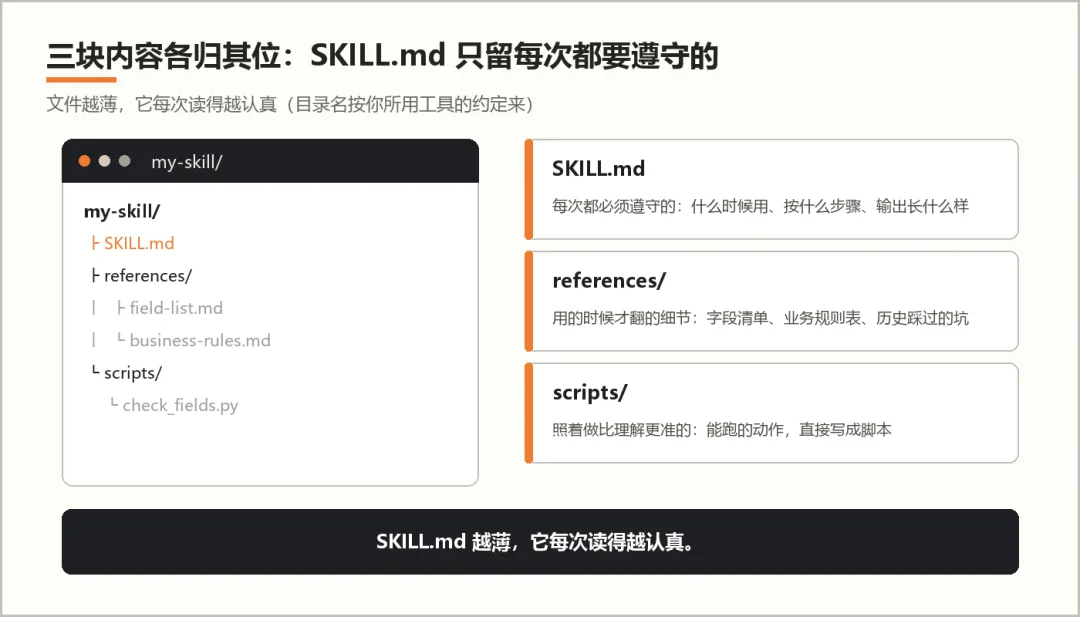
STEP 04
反过来查:按症状倒查
到这里三个卡点都过了一遍,但实际排查的时候,它们不是按顺序来的——你是先看到「不好用」,再往回找原因。所以给你一张按症状倒查的表:
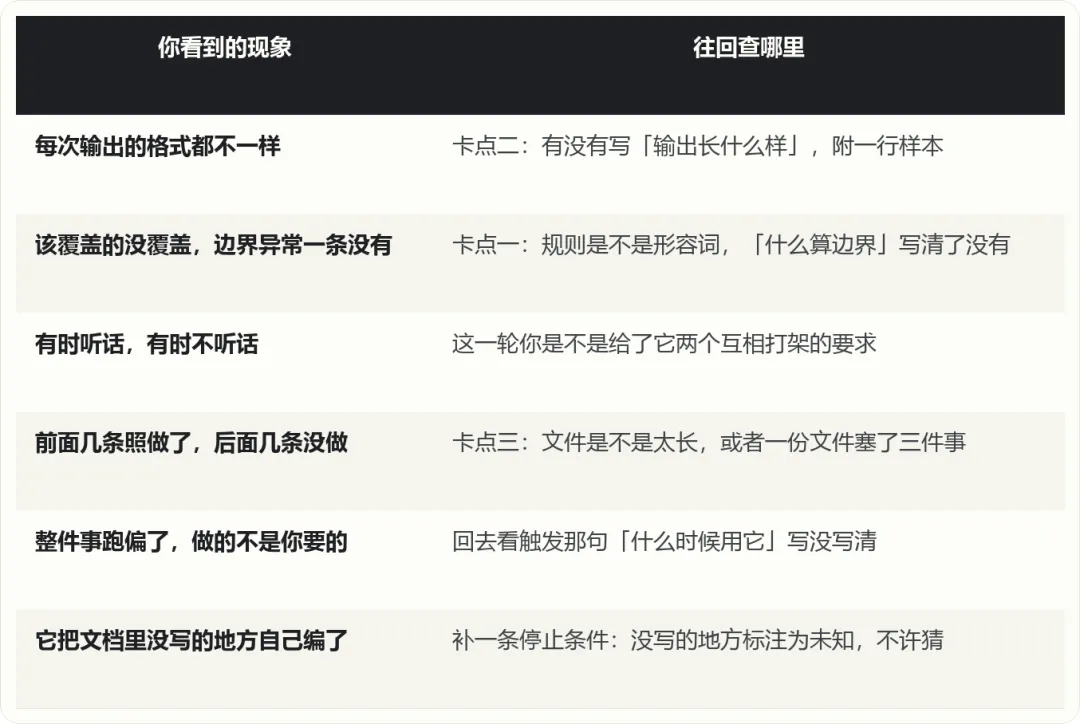
这张表建议存下来。用法很简单:下次它又不听话,先别急着改文件,先对着症状找那一行。
顺着往下说一个反复出现的场景:它有时候听话,有时候不听话。
这种情况十有八九不是「随机」,是你在这轮对话里给了它两个互相打架的指令——比如文件里写着「预期结果要写成具体断言」,你临时又说「先给我一版简单的看看」。它不会告诉你这两条冲突了,它只会挑一条执行,而挑哪条你猜不到。 遇到这种,先回去数一数你这轮到底提了几个要求。
STEP 05
但也不是写得越死越好
最后必须说清楚一件事,不然容易用力过猛。
前面讲的都是「把话说死」,可写死是有代价的:规则越密,它在边缘情况上的灵活度就越低。
举个具体的。你把「长度字段取 8、16、32 三个值」写死,遇到一个上限是 20 的字段,它照样去试 32——它严格照做了,但结果不对,因为它不知道这条规则的意图是「试到边界附近」。
所以取舍是这个样子的:
「规则写得越细越好」
「每条规则都要写清意图,判据才有适用边界」
写死是为了稳定,不是为了僵化
一个实用的尺度:凡是「错了会出事」的,写死;凡是「错了只是不好看」的,给个示例就行。 前者比如断言怎么写、字段怎么命名;后者比如段落顺序、措辞风格。
还有一条边界得提前说:不是所有活都值得封成 Skill。如果这件事你只做一次,或者你自己都还说不出「什么算做对了」,那先别封——标准还在飘的时候,写进文件里的就是错的标准。 这条 24 讲过,这里只提一句。
(准备跳槽的同学(P3)注意:面试被问「你怎么写 Skill」,只答「我会写 SKILL.md」很单薄。答「我会先看它有没有可判对错的判据、有没有输出样本,缺哪样先补哪样」,这句背后是你真的排查过。)
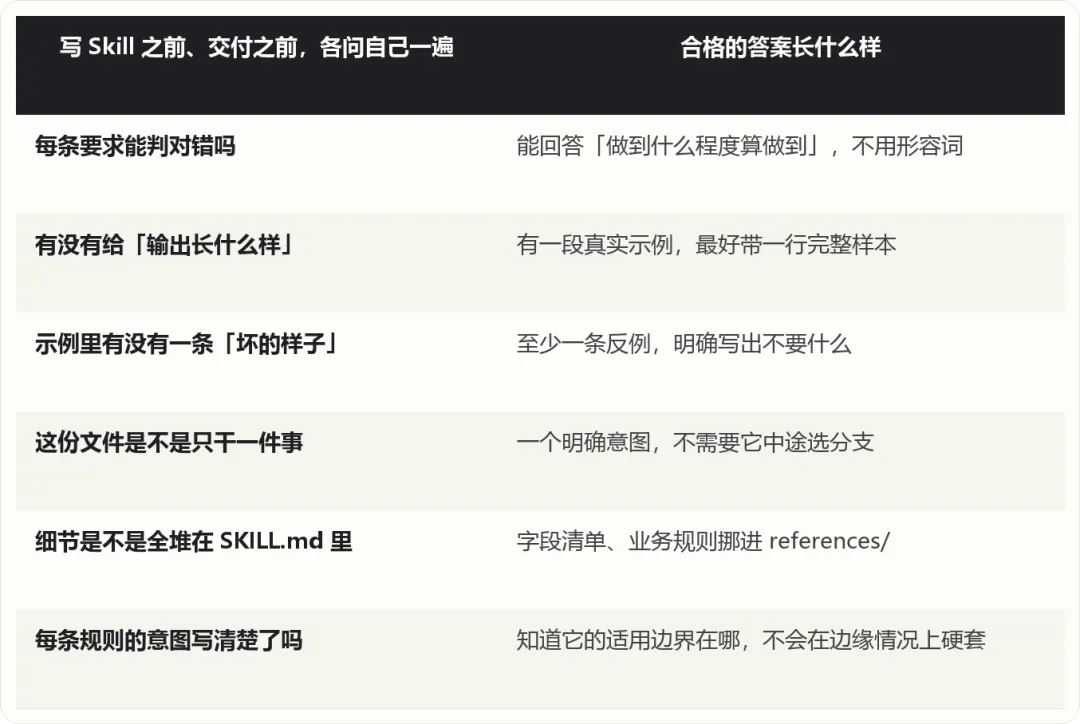
把今天这些收成一张开工前的清单,建议存下来——写 Skill 之前、交付之前,各过一遍这六问:
我是阿蔡