ARTICLE · 1191443
长文档问答,先别急着切块
面对一份几百页的财报、制度或技术手册,最常见的 RAG 做法是:切成小块,算向量,按相似度召回。
这条路简单,但它把“相似”当成了“相关”。当答案藏在章节关系、上下文或多个表述之间时,搜到几个相似片段,不一定等于找到了应该读的地方。
今天 GitHub Trending 第 17 的 VectifyAI/PageIndex,给出的思路很具体:先把文档组织成层级树,再让模型沿着这棵树做推理检索。它不是声称所有问答都会更准,而是把“从哪里找到答案”变成可以追踪的阅读路径。
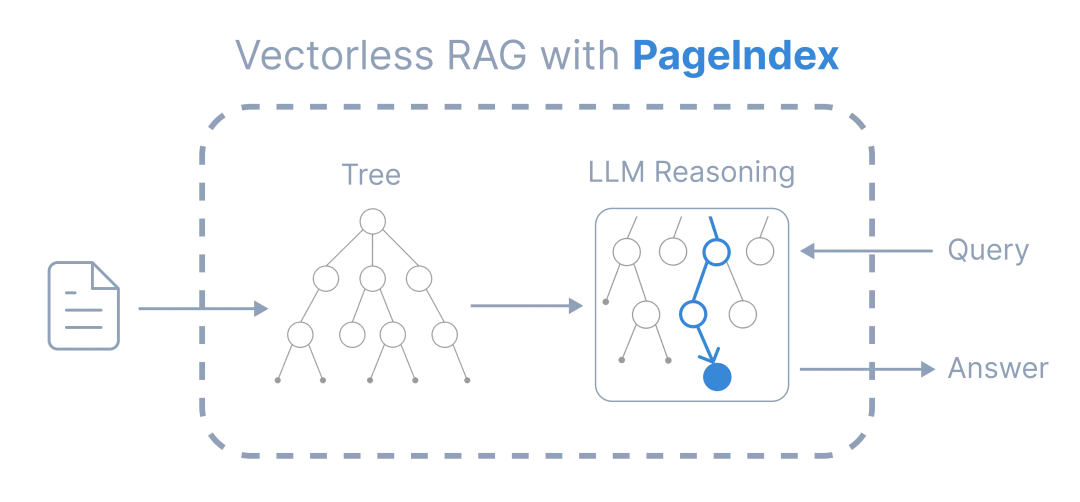
先建树,再沿树找答案
PageIndex 的关键变化不在“换一个 embedding 模型”,而在索引对象变了。
传统向量 RAG 把文档切成许多彼此相对独立的块;PageIndex 的 README 描述的是层级树:文档的章节、子章节和内容节点保留在同一结构里。提问时,模型不是只在一堆相似片段里排序,而是先判断应该进入哪棵树、哪一支,再读需要的上下文。
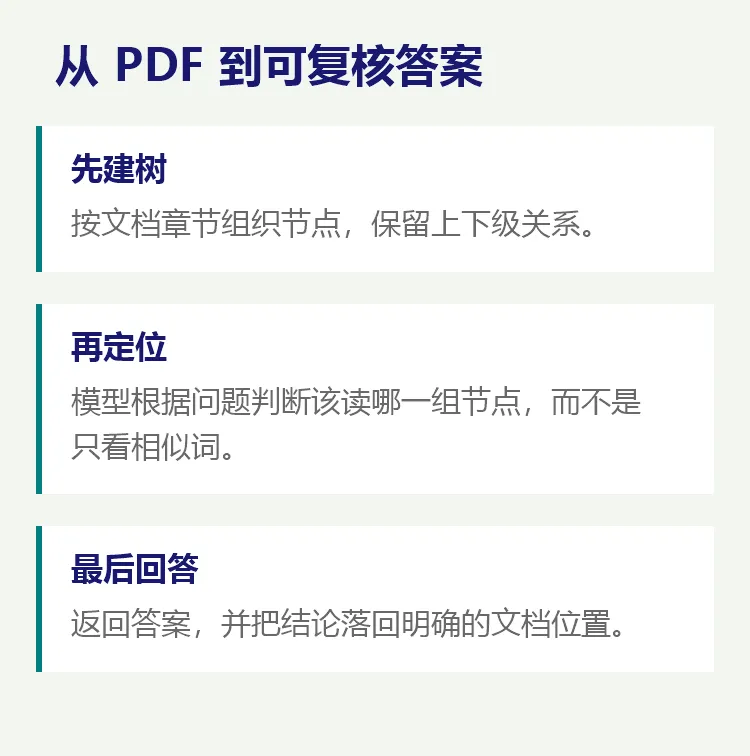
这带来一个适合长文档的检查点:答案不只是“看起来像对的文本”,还应该能回到明确的章节或节点。对财报里的指标、合同里的例外条款、技术手册里的前置条件来说,这个回溯位置往往比一句流畅回答更重要。
官方示例的最短路径
项目 README 给出的 SDK 路径很短:安装 pageindex,用 PageIndexClient 提交 report.pdf,再针对一个具体问题调用 client.chat。示例问题是“2023 年的营业利润率是多少”,输出应该继续回到原文,而不是把整个 PDF 每次都塞给模型。
这只是官方示例,不是本轮实测。真正接入时,建议把第一个问题限定得足够窄,例如“某年度经营利润率位于哪一节,数值是多少”,同时保存文档版本、问题和引用位置。这样才能判断错误究竟来自索引、定位还是回答。
什么时候值得换成树检索
PageIndex 不是所有文本的默认替代品。短文档、关键词明确、上下文很少的查询,普通检索可能已经够用;引入树结构和模型推理,也意味着要接受额外的索引与调用成本。
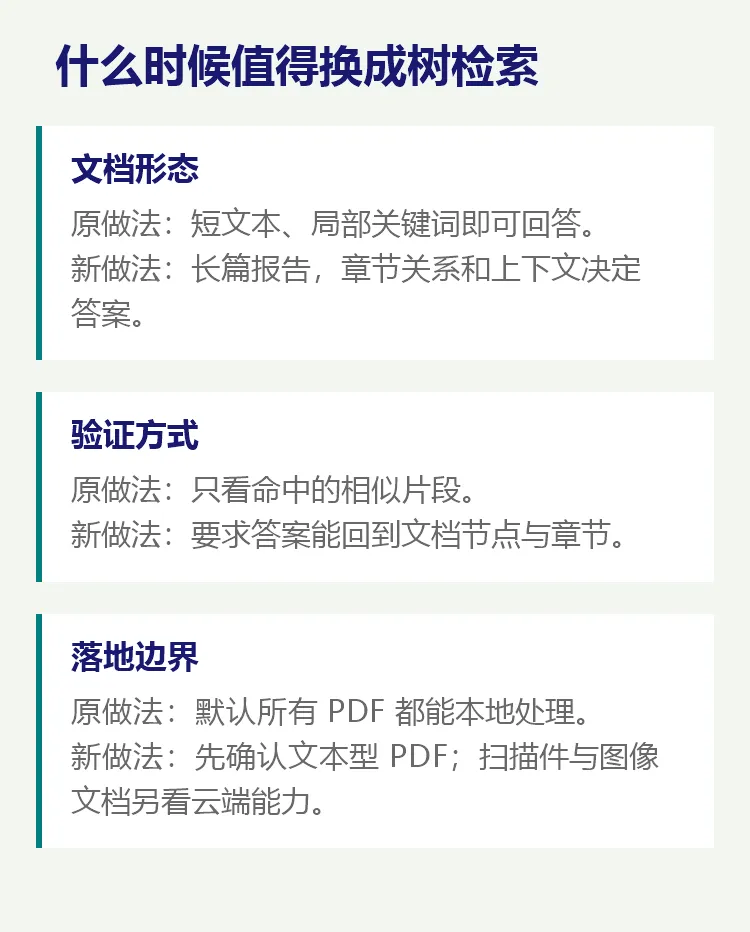
更适合试它的,是“答案依赖结构”的材料:一份年报中跨章节的指标定义,一套制度中带例外条件的条款,或一册技术手册里需要先读前置条件再读操作步骤的章节。这里的价值不是把检索包装得更聪明,而是让检索过程保留文档的组织方式。
先看清本地模式的边界
README 目前把本地模式描述为适合文本型 PDF:索引、检索和聊天可以在自己的机器上完成,但扫描件、图像丰富的文档、OCR 和图像理解属于 PageIndex Cloud 的能力范围。也就是说,“不使用向量数据库”不等于“完全离线”,更不等于“任何 PDF 都能本地处理”。
这条边界直接影响采用决策:如果手里是可复制文本的研究报告,可以先做一个小样本;如果是扫描合同或图表密集的材料,先确认解析和数据传输要求,再谈效果。
这些数字能说明什么,不能说明什么
项目 README 公布了几组项目方结果:本地索引成本约为每页 0.001 美元;在项目方列出的 FinanceBench 评测中达到 98.7%;另有把整份 PDF 直接交给模型与 PageIndex 检索成本进行对比的数据。
这些数字可以帮助读者理解项目方主张的测试范围,但不是本轮复测,也不是对你的文档、模型和费用的承诺。尤其是 FinanceBench 的准确率,不能直接换算成你的财报问答准确率;接入前仍应固定文档集,记录引用是否正确,并把失败案例分成“没找到”“找错章节”和“读错答案”。
一个务实的试用顺序
选一份允许测试的文本型 PDF,记录版本和页数。 只提出一个能在原文中定位的问题,不先追求开放式总结。 对照 PageIndex 返回的引用位置,检查它是否真的覆盖了答案所需的上下文。 再拿同一个问题与现有向量检索做对照,比较的是可追踪性和失败类型,不只看一句话是否流畅。
如果这四步都无法稳定完成,继续堆模型或扩大文档数量,通常只会把问题藏得更深。
项目入口:VectifyAI/PageIndex。
欢迎关注公众号,后续每天一起看一个高质量开源项目:不堆名词,只看它解决什么问题、怎么上手、能不能用到真实工作流里。