ARTICLE · 1198905
50 页文档喂给 AI,怎么问才不跑偏?
你把一份 50 页的行业报告(也可能是合同、论文、会议材料)丢给 AI,问一句“帮我总结一下”。
它给你 300 字,读起来很顺,用词也专业。但你要找的那个具体数据、那条例外条款、那句关键结论,它没提;你再追问,它开始含糊,甚至编出一个看起来很合理的数字。
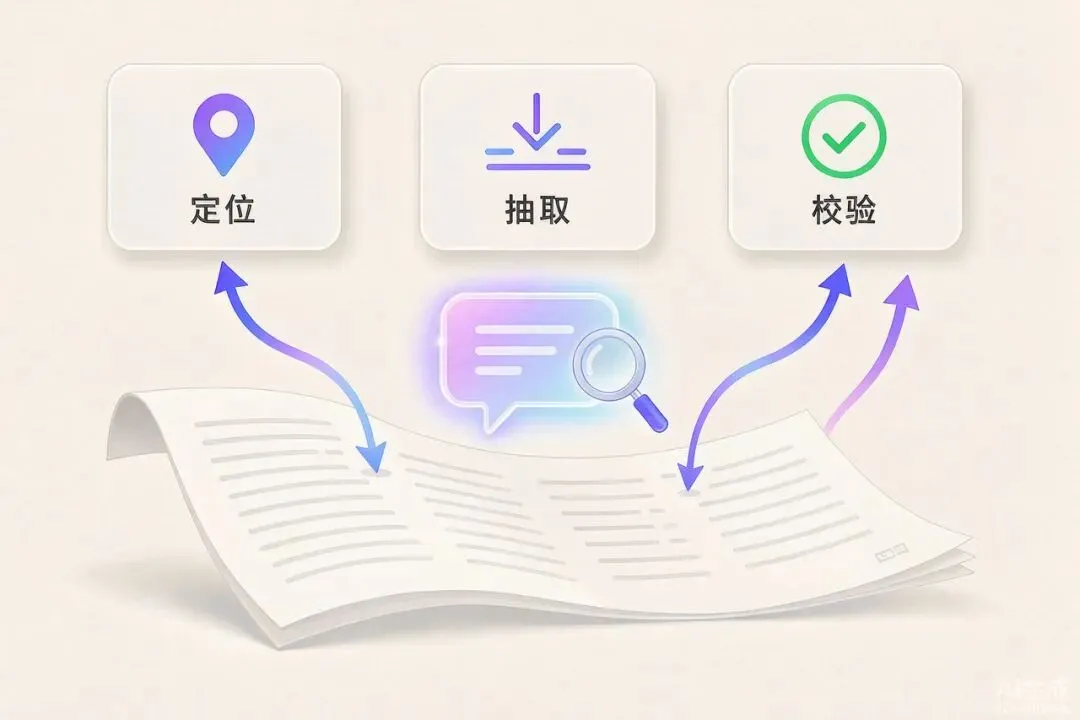
问题不在模型,在于你只给了它“要总结”的指令,没给它一张“地图”。长文档处理的难点从来不是“读不懂”,而是三点:找不准、抓不全、验不了。
下面这套“定位—抽取—校验”三步法,是处理长文档最实用的一套打法,从 20 页到 200 页都适用。
干货一:先要“目录索引”,别急着要结论
大多数人第一步就错了——直接要总结。正确的第一步,是让 AI 先建一份带位置的索引。可以这样问:
这是一份 XX 文档(说明文档性质和页码范围)。请先只做一件事:列出文档结构——章节标题 + 页码范围 + 一句话说明每部分在讲什么。不要总结内容,不要评论,只做目录。看不清或无法确定的部分,直接标“不确定”,不要猜。
这一步的价值在于,你会立刻发现两件事:一是 AI 到底“读进去”了没有——如果连目录都很离谱,说明投喂方式有问题,别往下走了;二是你关心的那个点在文档第几部分。拿到“位置”,后面才能精准提问。
关键动作:给文档加上“身份”。别只说“这是文档”,要说“这是一份 2025 年的设备采购合同,共 42 页,我是甲方”。文档类型 + 篇幅 + 你的立场,这三样决定了 AI 用什么标准去读它。
干货二:带着“页码”提问,而不是带着“感觉”提问
索引建好之后,提问方式要换:
1. ✕ 模糊提问:“这份报告对行业前景怎么看?”
2. ✓ 定位提问:“请只根据第 12—18 页,列出报告对 2026 年市场增速的三个判断,每条注明原句位置。”
差别在哪?定位提问把“检索范围”和“回答格式”都锁死了。再加三个实操细节,效果差别很大:
1. 要求“引原文”:每条结论后面附上文档原句。附不出来,说明它可能没找到,是“编”出来的总结。
2. 给“找不到”留一条出路:明确告诉它“如果文档里没有相关信息,直接回答‘文档未提及’,不要用常识补充”。这一句能挡掉大部分幻觉——AI 编内容的成本很低,你不给它出口,它就会顺着问题往下编。
3. 一次只问一类问题:想同时要数据、要结论、要风险,就分三轮问。混着问,它往往只认真回答了最简单的那一问。
干货三:最后一步,让它自己“挑错”
拿到答案别急着用。第三步是反向校验——最容易被跳过、也最值钱的一步。换一个提问角度:
现在请以审稿人的立场,检查你刚才给出的结论:哪几条是文档明确写的?哪几条是你推断的?哪些地方你不确定、需要我回原文核对?请把“文档明确写了”和“我推断的”分开列。
它会自己把不确定的部分标出来。这些被标出来的地方,就是你真正需要人工核对的地方——把你有限的注意力,集中到最可能出错的那几处。
还有一个进阶动作:把结论倒着问一遍——“如果我持相反观点,文档里有哪些内容可以支持我?”这一步能发现被单一视角掩盖的信息,特别适合读方案、读评估报告。
总结
长文档 + AI 跑偏,根源往往不是模型能力,而是提问方式:
1. 先要索引,再要结论——先建“地图”,确认它真的读进去了。
2. 给文档“身份”,带着页码提问——用“第几页 + 要什么 + 什么格式”代替模糊提问,并给“找不到”留出口。
3. 最后做反向校验——让它自己区分“原文写的”和“它推断的”。
这三步几乎不增加操作成本,却能把 AI 从“看起来答得挺好”变成“每条都能回到原文核对”。
长文档处理,本质上不是让 AI 替你读,而是让它帮你标出“该读哪里”,指出“哪里不确定”。剩下的判断,还是你的。