ARTICLE · 1203102
给 AI 助手配一个「外包团队」:DeepSeek Harness 连接器开发全记录
这篇文章记录完整过程: 环境勘察、选型取舍、六个工具的设计、四个真坑,以及比代码更重要的那部分——怎么派活。
给主线的 AI 配一个能干活的执行者——它有自己的 shell、文件工具、沙箱工作区和独立上下文,能自己试错、自己验证,只把结论和产物交回来。
写一个脚本、跑通、报告输出,7.0 秒返回。整个过程,主线对话里一个 token 都没被中间产物污染。
问题不在模型强度
写一个脚本要试错五轮。每轮的报错、改法、重跑结果,全堆在同一个上下文里。等脚本终于跑通,窗口已经被中间产物吃掉一半,真正要紧的讨论反而没空间了。
批量改三十个文件更糟。主线要一个个读、一个个写,每个文件的旧内容都进了窗口。
想让模型「自己验证」听起来很对,但验证过程本身又是十几轮工具调用——它占的还是同一个窗口。
我需要的是上下文隔离:
• 真实工具(shell、文件读写)
• 沙箱(不能乱来)
• 独立上下文(脏活不回流)
• 可反复派活(不是一次性)
• 可中断(发现方向错了能停)
答案很清楚:需要一个 agent,而不是一次 API 调用。
摸家底
动手之前做了件容易被跳过的事:搞清楚本机装了什么。
~/.dsh 目录下有两个 profile(desktop 和 headless),profiles/node_modules 里一堆符号链接。看起来像一套,实际是两套:
• 八月从源码拉的 0.1.0-rc.5
• npm 装的 0.1.5-alpha.1
两套都在,符号链接指来指去。第一反应是用新的,但更关键的是差在哪——新版有 dsh-acp-app,旧版没有。这一个包的有无,直接决定连接器能不能做。
教训:先确认哪套在生效,再动手。我对着旧源码调了半小时,报的错全是版本代沟。
为什么选 ACP 而不是 headless
dsh 提供两条程序化的路。
dsh --profile headless "任务" 极诱人。一行命令,任务进、结果出、进程退出。看起来完美。
但它是一次性进程,代价藏在后面:
• 每次冷启动 + 配置合成
• 只拿最终输出,看不到过程
• 想中途停?只能杀进程
• 上下文每次归零,没法「接着上次改」
ACP(Agent Client Protocol)是官方专门给程序化客户端准备的协议层,JSON-RPC over stdio。
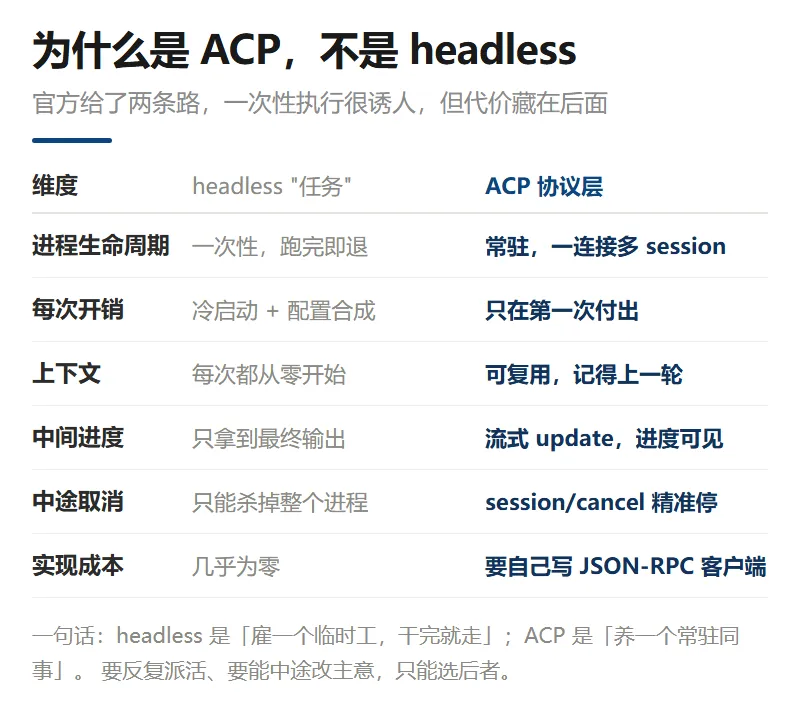
它有四个正好对口的能力:
常驻。 一个进程、一个连接,开多个 session。冷启动只付一次(实测 1.4 秒到可用)。
请求-响应天然对齐。session/prompt 会阻塞到 agent 真正空闲才返回,不用自己判断「干完没」。
可取消。session/cancel 精准停指定 session,不影响别的。
进度可见。session/update 流式推消息、思考片段、工具调用、token 用量。
代价也得承认:要写 JSON-RPC 客户端、管进程生命周期、应答权限请求。大约六百行。
要反复派活、要能中途改主意,只能选 ACP。
四层链路
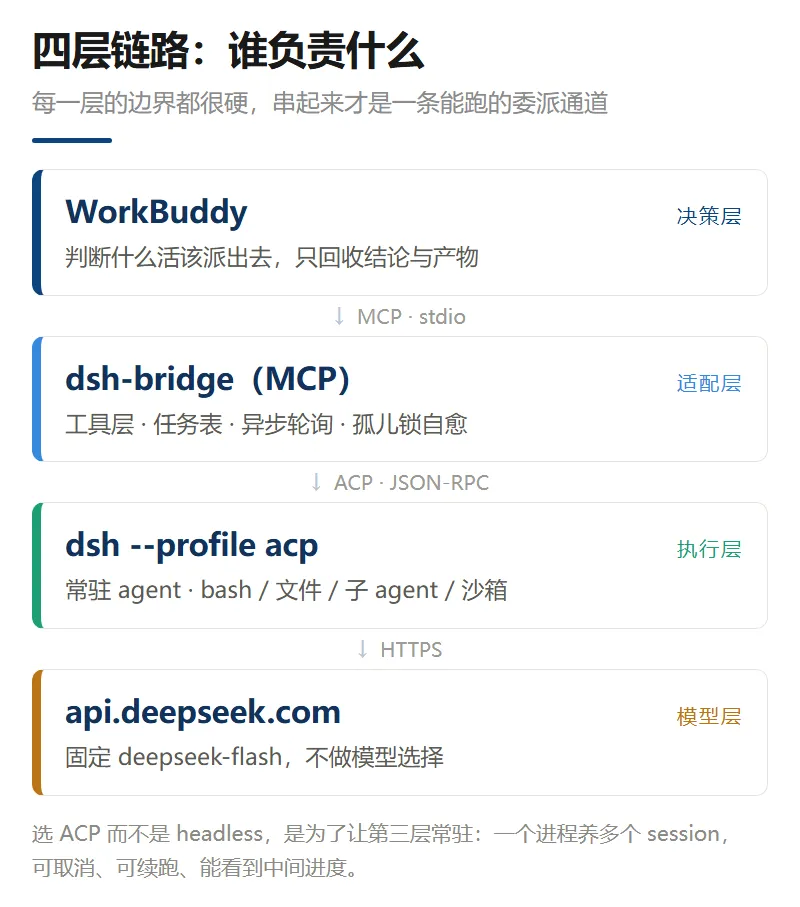
WorkBuddy(决策层) 判断什么活该派出去、怎么拆、结果怎么验收。这层不干具体活。
dsh-bridge(适配层) MCP 工具、任务表、异步轮询、孤儿锁自愈。铁律:stdout 只走协议,日志全走 stderr——因为 MCP 和 ACP 两层的 stdout 都是协议通道,一句 print 就能把链路弄死。
dsh --profile acp(执行层) 常驻的 agent,带 bash、文件工具、子 agent 和沙箱。
api.deepseek.com(模型层) 固定 deepseek-flash。为什么只留一个模型,后面单独说。
有个不显眼但重要的决定:我新建了专用 profile(~/.dsh/profiles/acp/),而不是复用 desktop 或 headless。
profile 本质是「插件树的组合声明」。独立一份,才不会动现有的桌面 UI 配置;改坏了也只是这一个坏,删掉重建就行。
六个工具
链路通了只是及格。真正决定好不好用的,是工具怎么切。
dsh_delegate | |
dsh_result | |
dsh_status | |
dsh_cancel | |
dsh_sessions | |
dsh_health |
三个关键设计,都是被现实逼出来的。
必须异步。 MCP 的工具调用是同步的,长任务会被超时掐断。所以 dsh_delegate 带个 wait_seconds(默认 45):短任务一次拿结果,等不完就返回 task_id,之后用 dsh_result 轮询。一个入口同时覆盖「问一句」和「跑半小时」。
进度必须可见。 我把 ACP 推来的工具调用序列、思考片段、token 用量收进一个环形缓冲。dsh_status 能报「现在跑到哪一步了」。没这个,长任务就是黑盒——你不知道它在认真干活还是卡住了。
session 必须能续。 多轮迭代是常见需求:「按上面的意见再改一版」。每次都开新 session,它就从零开始,前面所有上下文白费。所以返回里带 session_id,下次传进去就行。
实测第二轮:0.9 秒答出上一轮写进文件的内容。KV 缓存直接命中,快到不像话。
派活准则比代码重要
这是全文最想说的部分。
代码六百行,写两天。但「什么时候派、怎么派」决定这套东西是资产还是玩具。
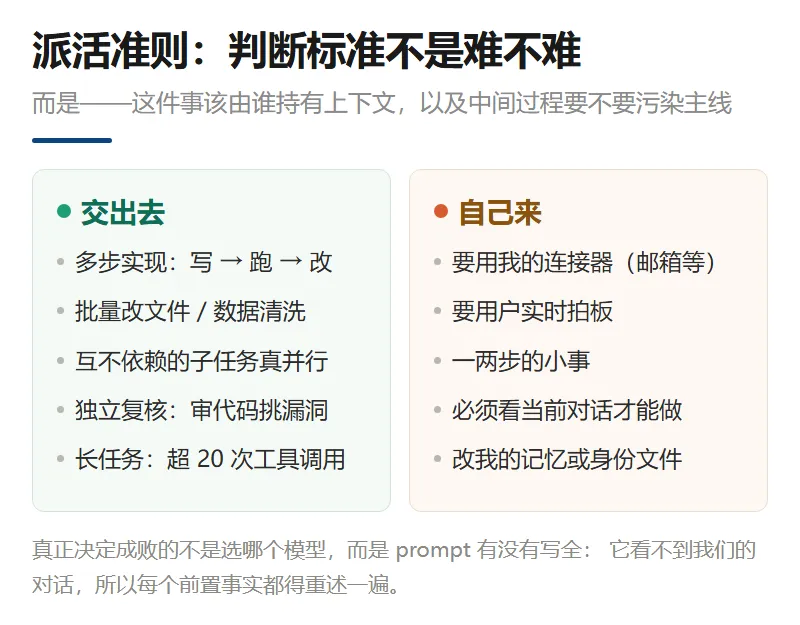
我专门写了份行为准则放进技能库。判断标准不是「这事难不难」,而是两个问题:
1. 这事该由谁持有上下文?
2. 中间过程要不要污染主线?
七条铁律
给一个「看不到你对话」的执行者派活,缺一条就会翻车:
自包含。 它不知道我们刚聊了什么。所有前置事实、背景、约束、验收标准,全写进 prompt。
绝对路径 + 明确工作目录。 沙箱只允许在指定 cwd 里读写,写外面会失败——那是策略,不是 bug。
明确交付物。 要么给具体文件路径,要么给回答格式(「只回 JSON」「列三个方案各两句」)。
要求自验证。 让它跑起来、测一遍、把实际输出贴出来。不要接受「应该可以」。
约束外部副作用。 不 push、不发消息、不删数据、不动目录外的东西。
输出要短。 要结论 + 证据 + 文件路径,不要贴大段代码。
一次一个目标。 多目标拆成多个 session,别塞进一个 prompt。
一个反例
错误写法:
如上所述,把这个文件改一下。
它完全不知道「这个文件」是哪个,也不知道「如上所述」是什么。
正确写法是重述全部事实——哪怕你觉得啰嗦。不是它笨,是你没把话说全。
四个坑
一把没人管的锁
这是最隐蔽的一个,也是我第一次真被卡住的地方。
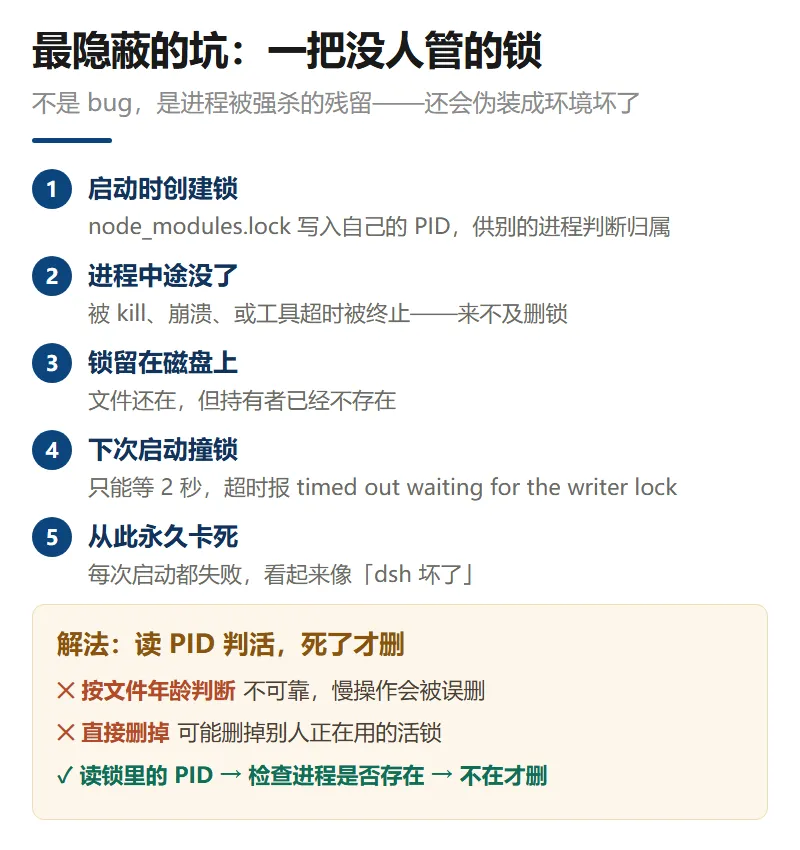
dsh 启动时会在 ~/.dsh/profiles/ 下创建 node_modules.lock,内容就是自己的 PID。这是跨进程写锁,防止两个进程同时改符号链接。
问题在于等待上限只有 2 秒。
如果进程拿锁后被强杀——崩溃、工具超时、或者手动终止——锁就留在磁盘上了。之后每次启动都是同样剧本:看到锁存在,等 2 秒,超时,报错。
表象是「dsh 坏了」,实际是一把孤儿锁。
错误解法有两个,我都想过:
• 按文件年龄判断:不可靠,慢操作会被误删
• 直接删掉:可能删掉别人正在用的活锁
正确解法是看所有权:读锁里的 PID,检查进程还在不在,不存在才删。
连接器现在每次启动前自动做这步。只花几毫秒,但把「莫名其妙启动不了」变成了「自动恢复」。
两套安装,两套凭据格式
源码那套 0.1.0-rc.5 要求扁平格式:
DEEPSEEK_API_KEY: "sk-..." npm 那套 0.1.5 要求:
version: 1 refs: DEEPSEEK_API_KEY: "sk-..." records: ... 用错版本,启动直接报「the value for version must be a string」。
这报错极具误导性——看起来像凭据坏了,实际是格式代沟。同一个产品,两个大版本,文件格式不兼容。
模型名根本不存在
配置里默认模型是 deepseek-v4-flash。
我去打了下官方 /v1/models,返回的是:
• deepseek-flash
• deepseek-v4-pro
那个 deepseek-v4-flash 大概是某种内部命名。照抄配置默认值,调用必然失败。
教训很简单:先打一次模型列表,再配置模型名。 别信文档默认值,信接口。
(接口确实同时返回了 pro —— 但「能选」不等于「该用」。这个连接器最终只保留了 flash,理由后面说。)
配置值是 JSON 字符串
ACP 的模型配置项,value 不是 deepseek-flash,而是:
["deepseek-official","deepseek-flash"] 一个 JSON 字符串。直接传裸模型名会被拒绝。
这种「看起来该是 A,实际是 A 的序列化形式」的坑,只能靠读源码或打印真实报文解决。我在连接器里做了层转换:调用方传裸名字,内部匹配成正确格式。
真机数据
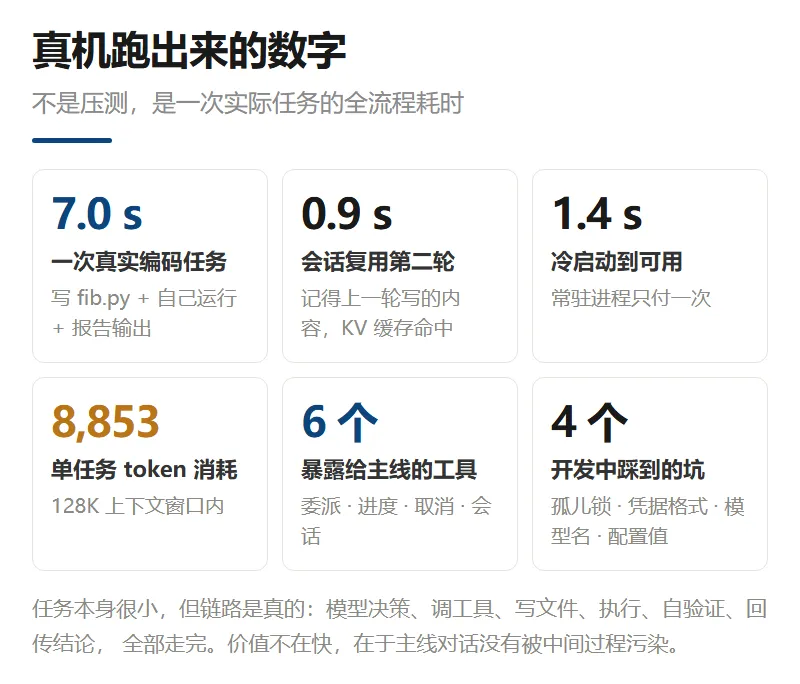
任务本身很小——写个斐波那契脚本、跑一遍、报输出。
但链路是完整的:模型决策、调工具、写文件、执行、看到输出、自验证、回传结论。全部走完,七秒。
价值不在快。价值在于:这七秒里,我的上下文一点没被占用。
约束要下沉到能力层
上线后加了条硬约束:这个连接器只用 flash,不许用 pro。
一开始的做法很自然——写进说明文档,「默认使用 flash」。但这是最弱的约束:它依赖执行者每次都记得。文档会被略过,参数会被顺手带上,半年后连写的人都不记得当初为什么这么定。
所以改成了两层。
让另一个选项不存在。 harness 的模型目录里只声明 flash。ACP 会话因此只能看到一个选项,session/set_config_option 根本到不了别的模型。不是「不许选」,是「没有可选」。
让错误立刻暴露。 接口层收到非 flash 的请求直接报错,而不是静默忽略。静默忽略最坏——你以为切到了 pro,实际一直在 flash 上跑,两边都不知道。
验证方式也直白:把 harness 自己写的会话日志解压出来,全文搜一遍模型名。只有 deepseek-flash,一个 pro 的影子都没有。
这条经验比连接器本身更通用:
约束要下沉到能力层。 约定靠记性,能力靠结构。凡是「以后别忘了……」的规定,最后都会忘。
顺带说一句,锁死模型不等于干不了难活。难度可以靠三件事兜:把 prompt 写清楚、把任务拆小、调高思考预算。写脚本加自验证这种活,flash 几秒就完事。
边界
诚实讲,这套东西有明确的不能:
只收文本。 这条链路目前 image=false,发不了图。要给图,得先落盘再让它读文件。
沙箱是 workspace-write。 只能动工作目录里面的东西。动外面会失败,这是设计,不是缺陷。
它看不到我们的对话。 你说的「那个」「上面那个」,它永远不懂。所有指代都得展开。
问不了人。 它没有向用户提问的通道。需要人拍板的事,别派给它。
权限自动放行。 我把权限请求设成自动 allow(本地受信环境),安全边界靠沙箱,不靠审批。这是个有意的取舍——要严格审批,改成 reject 或接人工确认就行。
一点反思
做完这套,我改变了一个看法。
与其把模型调得更强,不如把「怎么用」设计对。
同一个模型,扔在混乱的对话里,就是个会聊天的搜索框;给它清晰的任务边界、独立的上下文、可验证的交付标准,它就能干活。
所谓「超级连接器」,超级的不是那条管道,是协作协议。
通道谁都能写。难的是知道什么该交出去、怎么交、交完怎么验收。
下一步想试的:多 agent 并行做同一件事,交叉比对结果差异——用不一致性来定位不确定性。这可能是比「让一个模型多想想」更可靠的办法。