ARTICLE · 1203600
经济论文 | 从职业史到下一职业概率:AI就业影响与职业发展研究解读
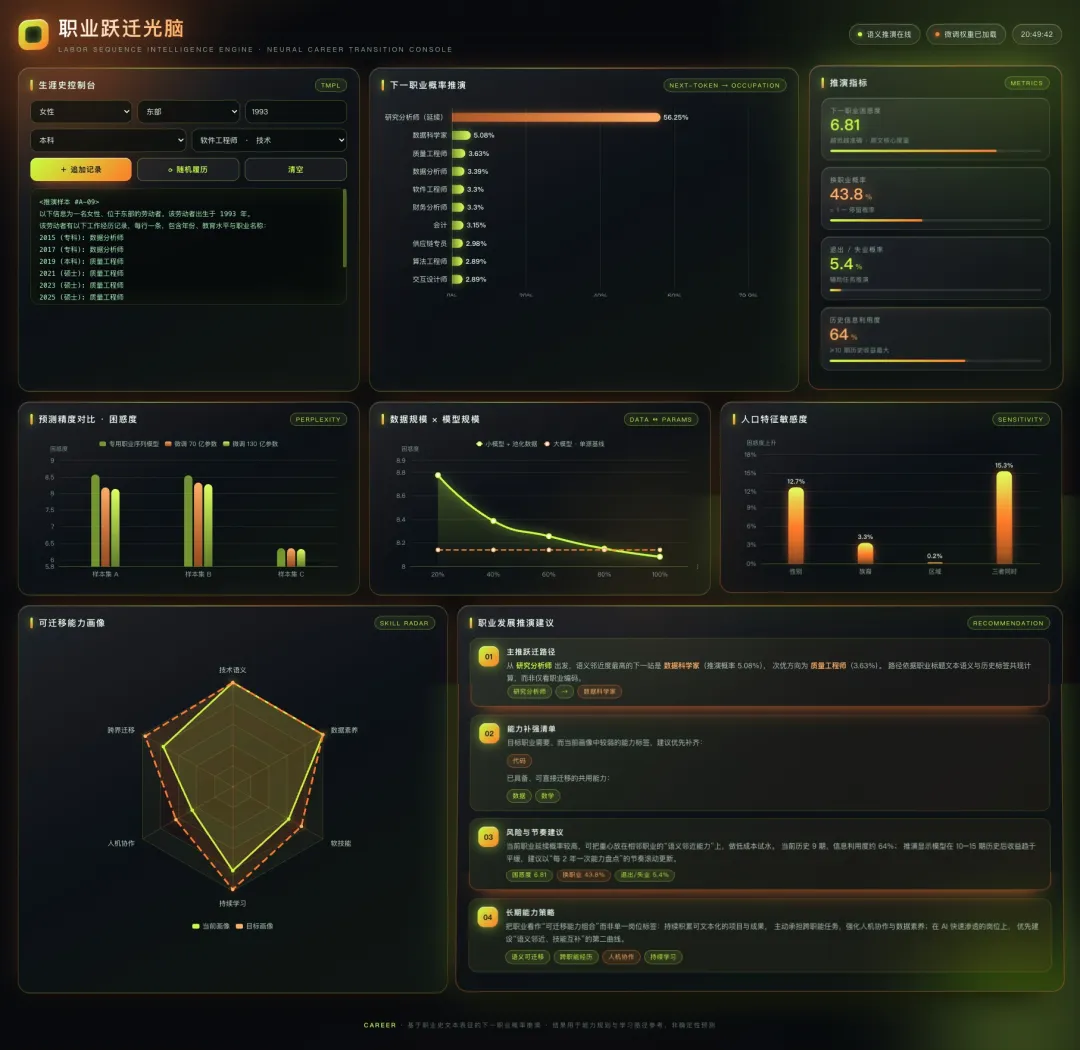
从职业史到下一职业概率:AI就业影响与职业发展研究解读
职业史可以被“文本化”,下一职业是离散选择
文章研究要解决的问题是:给定一名劳动者的职业历史与协变量,预测其下一期职业。难点在于高维特征空间与大规模离散结果空间:当有335种职业时,期可能形成种职业序列,模型还要输出335个下一职业概率。传统做法常用少数汇总统计量概括职业史,或聚焦较粗结果;该研究则把职业史转换成类似简历的自然语言段落,再用大语言模型的“下一词预测”能力估计下一职业概率。
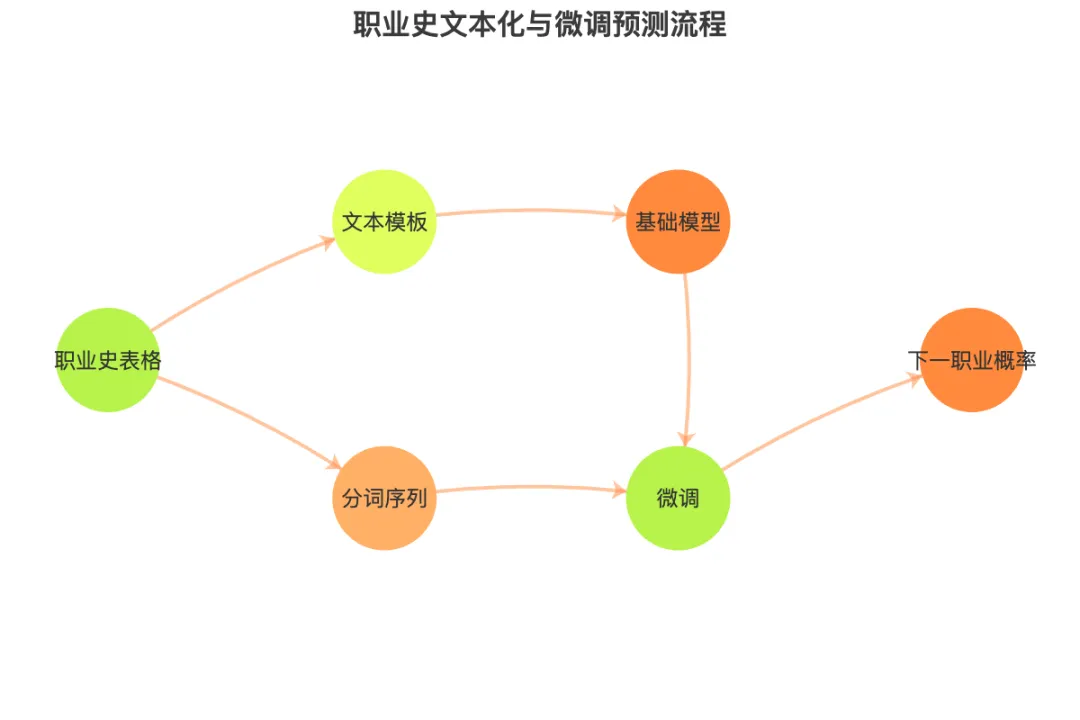
论文的核心建模思路可概括为:先把表格型职业史通过文本模板转成文本,再以基础模型为起点进行微调,最后用下一token概率诱导职业转移概率。其经济含义是:职业不是孤立标签,职业标题、教育、人口特征与历史路径共同构成“语义上下文”;语言模型可在这种上下文中学习职业之间的相似性与转移结构。
方法框架:基础模型 + 微调 + 下一token概率
论文采用“基础模型—微调”范式:先在大规模、非代表性数据上估计基础模型参数,再用较小但更贴近目标人群的职业调查文本进行微调。微调目标仍是下一token预测,因此模型同时学习文本模板结构、职业标题语言结构与职业转移条件分布。原文将语言模型诱导的职业模型定义为:
其Transformer形式可写为原文的多项logit表达:
论文用困惑度评价职业模型:
解读:困惑度是样本对数似然的负单调变换,越低表示对真实下一职业的预测越准确。微调不是简单“套用通用聊天模型”,而是把职业序列文本的条件分布对齐到目标数据;未微调模型可能生成听起来合理但无效的职业标题,即“幻觉”。文本模板的好处是无需固定表格格式,可处理缺失、非平衡面板、不规则采样间隔,并可把职业描述、成果等文本纳入同一管线。
预测性能:粒度职业预测与辅助任务同时改善
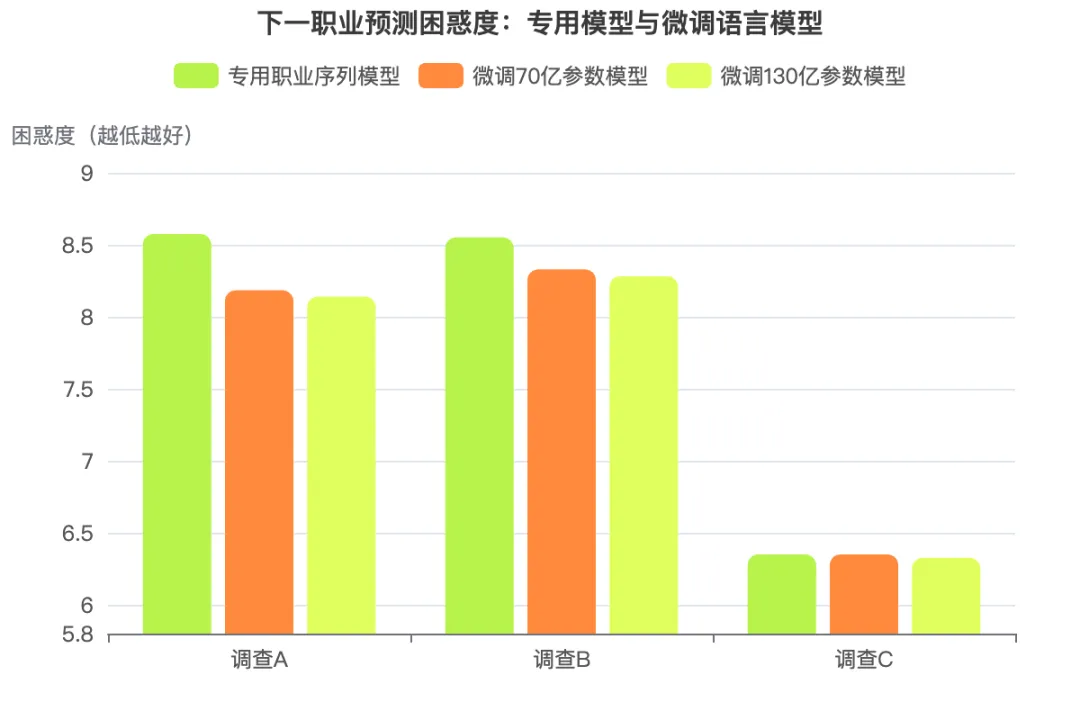
论文结果显示,微调后的语言模型在粒度下一职业预测上优于专用职业序列模型;在“是否换职业”“是否失业”“是否退出劳动力市场”等辅助任务上也表现更好。尤其值得注意的是:微调后的模型不仅困惑度更低,而且在“留下/换职业”的二分类校准上更好;语言模型没有专门为“停留概率”设计两阶段结构,却凭借大参数空间与文本语义学到较合理的概率。论文还表明,未微调的开源或商用模型即使能给出看似合理的职业建议,其条件概率精度仍差很多,且会产生无效职业标题;微调显著缓解“幻觉”。
对AI与就业的含义:更好的职业转移预测不是“替代劳动者决策”,而是提升对反事实、处理效应、分解和结构模型的辅助预测质量。预测越细,越能回答“哪些职业转移因某干预而变多/变少”,而不只回答“是否就业”。
数据与模型规模:数据可在一定程度上替代参数
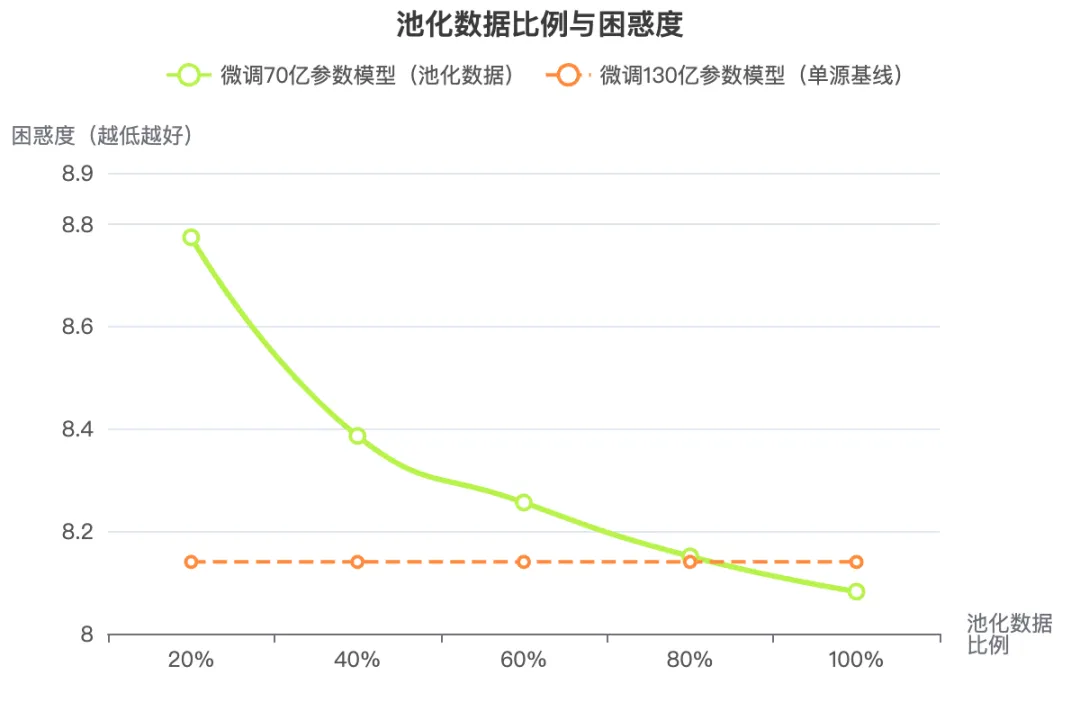
论文发现:更大参数规模的基础模型通常带来更好预测;但把不同来源、甚至非代表性的职业转移数据加入微调后,较小模型的性能会快速提升,并可匹配甚至超过较大模型。换言之,数据与模型规模之间存在替代关系。对实际应用而言,小模型推理成本更低、部署更容易;但微调成本会随数据量增长,重复微调(如自助法估计不确定性)可能非常昂贵。
论文还提示一个关键权衡:预训练数据非代表性可能带来偏差,但基础模型学到的语言与职业结构知识在该应用中利大于弊;在微调阶段加入非代表性职业转移数据还能进一步提升性能。最佳做法不是简单“越大越好”,而是“基础语义知识 + 目标分布微调 + 适度外部数据”的组合。
语义与特征:职业标题文本和人口交互不可忽略
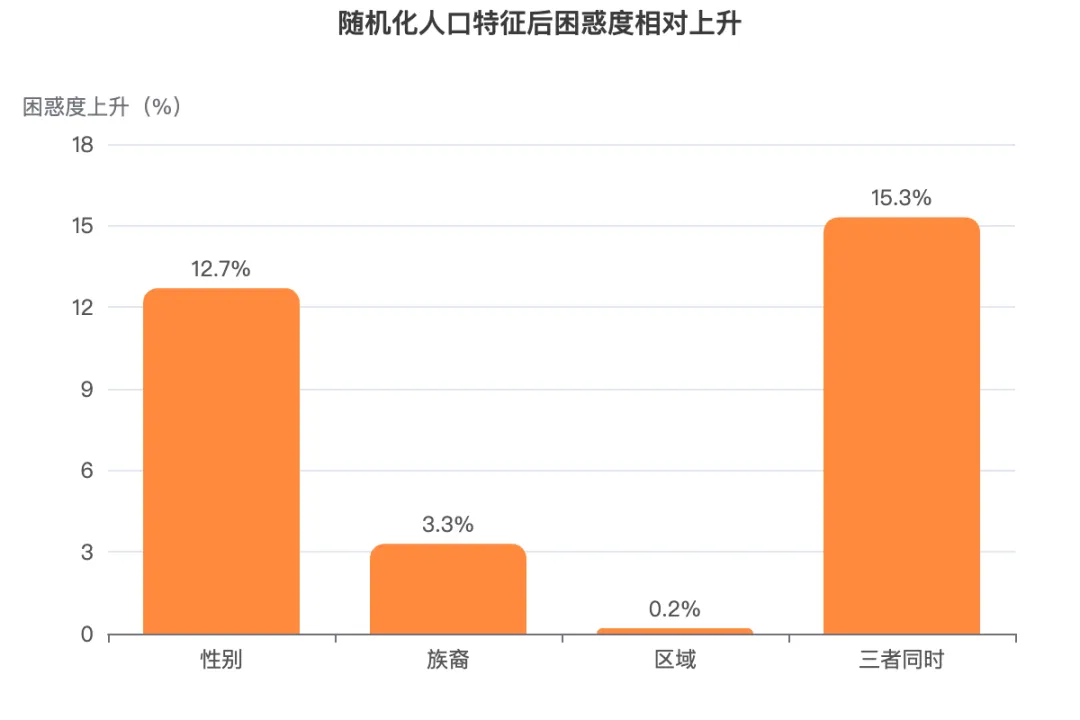
论文通过“把职业标题替换为随机数字编码”检验文本语义的作用:数字编码显著降低预测性能,说明模型确实利用了职业标题的语义内容,而不仅是深层网络结构。另一个重要发现是人口特征的作用:随机化性别会显著提高困惑度,族裔影响约为性别的一小部分,区域单独影响较小;但性别、族裔、区域三者同时随机化时性能下降最大,说明复杂交互对职业转移预测很重要。简单加性回归可能遗漏这些交互。
对AI与就业的启示:职业名称、职位描述、技能文本并非“噪声”,而是可迁移能力的信号。AI招聘、职业推荐与劳动力规划若只使用职业代码,会丢失大量语义信息;但语义信息也可能携带人口差异,需关注公平性与可解释性。
历史长度与异质性:长职业史有价值,复杂跨界转移更受益
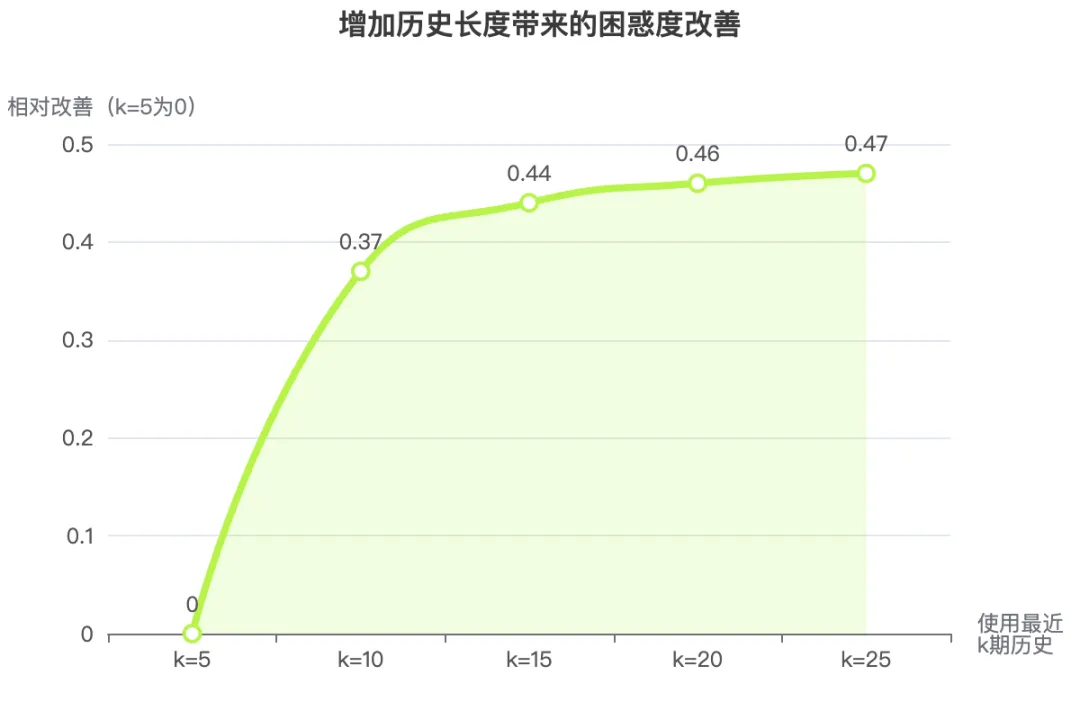
论文显示,模型会利用多年职业史,甚至职业生涯早期信息。将历史截断到最近5期会显著降低预测质量;增加到10—15期后改善最大,之后边际收益递减。对后段职业生涯,10—15年历史已能捕捉大部分预测信息。论文进一步发现,语言模型的相对优势在“较难预测”的转移上更大:跨职业大类、技能相似度较低、职业史较长、复杂劳动市场调整时,文本语义能揭示行政职业编码遮蔽的关联。
这意味着:AI对就业分析的价值不只在“预测已知路径”,更在“识别跨职业的可迁移语义连接”。对劳动者而言,早期多样化经历、跨职能项目与可文本化成果可能提高未来路径的可识别性;对组织而言,内部流动与再培训应关注技能语义相似性,而非仅看岗位名称。
AI就业影响:预测能力提升改变劳动经济分析,但需警惕结构变化
论文指出,高质量职业转移模型可服务三类经济应用:因果效应估计、分解、结构估计。因果推断中,处理效应估计依赖辅助预测模型(结果模型、倾向得分)的质量;分解中,估计分解项与估计因果效应在理论上有同构性;结构模型中,职业转移概率是动态劳动市场模拟与推荐系统的基础。更细粒度的预测让研究者能问“哪些职业转移因干预而增加/减少”,而不仅是“是否就业”。
但论文也明确局限:所有预测模型都依赖历史模式,结构变化时期(如快速技术采用、宏观冲击)可能外推不佳;语言模型直接跨两年预测与逐年组合预测虽高度相关(原文报告相关系数0.93),但模型并不被约束为内部一致;概率未显式归一化虽在原文检验中影响很小(有效职业标题集中了>99%概率质量),仍需在应用中检查。对AI就业治理的含义是:用AI预测职业流动时,应把“分布漂移监测、可解释性、公平性审计、与结构模型结合”纳入流程。
未来职业发展建议:从“岗位标签”转向“可迁移语义能力”
未来职业发展可遵循六条原则:
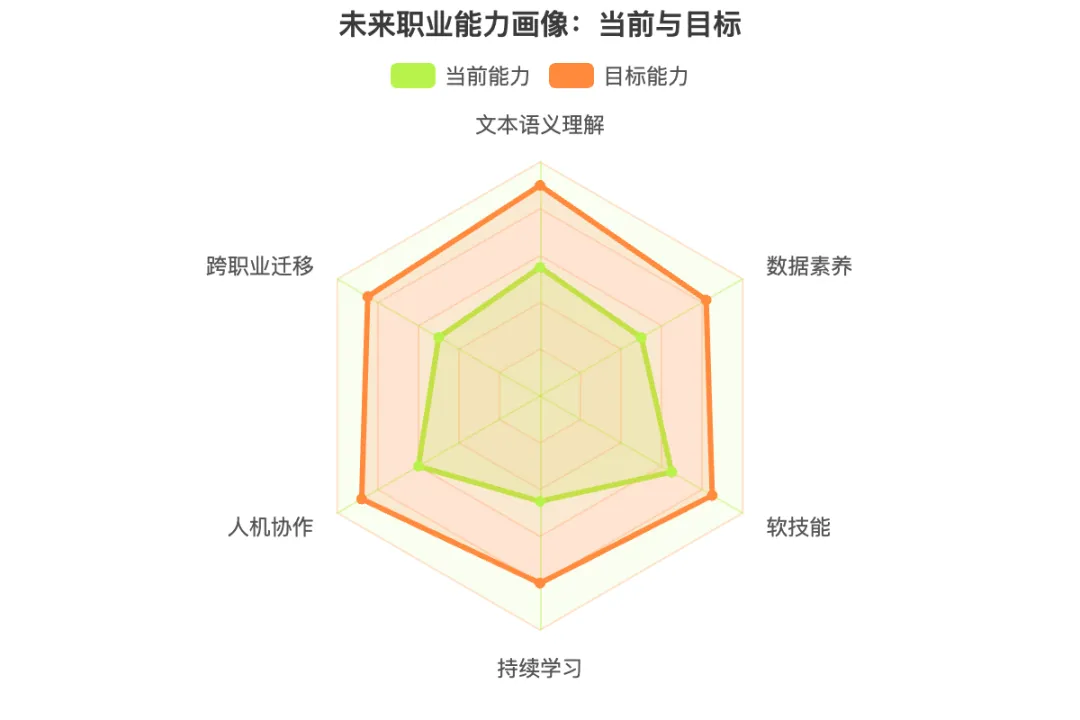
积累可文本化成果:项目、职责、技能、成果描述越清晰,越容易被语言模型与匹配系统识别为可迁移能力。构建跨职能经历:原文显示复杂跨界转移更能体现文本语义优势;跨部门、跨流程、跨客户场景的经历会增强职业路径弹性。强化“人机协作”能力:AI提升预测与匹配,但不替代判断;劳动者应学会用AI做职业路径模拟、技能差距分析,同时保留对分布漂移与偏差的警惕。软技能与数据素养并重:沟通、协作、问题分解、伦理判断与数据理解是跨职业迁移的“语义桥梁”。持续学习与组合式职业:把职业看作能力组合而非单一路径;关注相邻职业、技能相似职业与新兴任务簇。组织与政策层面:用细粒度转移预测支持内部流动、再培训与公平审计;避免只用岗位代码做决策,关注性别、族裔、区域等交互差异带来的机会不平等。
该研究给出的最重要启示不是“语言模型可以替代职业模型”,而是:职业史具有文本语义结构,语言模型可以把这种结构转化为更细粒度、更可校准的下一职业概率。微调是关键,文本标题语义是关键,数据可在一定程度上替代模型规模,长职业史与复杂跨界转移更能体现语言模型优势。对AI与就业的未来而言,劳动者、组织与政策制定者应把职业视为“可迁移能力组合”,用AI增强职业路径识别与再培训匹配,同时对结构变化、分布漂移、公平性与可解释性保持制度性警惕。