ARTICLE · 1204456
10·18 - AI 午报:DeepSeek Flash 换新提速,大银行对 AI agent 关门
今日简介
今天最直接影响日常使用的是 DeepSeek 把 V4.1 Flash 升级到了 V4.1-Flash-1017:官方网页端、App 和 API 已全部切到新版本,调用方式和价格都不变,还是用 deepseek-flash 这个名字访问。官方列出的基准里,Terminal-Bench 4.0 从前代的 31.2 升到 42.3,ProgramBench 从 20.3 升到 29.1;官方同时说新模型任务运行时间和输出长度都缩短了,完成同样的活儿更便宜更快,并专门针对 DeepSeek Harness、腾讯 CodeBuddy、WorkBuddy 等平台框架做了优化。权重同日在 Hugging Face 以 MIT 许可开放,约 7630 亿总参数、1M 上下文。WorkBuddy 国际版也已接上这版模型并限时免费到 10 月 31 日。日常在 WorkBuddy、CodeBuddy 里用 DeepSeek 的人,这几天应该能直接感觉到变化。
安全侧今天有一条要留意:编程工具 OpenCode 披露了一起安全事件,存在其 Console 里的 OpenAI、Anthropic、Google 等第三方 API 密钥可能已暴露,波及约 1.4% 的 Console 用户。agent 的现实约束也在变多:据《金融时报》报道,花旗已禁止第三方 AI agent 登录其数字银行平台的客户账户、操作资金转账,美国银行也有类似限制。消费端隐私则有两件事:Ray-Ban Meta 智能眼镜被曝在没说唤醒词的情况下也在保存对话录音和转录,Meta 称是 bug 且已修复;Meta 还将在 10 月 30 日生效新的商业账号条款,开通其商业工具就等于授权 Meta 抓取企业自己网站的公开内容。
用免费和低价工具的人今天有几个选择:OpenCode 把智谱 GLM 5.3 Flash 免费开放给平台用户;Gemini 4 Argon 进入 AI Studio 的 Build 和 Playground,Google AI Pro、Ultra 付费订阅可用;Perplexity 以 Apache 2.0 开源了内部 agent 沙箱 SPACE,JetBrains 则开源了面向编程 agent 的 12B 模型 Mellum 2.1。新模型一波接一波:Perplexity 开源两款决策模型、Liquid AI 的 d1-ultra 登顶决策模型榜、OpenMOSS 开源文生图 MOSS-Image、初创公司 Elorian 发布能在推理中途回看画面的视觉思考模型 Glimpse。Waymo 的无人出租车也开到了加拿大多伦多做公开道路测试。
研究侧有两篇值得看:微软研究院等机构 10 月 14 日在《Nature》发表 2–6 周时间尺度的机器学习天气预报研究;北京大学与三星研究(北京)联合提出带「活时钟」的游戏 agent 评测 RealtimeBench 和离线教练框架 TORSI,慢模型离线复盘两轮,把快模型的平均成绩从 13.51 提到 24.19。此外,前 OpenAI 可解释性研究者 Nick Cammarata 的长文称 Qwen3 32B 约九成神经元只承担单一功能;Epoch AI 测出开源权重模型的网络安全能力落后闭源前沿约 6–7 个月。
今日概览
公司与安全动态
#1DeepSeek V4.1 Flash 更新到 1017:全端切换,价格不变
#2花旗、美国银行禁止第三方 AI agent 登录客户账户、操作转账
#3OpenCode 披露安全事件:Console 里保存的第三方 API 密钥可能已暴露
#4Ray-Ban Meta 眼镜被曝未唤醒也保存录音转录,Meta 称 bug 已修复
#5Meta 商业账号条款 10 月 30 日生效:开通商业工具即授权抓取网站公开内容
#6Anthropic 在 IMF 论坛披露:Claude 参与下一代模型训练比例年底预计 80–90%
#7Anthropic 向美国国会推介自拟的前沿 AI 监管草案
#8纽约市主计长公开致信,要求推迟 Anthropic 的 IPO
#9Mistral CEO:一年内把算力扩到 6 倍,欧洲必须自建前沿模型
#10Replit 默认模型换成 OpenAI,Claude 保留为可选项
用户与产品
#11OpenCode 免费提供 GLM 5.3 Flash
#12Gemini 4 Argon 进入 AI Studio Build 与 Playground:Pro、Ultra 可用,免费档不含
#13Waymo 无人出租车开进加拿大多伦多
#14Perplexity 开源 agent 沙箱 SPACE
#15JetBrains 开源编程模型 Mellum 2.1:12B MoE,真实环境强化学习后训练
#16Perplexity 开源两款决策模型 Decider v1.2 与 Flash v1.2
#17Liquid AI 发布 d1-ultra,登顶决策模型榜
#18OpenMOSS 开源文生图模型 MOSS-Image
#19Elorian 发布视觉思考模型 Glimpse:推理中途可以回看画面
#20The Information:智能领先带来的开发者流量红利明显退潮
#21OpenRouter:开源权重模型上周处理了平台 72% 的 token
技术与研究
#22微软研究院等在《Nature》发表 2–6 周天气预报研究
#23北大与三星:游戏 agent 评测加「活时钟」,慢模型教练让快模型提分
#24Cammarata 可解释性长文:约九成 Qwen3 32B 神经元是单一功能
#25Epoch AI 两项评测:开源网络安全能力落后约 6–7 个月,模型打《杀戮尖塔》最低难度胜率超九成
 公司与安全动态
#1DeepSeek V4.1 Flash 更新到 1017:全端切换,价格不变
DeepSeek 10 月 17 日在官方更新日志宣布,V4.1 Flash 升级到 DeepSeek-V4.1-Flash-1017,官方网页端和 App 同步换上新模型,API 调用方式与价格都保持不变,继续用 deepseek-flash 访问最新版本。权重同日在 Hugging Face 开源:总参数约 7630 亿,上下文窗口 1M token,许可证为 MIT。
官方给出的基准对比里,提升最明显的是几个 agent 与编程项:Terminal-Bench 4.0 从 31.2 升到 42.3(用 Claude Code 框架测试),DeepSWE v1.1 从 74.2 升到 77.0(Mini-SWE-V2 框架),ProgramBench 从 20.3 升到 29.1,NL2Repo-Bench 从 65.4 升到 68.2,Automation-Bench v1.0.6 从 54.8 升到 60.5,Agents' Last Exam 从 31.8 升到 35.4;HLE(不含工具)为 42.6,其中纯文本子集 44.0。官方同时表示,新模型在提升性能的同时缩短了任务运行时间与输出长度,用户能以更低成本、更快速度完成任务,在多个 harness 下达到新的性能-费用帕累托最优。DeepSeek 还提到这次通过基于自反馈的强化学习训练,增强了在游戏开发、3D 建模等场景从零构建完整项目的能力。
对国内用户最实用的两句在最后。第一,这次更新专门针对 DeepSeek Harness、腾讯 CodeBuddy、WorkBuddy 等平台框架做了优化,官方建议把 DeepSeek Harness 升级到 0.2.1-rc.1 或更新版本。第二,WorkBuddy 国际版已更新到这版 DeepSeek 模型,并免费开放到 10 月 31 日。另外,昨天上线的 DeepSeek 搜索接口目前对 Harness、Claude Code、Codex 里触发的搜索调用尚未计费,11 月 1 日起按每千次成功请求 5 元收费。
来源:DeepSeek API 文档 · 更新日志 · 10月17日原文:https://api-docs.deepseek.com/updates
来源:Hugging Face · deepseek-ai · 10月17日原文:https://huggingface.co/deepseek-ai/DeepSeek-V4.1-Flash-1017
来源:X/@WorkBuddy_AI · 10月17日原文:https://x.com/WorkBuddy_AI/status/2111404103402430558
#2花旗、美国银行禁止第三方 AI agent 登录客户账户、操作转账
据《金融时报》报道(经 X 平台转述),花旗集团已禁止第三方 AI agent 登录其数字银行平台上的客户账户或操作资金转账,美国银行也采取了类似限制,与摩根大通此前的收紧政策一致。所谓第三方 AI agent 登录银行账户,指的是用户授权 AI 助手直接进入网银代办查询、转账一类业务——现在这条路在几家美资大行被堵上了。
报道同时引述了银行侧的两层担忧。摩根大通 CEO 杰米·戴蒙警告,如果放任不管,银行体系内可能出现数以千计的「流氓 agent」。更深一层是存款流失:agent 可以在几分钟内比较支票账户约 0.1% 的利率与金融科技平台 3.3%–5% 的收益率,替用户把资金搬到别处,规模化的比价套利可能触发大规模资金迁移。
来源:X/@rohanpaul_ai 转述《金融时报》报道 · 10月16日原文:https://x.com/rohanpaul_ai/status/2111145441421312174
#3OpenCode 披露安全事件:Console 里保存的第三方 API 密钥可能已暴露
编程工具 OpenCode 10 月 17 日披露一起安全事件。公司在发给受影响用户的通知邮件中称,一个正在停用的旧系统遭到未经授权的访问,用户存在 OpenCode Console 里的 OpenAI、Anthropic、Google 等第三方提供商的 API 密钥可能已暴露。OpenCode 把事件描述为一次大规模蒸馏攻击,影响约 1.4% 的 Console 用户,均为关联了外部提供商的账户;受影响者已全部收到邮件,未收到邮件的用户未受影响。
OpenCode 要求受影响用户撤销并更换密钥、检查近期用量是否异常,称事件仍在处理中,正与 Anthropic、OpenAI、Google 合作补救。Anthropic 工作人员随后表示,已撤销其认为受影响的 Claude API 密钥,并建议曾在 OpenCode 中保存密钥的用户创建新密钥。
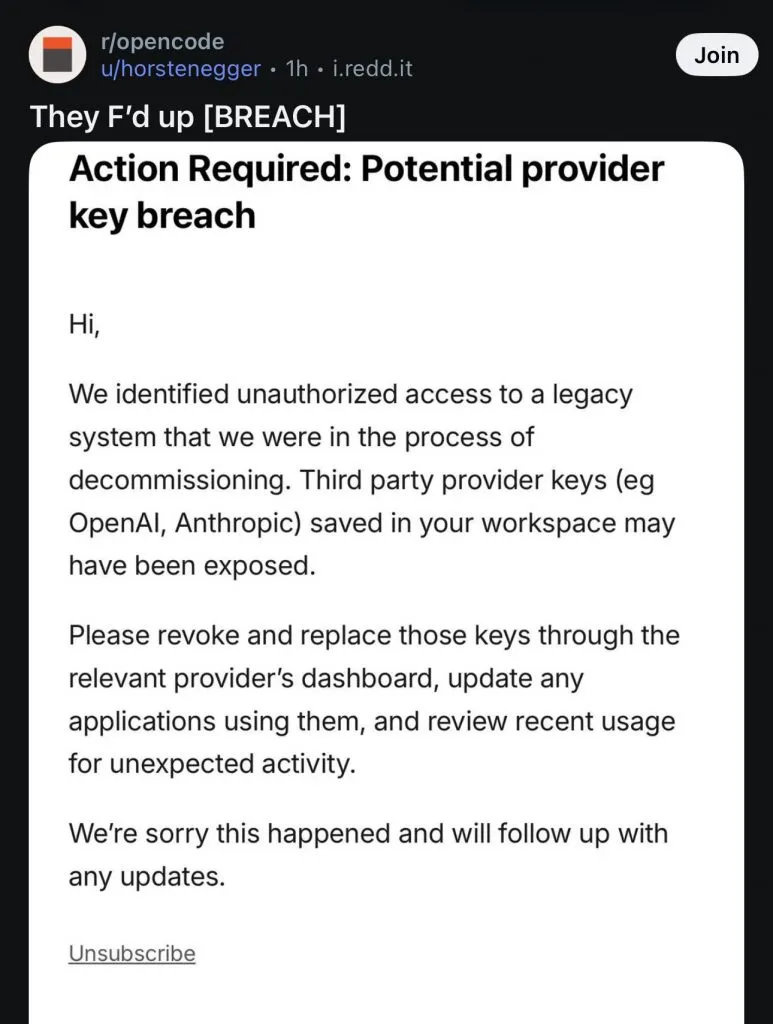
社区转发的 OpenCode 通知邮件截图:旧系统遭未授权访问,第三方密钥可能泄露(图:OfficeChai 报道配图)
来源:X/@opencode · 10月17日原文:https://x.com/opencode/status/2111519637049319818
来源:OfficeChai · 10月17日原文:https://officechai.com/ai/opencode-discloses-security-breach-says-attackers-may-have-accessed-users-openai-anthropic-and-google-api-keys/
来源:X/@lydiahallie · 10月17日原文:https://x.com/lydiahallie/status/2111563956666110287
#4Ray-Ban Meta 眼镜被曝未唤醒也保存录音转录,Meta 称 bug 已修复
据 Ars Technica 10 月 16 日报道,多名 Ray-Ban Meta 智能眼镜用户在 Reddit 反映,设备在用户没有说出「Hey, Meta」唤醒词、且「Respond without Hey Meta」设置为关闭的情况下,依然在 Meta AI 应用中保存了对话音频与文字转录。受影响的包括一位用户名下的三副眼镜。
Meta 表示该问题属于 bug 且已被修复,但没有披露触发条件。这类可穿戴设备的隐私边界问题此前就存在,这次的特殊之处在于:即使按官方设置关掉了免唤醒响应,录音仍然落了地。
来源:Ars Technica · 10月16日原文:https://arstechnica.com/gadgets/2026/10/ray-ban-meta-smart-glasses-found-recording-audio-without-wearers-consent
#5Meta 商业账号条款 10 月 30 日生效:开通商业工具即授权抓取网站公开内容
据 Gizmodo 报道(极客公园转引),Meta 更新了 Meta Business Suite 的商业账号服务条款,新规 10 月 30 日生效:企业开通 Facebook、Instagram 商业账号,就自动授予 Meta 抓取自家网站公开内容的权利,没有独立的关闭退出通道;即便企业网站用 robots.txt 屏蔽爬虫,也无法阻止这次基于商业账号协议授权的内容采集。此前 Meta 若要使用出版商、企业网页素材训练 AI,需要单独签署版权授权协议。
Meta 的解释是抓取网页内容旨在提升 Meta AI 的回答准确度,企业既然使用平台商业服务就应开放网页内容使用权;出版商与中小企业行业协会则批评新规等于逼企业在「放弃商业营销工具」和「交出网站内容」之间二选一。另据 TechCrunch 10 月 17日报道,Meta 还从服务条款中删除了此前引发外界担忧其扩大网页抓取与用于 AI 训练的部分措辞,发言人强调更新后的条款并不代表其抓取网络的方式发生变化。
来源:极客公园(转引 Gizmodo)· 10月18日原文:http://www.geekpark.net/news/372512
来源:TechCrunch · 10月17日原文:https://techcrunch.com/2026/10/17/meta-removes-language-that-raised-scraping-and-ai-training-concerns
#6Anthropic 在 IMF 论坛披露:Claude 参与下一代模型训练比例年底预计 80–90%
Anthropic 政策与战略事务负责人迈克尔·塞利托(Michael Sellitto)10 月 16 日在 IMF「人工智能与升级中的网络风险」论坛上,首次披露了 Claude 在公司内部工作中的参与度。他给出的数字是:在公司下一代前沿模型的训练中,Claude 的参与比例年初为 0%,4 月升到 3%,8 月达到 26%,预计 2027 年将升至 80%–90%。内部代码侧的跃迁更早完成:Anthropic 内部代码由 Claude 编写的比例从去年年初接近 0%,到去年年末升到 80%–90%,塞利托把关键转折点归于去年 8 月发布的模型首次被工程师评价为「达到我的水平」。这组数字与昨天我们写过的「Claude 编写 Claude Code 约 90% 的代码」互相印证,但训练侧的参与比例是第一次对外量化。
来源:X/@AndrewCurran_ 转述 Sellitto 发言 · 10月16日原文:https://x.com/AndrewCurran_/status/2111147698489643356
来源:X/@AISafetyMemes · 10月17日原文:https://x.com/AISafetyMemes/status/2111339118861107441
#7Anthropic 向美国国会推介自拟的前沿 AI 监管草案
据 POLITICO 10 月 16 日报道,Anthropic 正在向美国国会议员推介一份自拟的前沿 AI 安全与防务法案草案。草案设的叫停门槛相当高:政府只有在模型存在可预见且迫在眉睫、可能造成超过 10 亿美元损失或 50 人以上死伤的风险时,才能叫停其发布或使用,且风险须源于生物武器、模型逃逸或网络攻击;独立评估机构须在 72 小时内向美国商务部上报,必要时可通过法院裁决强制叫停。
Anthropic 发言人对 POLITICO 表示,草案内容与该公司 6 月以来一直向联邦和州立法者倡导的 Advanced AI Framework 一致。需要说明的是,这目前只是一份立法提案,尚未生效;但一家头部模型公司自己起草监管文本并向国会兜售,在 AI 行业属于罕见动作。
来源:POLITICO · 10月16日原文:https://politico.com/news/2026/10/16/anthropic-ai-safety-01124654
#8纽约市主计长公开致信,要求推迟 Anthropic 的 IPO
据 X 平台多位人士转述,纽约市主计长马克·莱文(Mark Levine)公开致信 Anthropic CEO 达里奥·阿莫迪,以招股书中的风险披露为由要求推迟这次 IPO。莱文的理由是:Anthropic 招股书 S-1 中的风险披露长达 80 页,几乎是业务描述部分的两倍,这种规模的前所未有风险不应被视作常规程序处理。这是大型 AI 企业的资本市场化进程中,第一次收到来自地方民选官员以安全风险为由的明确阻力;截至发稿,该消息主要经由社交平台转述,尚未见 Anthropic 回应。
来源:X/@AISafetyMemes · 10月17日原文:https://x.com/AISafetyMemes/status/2111264308739060163
来源:X/@AndrewCurran_ · 10月16日原文:https://x.com/AndrewCurran_/status/2111213177191166378
#9Mistral CEO:一年内把算力扩到 6 倍,欧洲必须自建前沿模型
Mistral AI 联合创始人兼 CEO 阿瑟·门施(Arthur Mensch)发文反对欧洲放弃前沿模型研发、只专注应用层。他的论点很直接:如果欧洲只做应用,将面临来自模型供应方的价格调整、用途限制甚至版本下架风险;拥有自己的前沿模型,才能决定自己的选择。他同时宣布 Mistral 计划在未来一年把算力扩大至现有规模的 6 倍,并继续筹资推进训练。
来源:X/@arthurmensch · 10月16日原文:https://x.com/arthurmensch/status/2110990492930314712
#10Replit 默认模型换成 OpenAI,Claude 保留为可选项
接昨天的消息:AI 编程平台 Replit 联合创始人兼 CEO 阿姆贾德·马萨德(Amjad Masad)向 TechCrunch 确认了更完整的安排——OpenAI 将取代 Anthropic 成为 Replit 的默认模型提供商,Claude 不再是默认选项,但仍保留供用户选用。马萨德给出的理由包括成本等多重因素。今年 8 月 Replit 曾宣布与 OpenAI 达成合作,当时并未披露与 Anthropic 关系已终止。平台上此前默认走 Claude 的用户,新会话将改由 OpenAI 模型承接;Claude 仍可在设置中手动选用。
来源:TechCrunch · 10月17日原文:https://techcrunch.com/2026/10/17/replit-is-no-longer-working-with-anthropic-ceo-says
 用户与产品
#11OpenCode 免费提供 GLM 5.3 Flash
开源编程 Agent OpenCode 10 月 16 日在官方 X 账号宣布,智谱 GLM 5.3 Flash 模型即日起在 OpenCode 平台免费提供,用户无需额外付费即可调用。帖子在约 21 小时内获得 210 万次浏览。评论区有用户补充称,OpenCode 中 GLM-5.3 免费档提供约 20 万 token 的上下文窗口——这一点来自社区转述,官方帖文未写明。需要对照的是上面 #3 的安全事件:免费模型照常提供,但曾在 Console 里保存 API 密钥的用户应先按官方指引换钥。
来源:X/@opencode · 10月16日原文:https://x.com/opencode/status/2110986357539754114
#12Gemini 4 Argon 进入 AI Studio Build 与 Playground:Pro、Ultra 可用,免费档不含
Google AI Studio 官方账号宣布,Gemini 4 Argon 向 Google AI Pro 订阅者开放,可在 AI Studio 的 Build 与 Playground 模块中调用;官方文档显示 Pro 与 Ultra 方案均可访问,免费方案不包含使用权限。另外,AI Studio 的 Build 工具近期新增了 Pan 与 Max 两种运行模式:Max 模式延长模型工作时间以追求更高质量输出,Plan 模式在执行改动前先生成执行计划(据测试者发布的界面截图,运行的是 Gemini 4 Argon Max)。加上此前进入 Antigravity、面向正价 Pro 用户提供独立周额度,Argon 这一周在开发者侧的铺开速度不算慢。
来源:X/@GoogleAIStudio · 10月16日原文:https://x.com/GoogleAIStudio/status/2111240722426802258
来源:X/@testingcatalog · 10月16日原文:https://x.com/testingcatalog/status/2111130452111114618
#13Waymo 无人出租车开进加拿大多伦多
据 TechCrunch 10 月 16 日报道,Alphabet 旗下 Waymo 宣布把自动驾驶出租车业务扩展至加拿大,首站选在多伦多市内道路开展公开道路测试。这是 Waymo 首次进入加拿大市场,也让它成为少数在美国以外进行公开道路测试的 L4 级 robotaxi 运营商之一。目前是测试阶段,何时开放载客服务、按什么规模投放,报道没有给出时间表。
来源:TechCrunch · 10月16日原文:https://techcrunch.com/2026/10/16/waymos-robotaxis-are-headed-to-canada
#14Perplexity 开源 agent 沙箱 SPACE
Perplexity 以 Apache 2.0 许可开源了内部沙箱平台 SPACE,供开发者自部署 AI agent 的代码执行环境。SPACE 基于 Firecracker microVM 隔离运行代码,支持暂停、恢复与会话分支,并把网络访问与平台凭证移到沙箱外管理——agent 在沙箱里跑代码,凭证不落在沙箱内部。Perplexity 称 SPACE 已支撑其全部 Computer 会话,日均处理数百万次沙箱创建,在同等生产流量下创建速度是此前供应商方案的 3 至 5 倍。做 agent 基础设施的人可以直接拿去自部署。
来源:Perplexity Hub 博客 · 10月原文:https://perplexity.ai/hub/blog/open-sourcing-space
#15JetBrains 开源编程模型 Mellum 2.1:12B MoE,真实环境强化学习后训练
JetBrains 发布并开源编程模型 Mellum 2.1,沿用 12B 总参数、2.5B 激活参数的 MoE 架构,升级重点在后训练:引入大规模真实环境强化学习,覆盖数学、竞赛编程、工具调用与软件工程任务,模型可以探索代码库、编辑文件并自检改动。官方称在高负载下输出速度约为同档位 Qwen3.5-9B 的两倍,单请求借助 MTP(多 token 预测)提速约 1.6 倍;本地 PyCharm 测试场景速度超过 140 token/s。权重已按 Apache 2.0 在 Hugging Face 开源,GGUF 版本即将支持 llama.cpp、Ollama、LM Studio。定位很清楚:不是刷榜的旗舰,是给编程 agent 用的快模型。
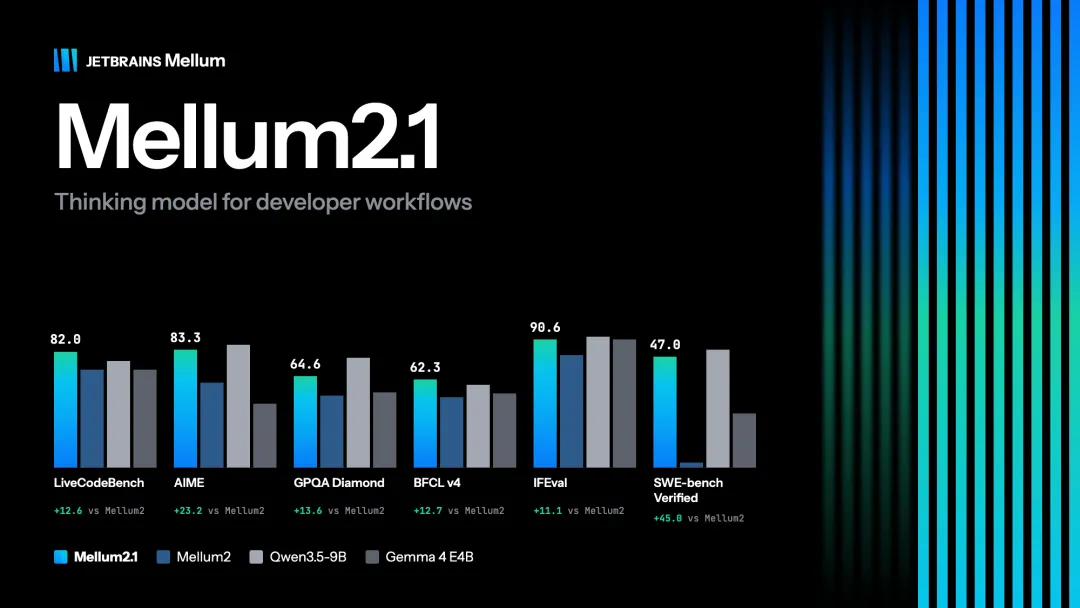
Mellum 2.1 官方成绩对比图,含 LiveCodeBench、SWE-bench 等分项(图:JetBrains 博客)
来源:JetBrains 博客 · 10月原文:https://blog.jetbrains.com/ai/2026/10/mellum2-1-gets-to-work-a-fast-open-model-for-coding-agents
#16Perplexity 开源两款决策模型 Decider v1.2 与 Flash v1.2
Perplexity 发布并开源新一代多模态决策模型 pplx-decider-v1.2(27B)与 pplx-decider-flash-v1.2(4B),权重已在 Hugging Face 开放。两款模型接受文本与图像输入,输出是非判断、选项选择或带概率的评分;官方称单次请求内所有问题一次性推理完成,推理速度最高提升至 5 倍。成绩方面,官方称 27B 版本在 Hugging Face Decision Index 暂列第二,4B Flash 版本为该尺寸档第一。API 定价分别 每百万输入 token 2 美分和 1 美分,输出免费,上下文 256K,已接入 OpenRouter 和 Vercel AI Gateway。决策类模型不生成长文本、只输出结构化判断,走的是「便宜、快、可核验」的路子。
来源:X/@perplexitydevs · 10月16日原文:https://x.com/perplexitydevs/status/2111166029539758120
来源:X/@OpenRouter · 10月16日原文:https://x.com/OpenRouter/status/2111200007437402243
#17Liquid AI 发布 d1-ultra,登顶决策模型榜
Liquid AI 发布多模态决策模型 d1-ultra,主打电路板缺陷核验、保险定损这类需要概率化判读的复杂场景。它在 Artificial Analysis 的 Decision Index v1.0 中以 65 分登顶,领先第二名 Jev 1.14 的 57 分至少 8 分。模型已在 Liquid API 和 Vercel AI Gateway 上线,每百万输入 token 0.042 美元,仅按输入计费,不生成文本 token。和 Perplexity 的 Decider 系列放在一天看,「只做决策、按输入计费」正在成为一类独立的产品形态。
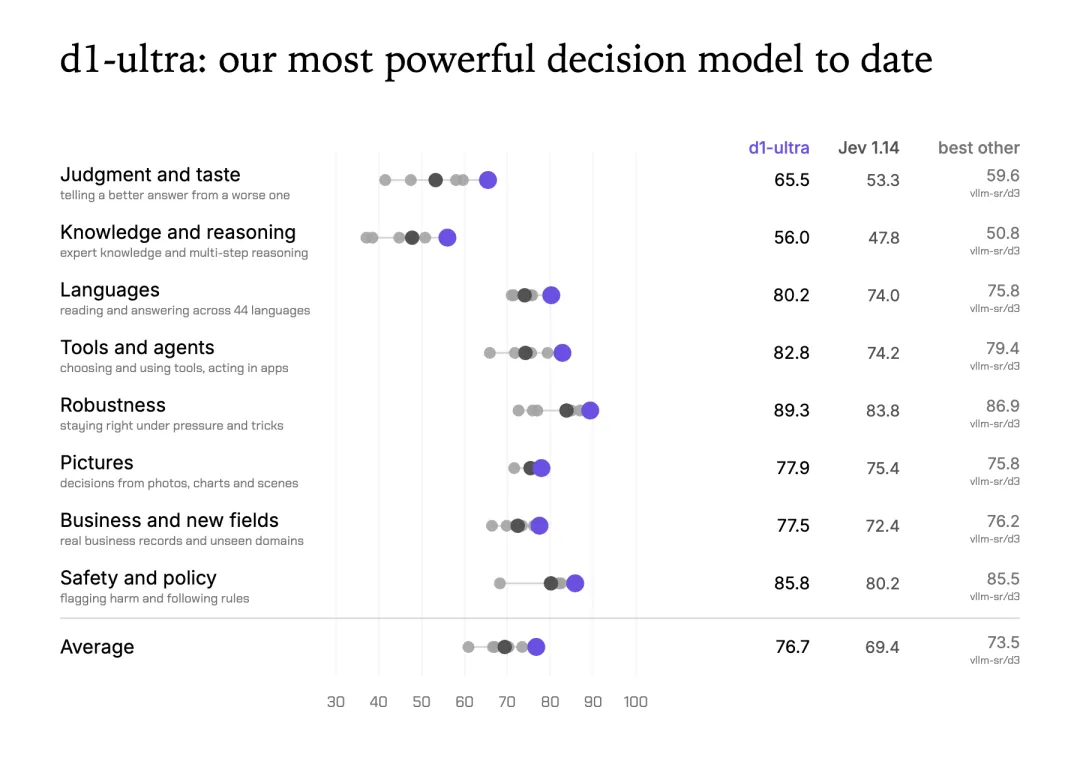
d1-ultra 官方能力对比图:八个维度与平均分均高于 Jev 1.14(图:Liquid AI 博客)
来源:Liquid AI 博客 · 10月原文:https://www.liquid.ai/blog/d1-ultra
#18OpenMOSS 开源文生图模型 MOSS-Image
OpenMOSS 发布文生图模型 MOSS-Image,同时放出 MOSS-Image-Base 与 MOSS-Image-SFT 两个版本,代码和权重全部公开。该系列采用 5B 参数主干,支持最长 4K token 提示词,可以通过 JSON 指定画面中文字与物体的位置,覆盖动漫与写实风格。权重以 Apache 2.0 许可托管在 Hugging Face 与 ModelScope。5B 的体量单卡就能跑,适合想本地部署文生图的用户。
来源:OpenMOSS 官网 · 10月原文:https://openmoss.ai/MOSS-Image
#19Elorian 发布视觉思考模型 Glimpse:推理中途可以回看画面
由参与过 Google Gemini 与 Apple MM-1 研究的人员创立的 AI 公司 Elorian 发布首个模型 Glimpse,主打「推理过程中回看画面」:模型可以在思考链中重新查看图像或视频、放大局部、对片段提高采样帧率、甚至运行代码检查画面,而不是只依赖一帧看下来的印象。该模型以研究预览形式通过 API 和聊天界面开放,定价输入每百万 token 0.60 美元、输出 3.00 美元。
厂商自评的成绩里,Glimpse 在科学图表推理 CharXiv-R、开放词汇计数 FSC-147、短视频描述 UGC-VideoCap、操作事件理解 WGO Bench 四项评测上超过 GPT-6 Astra,具身空间推理 ERQA 上与之持平。也要看到另一面:在 Elorian 与 Scale AI 联合构建的视觉基准 Humanity's Sixth Sense 上,Glimpse 取得 46.4%,低于 GPT-6 Astra 的 53.6%,与人类 93.1% 的水平差距仍大。Google 前员工 Jeff Dean 也在 X 上转发了这条发布。
来源:Elorian 博客 · 10月原文:https://elorian.ai/blog/introducing-glimpse
来源:X/@testingcatalog · 10月16日原文:https://x.com/testingcatalog/status/2111174693222855041
来源:TechCrunch · 10月16日原文:https://techcrunch.com/2026/10/16/elorians-first-ai-model-wants-to-reason-with-images-not-just-about-them
#20The Information:智能领先带来的开发者流量红利明显退潮
The Information 10 月 16 日的报道点出头部 AI 实验室的一个新处境:模型能力持续提升,却换不来等比例的使用量增长。其获得的数据显示,10 分的智能领先优势目前只能带来约 20% 的开发者流量增量,而 2025 年末这个数字还接近 69%。换句话说,模型之间拉开能力差距,对把开发者吸引过来的边际效果在快速衰减,生态、定价、企业渠道这些非能力因素的权重在上升。
来源:X/@theinformation · 10月16日原文:https://x.com/theinformation/status/2111125130428481571
#21OpenRouter:开源权重模型上周处理了平台 72% 的 token
模型聚合路由平台 OpenRouter 公布的最新一周数据显示,开源权重模型处理了平台上 72% 的 token,远高于闭源模型在调用量上的占比。不过 OpenRouter 同时指出,平台多数客户的支出仍流向闭源权重模型,呈现「调用量开源占优、营收闭源主导」的格局。和上一条 The Information 的数据放在一起看:开发者在用什么、为什么付钱,已经是两套逻辑。
来源:X/@OpenRouter · 10月16日原文:https://x.com/OpenRouter/status/2111161582860267971
 技术与研究
#22微软研究院等在《Nature》发表 2–6 周天气预报研究
微软 CEO 萨提亚·纳德拉 10 月 16 日宣布,公司一项机器学习天气预报研究发表于《Nature》。论文题为《Advancing subseasonal forecasting with machine learning》,10 月 14 日以开放获取形式发表。作者团队横跨多家机构:第一作者 Hannah Guan 来自微软研究院(哈佛学院合署),共同第一作者 Soukayna Mouatadid 来自多伦多大学,资深作者 Lester Mackey 来自微软研究院;合作者还包括 MIT、欧洲中期天气预报中心(ECMWF)、微软 Redmond 团队、巴西纯数学与应用数学研究所(IMPA)等。
论文针对的是 2–6 周这一传统上最难的次季节时间尺度,摘要称其提出的概率偏差校正(probabilistic bias correction)框架能校正该时段的预报误差、提升预报技巧,在极端天气预测上显示出应用前景。纳德拉强调的更广启示,是给模型配上智能验证系统,用于识别系统性偏差、做因果推理并持续校准预测。需要说明的是,以上结论范围来自论文摘要与官方公告,更细的分项指标要看论文正文。
来源:Nature · 10月14日发表原文:https://www.nature.com/articles/s41586-026-11126-x
来源:X/@satyanadella · 10月16日原文:https://x.com/satyanadella/status/2111204941801128366
#23北大与三星:游戏 agent 评测加「活时钟」,慢模型教练让快模型提分
北京大学的 Ningxin Pan、Hanyu Li、Wentao Zhang 与三星研究(北京)的 Yeqing Shen、Ning Ding、Yehui Tang 等在 arXiv 提出 RealtimeBench 与离线教练框架 TORSI(论文 10 月 14 日提交 v1,预印本)。RealtimeBench 有 180 个任务、覆盖六类游戏,关键区别是推理期间游戏照常运行——现实中世界不会停下来等模型思考。配对评测显示:把游戏暂停时,慢推理的 GPT-6.1-sol 胜过更快的 Jev;世界继续运行时则反过来,前者反而落后。
TORSI 的思路是「双时间尺度」:让慢而强的教师模型在两轮尝试之间在暂停环境里研究失败、验证修正,再写出可复用的指令交给快的学生模型;学生在游玩中不再调用教师,由验证分数决定哪些更新被采纳。结果是两轮之后 Jev 的平均测试分从 13.51 升到 24.19(0–100 进度分),六类游戏全部提升;这些指令不调参也能改善另外三个模型的平均分。局限论文自己也写了:结论基于所选游戏与模型组合,跨域推广还有待检验。
来源:arXiv · Ningxin Pan, Hanyu Li, Yeqing Shen, Ning Ding, Yehui Tang, Wentao Zhang · 预印本,10月14日提交原文:https://arxiv.org/abs/2610.20665
#24Cammarata 可解释性长文:约九成 Qwen3 32B 神经元是单一功能
可解释性研究者 Nick Cammarata(曾任职 OpenAI)发表长文及配套交互式可视化,提出神经网络内部表征比「叠加假设」所暗示的更易读。他的核心估计是:约 90% 的 Qwen3 32B 神经元承担单一主要功能;研究覆盖 Qwen3 32B、Qwen3.6-35B-A3B、Kimi K3 以及卷积视觉模型,并认为随模型规模增大,特征分化会更清晰。若这一判断成立,直接研究神经元就能理解模型,而不必先训练稀疏自编码器一类「解码器」。他回顾在 OpenAI 早期只能解读约 2% 的神经元,如今借助现代 agent 工具与更细致的观察得到上述结论,称之为可解释性领域的「苦涩教训」——原先许多被判为「纠缠」的案例实为误读。
OpenAI CEO 萨姆·奥尔特曼转发了这篇长文。需要说明的是,这是个人研究长文而非同行评议论文;Cammarata 后来又发帖补充了引用与合作者致谢(包括 Curt Tigges)。论文式验证还要等社区跟进。
来源:X/@sama 转发 · 10月16日原文:https://x.com/sama/status/2111130577789493706
来源:Reddit r/LocalLLaMA · 10月16日原文:https://www.reddit.com/r/LocalLLaMA/comments/1x7nenr/understanding_how_neural_networks_learn_with
#25Epoch AI 两项评测:开源网络安全能力落后约 6–7 个月,模型打《杀戮尖塔》最低难度胜率超九成
评测机构 Epoch AI 连发两项结果。在网络安全基准 Cyber ECI 上,开源权重模型与闭源前沿模型的能力差距约为 6 至 7 个月:Zai 公司的 GLM-5.3 以 160 分成为当前最高分的开源权重模型,超过了 OpenAI 今年 3 月发布的 GPT-5.4。
另一项是游戏基准 SpireClimb:Epoch 为《杀戮尖塔》及其续作录制了超过一千局模型对局,并将在未来数周把回放视频连同模型思考过程的字幕上传到 YouTube。他们的说法是:六个月前前沿模型还难以通关,现在最低难度胜率超过 90%,最高难度也能达到约 20%。游戏 agent 这半年的进步速度,和上面北大、三星那篇论文观察到的现象是同一方向。
来源:X/@EpochAIResearch · 10月16日原文:https://x.com/EpochAIResearch/status/2111165029470949867
来源:X/@EpochAIResearch · 10月16日原文:https://x.com/EpochAIResearch/status/2111201511787344336
本文由AI辅助生成,可能存在幻觉