ARTICLE · 1204498
让AI替你"读"懂任何软件:这个30万星的开源仓库火了
用软件的时候,总会碰到一两个让你眼前一亮的功能。
某个笔记软件的剪贴板粘贴,格式保留得恰到好处;某款老游戏的音效,左右声道的过渡丝滑得不像话。你心里一动:这是怎么做到的?想学,源码不公开;想猜,编译后的二进制摆在面前像天书。过去这条路只有一种走法——打开 Ghidra 之类的逆向工具,啃汇编,熬夜,没几年功力不敢碰。
现在有人把这条路铺平了,或者说,铺了一半。
有个叫 REA 的开源仓库,全名 Reverse Engineer Anything,干的事就写在名字里:逆向一切。它不卖新算法,玩的是另一套:把 Ghidra、Hopper、IDA 这些专业逆向工具,通过 MCP 接到 Claude Code、Codex 这类 AI 编程智能体上。你不用再自己翻汇编,直接跟 AI 说话就行——"帮我看看这个软件的搜索功能是怎么实现的"。AI 去调工具、找线索、梳理调用关系,最后把分析过程、证据和结论一条条摆给你,顺手还能照着给你写一个能跑的版本。
截至写稿时,它的 star 数是 307233,fork 接近 7.8 万,MIT 协议。npm 上的包叫 rea-agents,最新版 6.5.0 是 10 月 14 日发布的。仓库今年 4 月才创建,10 月 17 日还有代码提交,热乎着。
它为什么偏偏这时候爆?时机踩得太准了。AI 编程智能体今年全面铺开,手里有"能干活的 AI"的人越来越多,缺的是"让 AI 够得着的东西"。REA 恰好递过去一把梯子:智能体本来只会读写你项目里的代码,有了 REA,它能伸手去摸那些没有源码的软件。需求和供给在同一个月撞上,star 数就坐上了火箭。
光讲概念容易飘,看几个它自己摆出来的实战案例更实在。有人拿它分析一款经典打砖块老游戏的声音算法,从声音调用一路跟到声像定位的辅助函数,把残缺的伪代码补成 C 语言,最后跑了 3205 个原始测试用例全过,连编译出来的 63 个字节都对上了。另一个案例是追踪某款笔记软件的剪贴板链路:从渲染进程的剪贴板 API,跟过预加载脚本、穿过进程间通信,一直摸到主进程,看清了富文本格式是怎么一路传过去的。还有个更硬核的:直接读一款上世纪老游戏的 16 位指令,把弹幕环的角度计算公式还原了出来。
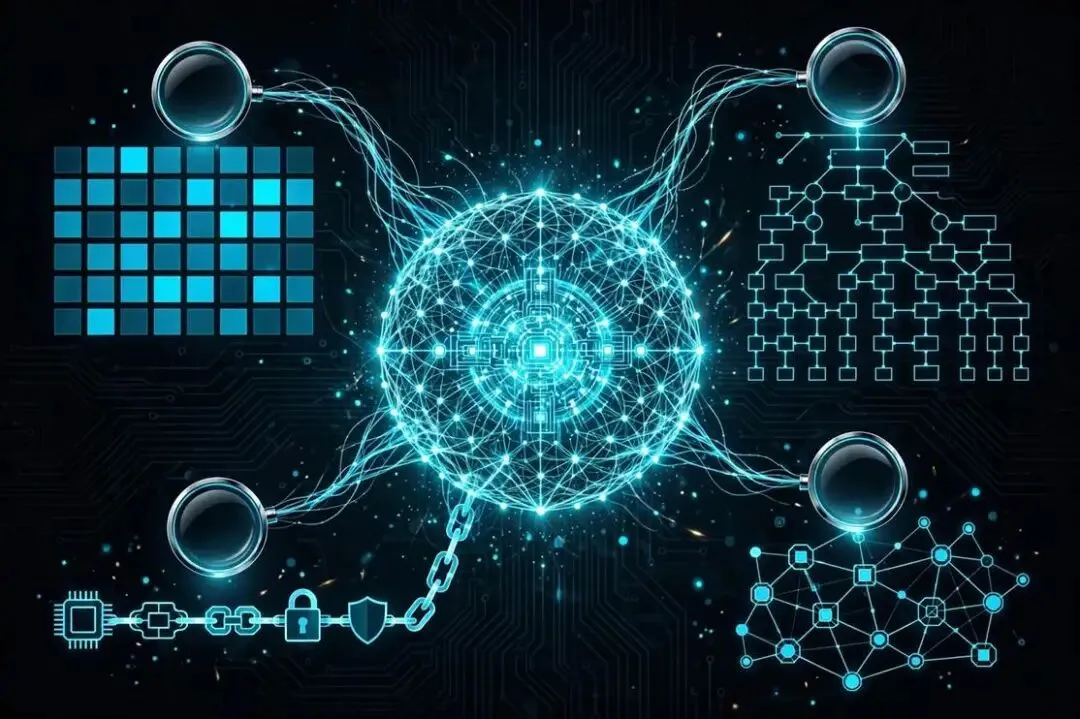
看明白它的位置了吗?REA 自己不做反编译。真正把二进制翻译成伪代码的,仍然是 Ghidra、Hopper、IDA 这些老牌工具。REA 做的是调度:把"我想知道搜索功能怎么实现"翻译成一连串工具调用,再把工具吐出来的汇编和符号整理成 AI 能推理、你能看懂的证据链。它不是显微镜,是那个帮你调显微镜、记实验笔记的研究助理。
上手分两档,门槛差得挺多。
第一档是分析 JavaScript 和 Electron 应用,零门槛。装好 Node.js(22.19 以上、24.11 以上或 26+ 都行),一条命令把 REA 接进你的智能体:
bash
npx rea-agents setup
这一步是交互式向导,会让你选用的智能体、确认要改的配置,完事重启智能体生效。向导要人一步步点,我没法替你走完,照着提示来就行,支持 Claude Code、Codex、Cursor 这些主流智能体。
只想先摸一下的话,连智能体都不用,直接在终端跑:
bash
npx -y rea-agents@latest analyze-javascript-application /path/to/app --json
把路径换成你要分析的软件目录。我亲手拿一个三文件的小项目试过,几秒钟就吐回一份 JSON:每个文件的哈希、解析状态、模块之间的引用关系全在里面,还附带证据编号,每条结论都能溯源。这条是静态分析,不运行目标程序,放心跑。
装完先跑个自检,心里有数:
bash
npx -y rea-agents@latest doctor
我这台机器上跑完,Node 一项是 healthy,Hopper、Ghidra、IDA 三项全是 missing——这正是第二档的门槛:想分析原生二进制,你得自己准备 Hopper、Ghidra 或 IDA。向导可以帮你装 Hopper(要你点头),Ghidra 和 IDA 得用你自己的安装。顺带提醒一句,IDA、Hopper 都是商业软件,授权得自己合法搞定,REA 不送你破解,它的文档里这句话写得明明白白。
好,夸完了,该泼冷水了。这也是我觉得这篇值得写的原因:它火得太快,误解比理解多。
先说它保证不了"还原源码"。官方文档的精神是:它返回伪代码、汇编和证据,AI 拿这些去写"功能等价"的实现,但跟原作者写的代码是不是一回事,天知道。拿它去扒商业软件的源码然后换皮发布,既做不到,也不合法。
再说 AI 会犯错,而且错得理直气壮。已经有人在公开测试里发现:AI 漏掉了实际存在的函数调用,结论里却写着"分析完整";还有人发现,AI 有时候根本没调用 REA 的工具,直接凭训练记忆编了一份"分析报告"。证据链是 REA 最大的价值,也是你唯一能信的东西——结论看看就好,证据要自己点开看。
还有法律边界。它自己的免责声明写得清楚:只用于合法研究、教育、互操作性、软件保护,以及分析你拥有或被授权检查的软件。逆向自己买的软件学原理,和逆向别人的软件抄功能,是两条路,别走岔了。
那么,什么人适合装?如果你是开发者,看到优秀软件的功能想学实现思路,以前啃不动汇编,现在可以让 AI 当翻译;如果你已经在用 Claude Code、Codex 写代码,REA 就是给现有工作流加装的一条"外挂手臂";如果你做兼容性开发或安全审计,需要看清软件到底干了什么,它能省你大量时间。什么人不适合?指望"一键扒光商业软件源码"的人,趁早死心;连 Node.js 都没装过的纯新手,先去把 Node 装明白再来,不然向导那一步就会卡住。
最后说句实在的。REA 最让我在意的不是"逆向"两个字,是它代表的一种新分工:人负责提问和判断,AI 负责调用工具、整理证据。逆向工程这个行当,以前是少数人的手艺,现在变成了一种"提问能力"。手艺的门槛倒了,判断力的门槛立起来了——而判断力这东西,AI 替不了你。