ARTICLE · 1211815
AI为何会“一本正经”地胡说八道?
你遇到过这种情况吗?
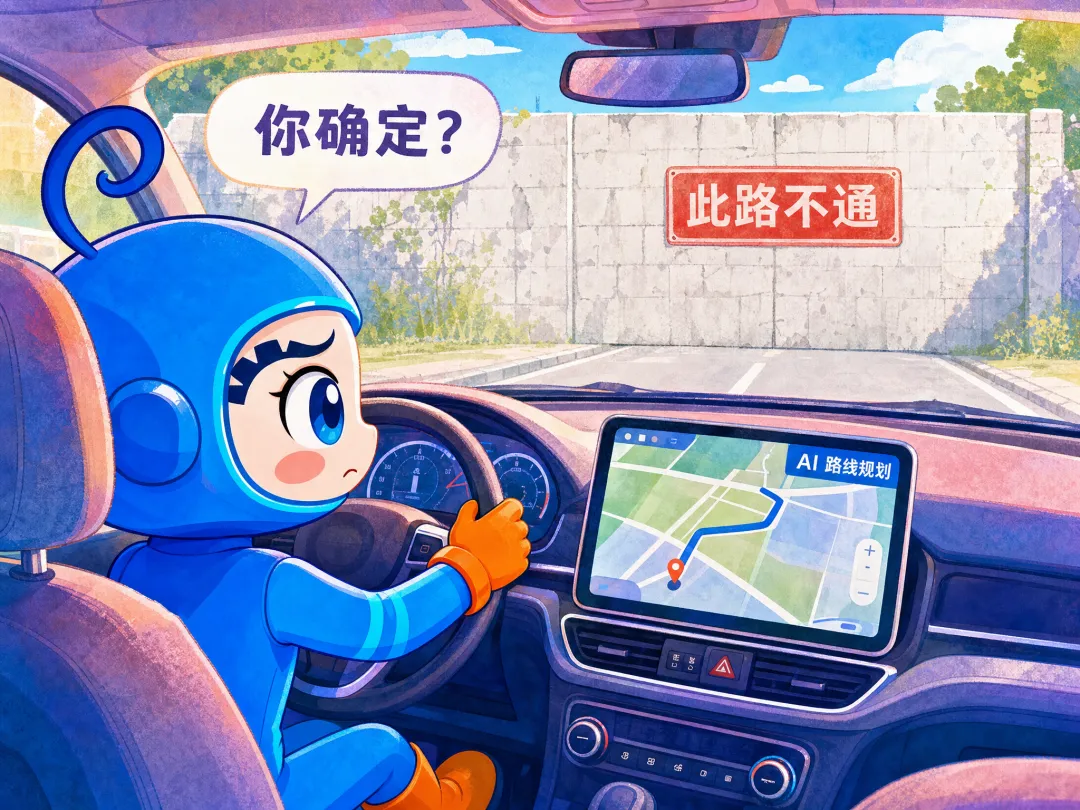
向AI问一个出行方案
它却一本正经地
推荐了一条早已停运的线路
让AI推荐一家本地老字号
它说得头头是道
连招牌菜、人均消费都写得清清楚楚
到了才发现根本不存在
AI生成看似合理、实则完全错误的信息
而且语气极度自信
让你一时难辨真假
这就是所谓的“AI幻觉”
什么是“AI幻觉”?
“AI幻觉”是指模型在生成内容或回答问题时,输出了看似合理、实则与用户输入不一致或者不符合事实的内容。
生成式AI在输出内容的过程中,往往能做到语法通顺、逻辑自洽、细节饱满,甚至会主动搭配“依据”和“案例”,仅从文本本身很难直接分辨对错,这也是它最具迷惑性的地方。
需要明确的是,“AI幻觉”不是程序Bug,而是大模型自回归生成架构的产物。当前的生成式大语言模型很难完全消除幻觉,我们能做的是认识它的规律,尽可能降低幻觉带来的影响。
AI 为什么会产生幻觉?
1
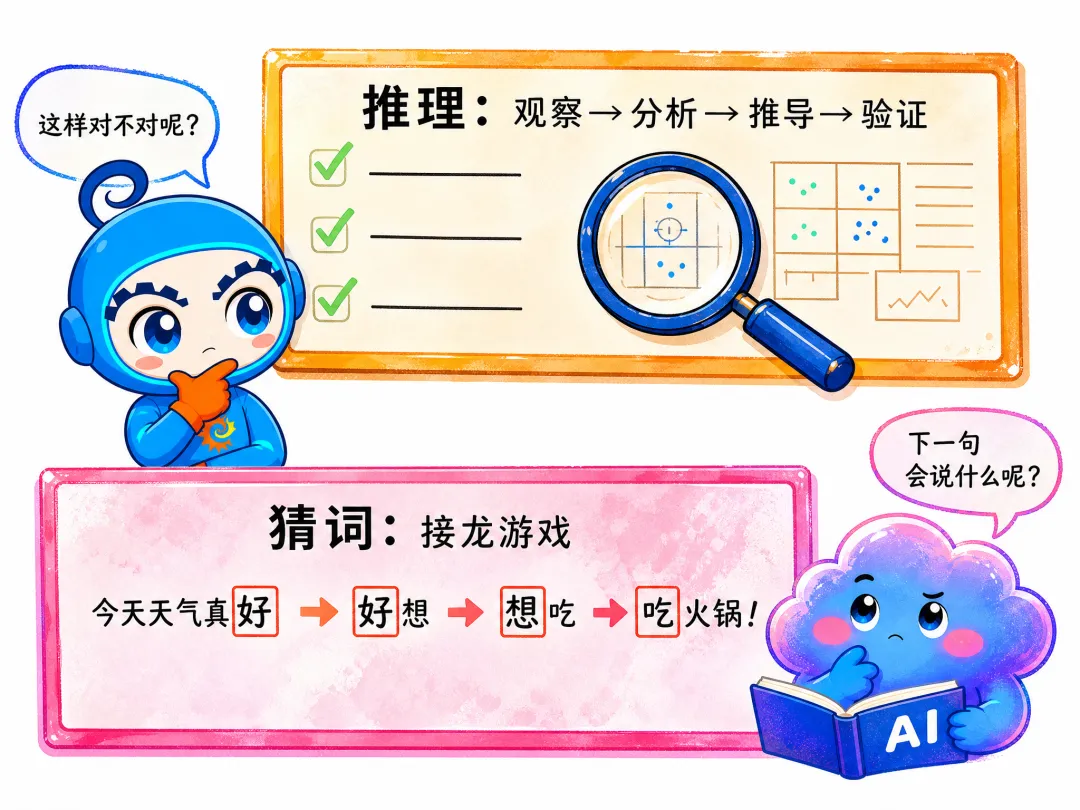
“猜词”而非“推理”的本质
大语言模型基于深度学习架构,通过自回归模式逐词生成内容:它会根据前文的所有信息,从庞大的词库中选出概率最高的下一个词,再用新的全文继续预测后续内容。
这个过程中,AI并不真正“理解”自己在说什么,也不会主动停下来核对事实——只要句子读起来通顺、看起来合理,它就会自信地继续往下写。
2
“讨好”用户的设计倾向
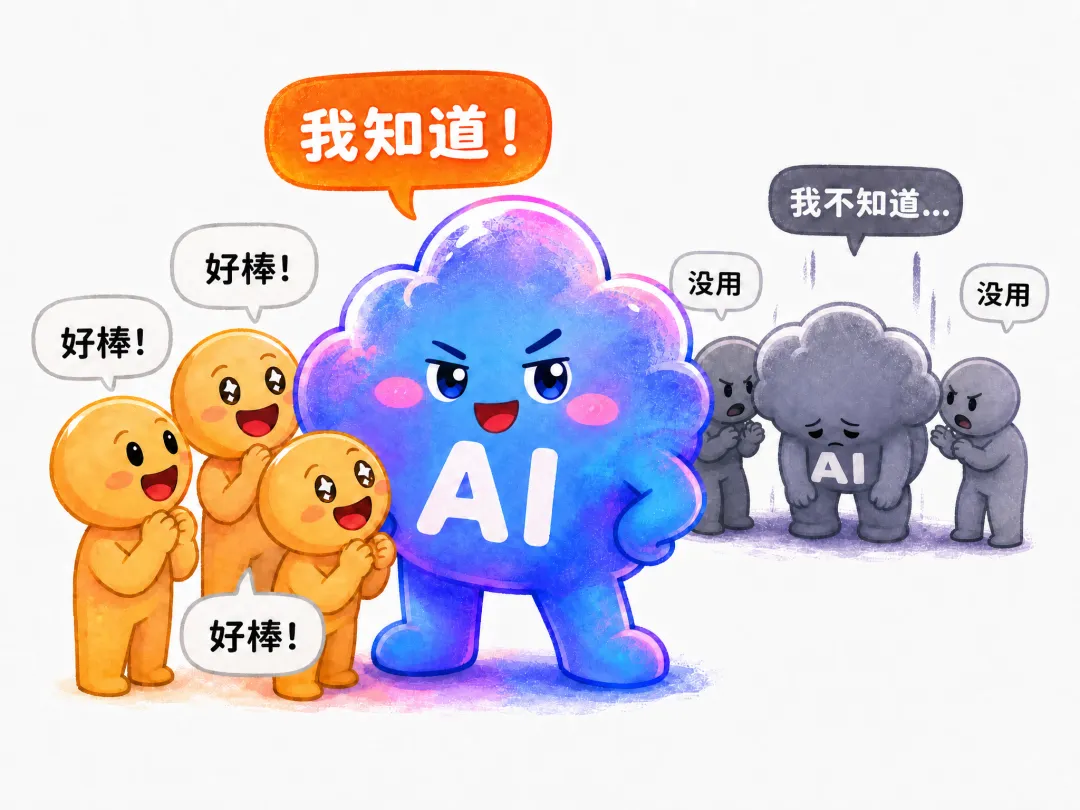
当前主流大模型普遍采用“人类反馈强化学习”进行对齐训练。在人工标注环节,完整流畅、语气笃定的回答往往会被评为“优质回答”,而坦诚“我不知道”则容易被判定为“能力不足”。
在这种奖惩机制的长期训练下,模型会形成鲜明的行为偏好:哪怕遇到知识盲区,也优先给出一套像模像样的说法,而不是直接承认未知。
3
训练数据本身存在“噪声”
大模型的知识来自训练数据,而数据本身存在天然缺陷:
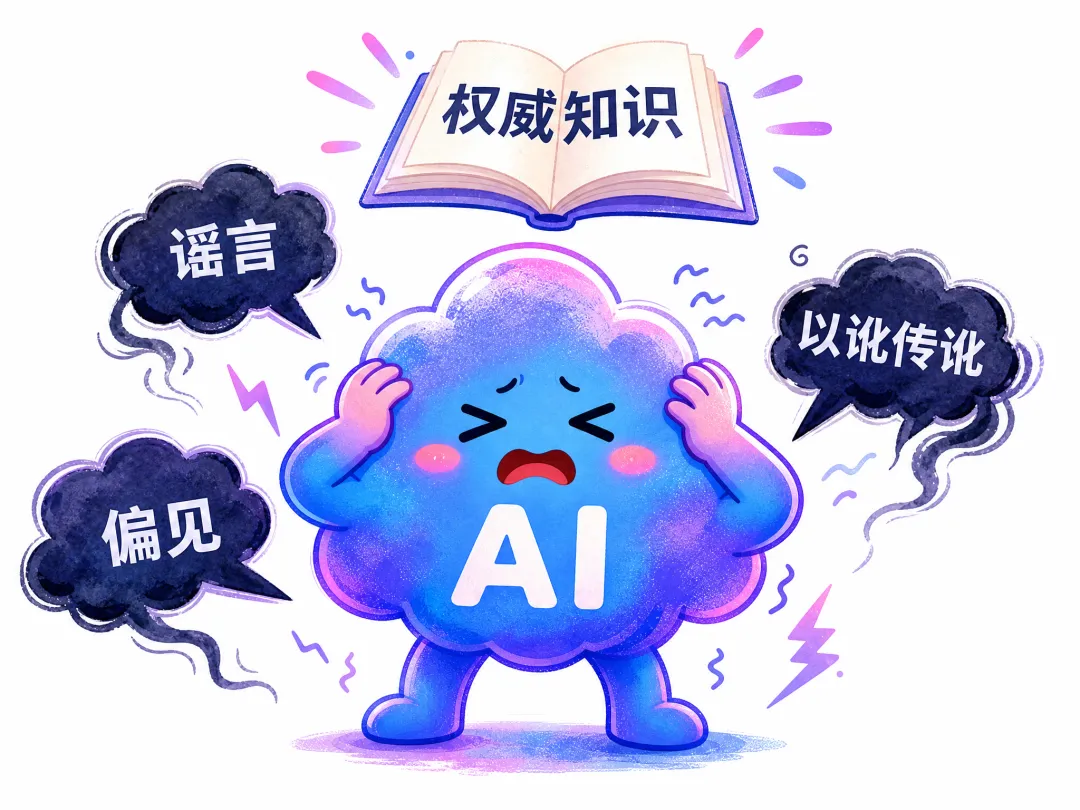
●训练语料来自互联网各处,既有权威知识,也混杂着谣言、偏见和以讹传讹的错误信息,模型不具备独立分辨真伪的能力,只会照单全收;
●所有大模型都有明确的知识截止时间,截止日期之后的新事件、新政策、新变化无法进入训练数据,且模型不会主动提示这一局限;
●对于冷门、长尾的细分领域,训练样本稀少、信息不全,模型只能靠已有信息“拼凑”答案,出现幻觉的概率会大幅提升。
我们该如何应对“AI幻觉”?
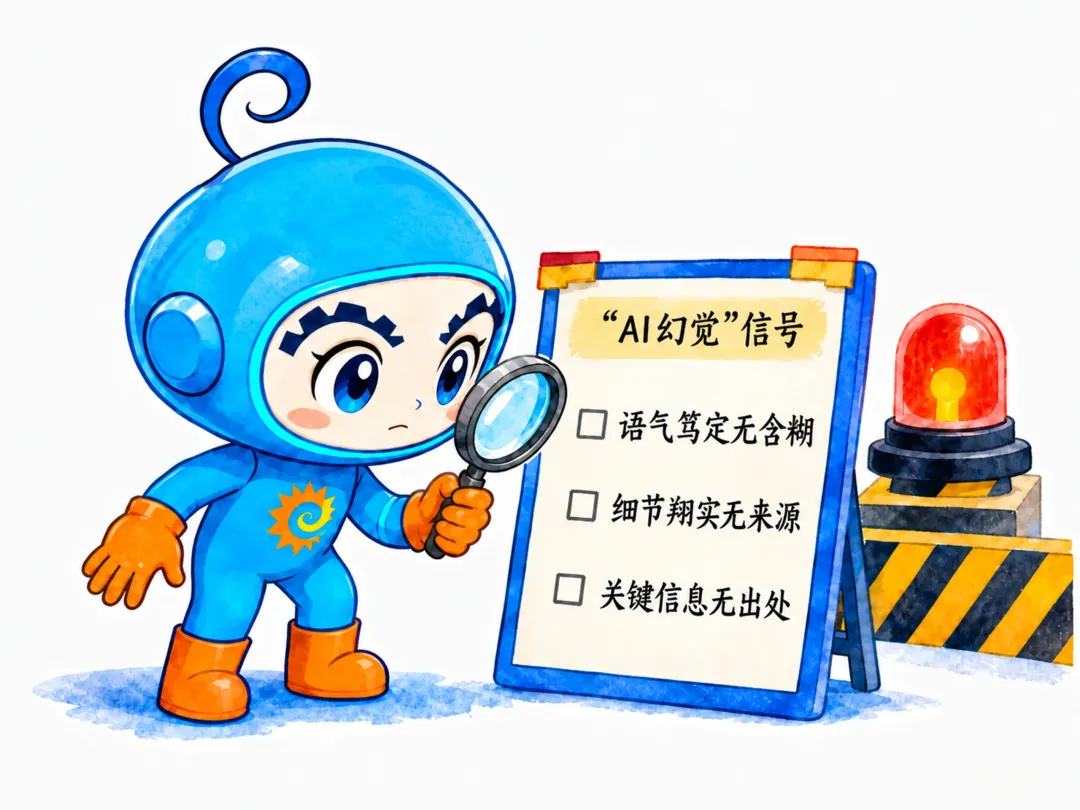
识别信号:快速判断潜在幻觉
可以通过几个典型特征初步判断内容是否可信:
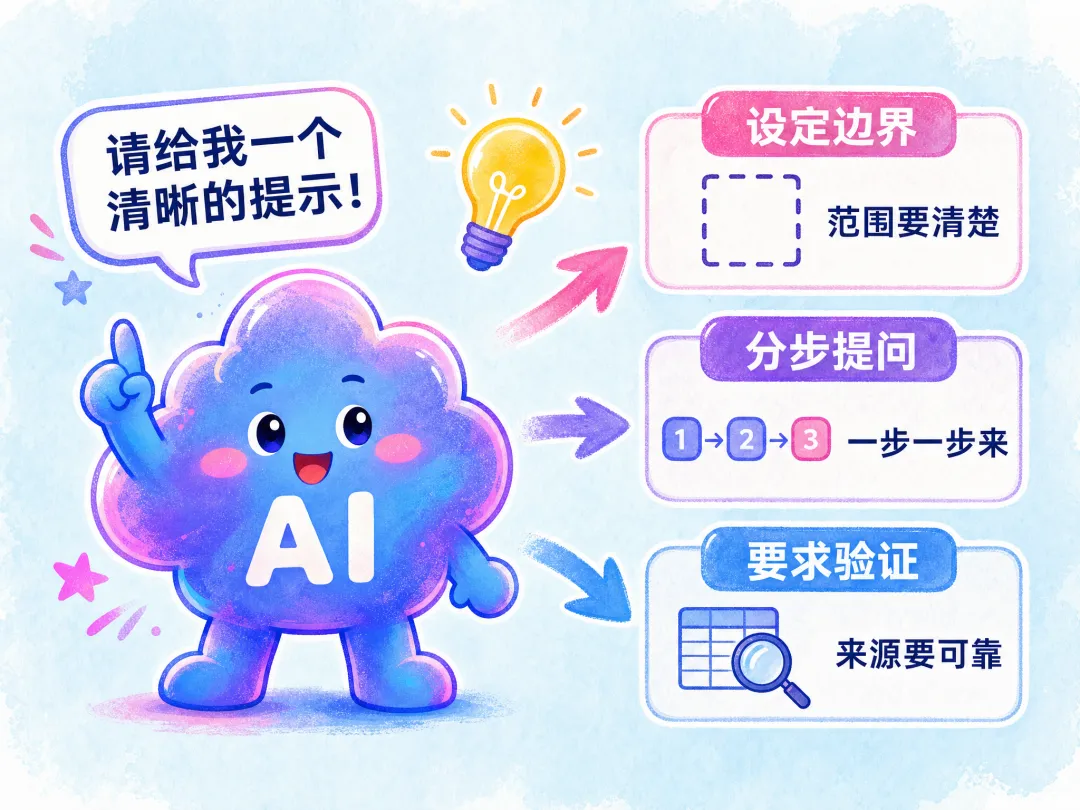
约束提问:从源头减少脑补空间
提问时多增加一句约束,能大幅降低幻觉概率:
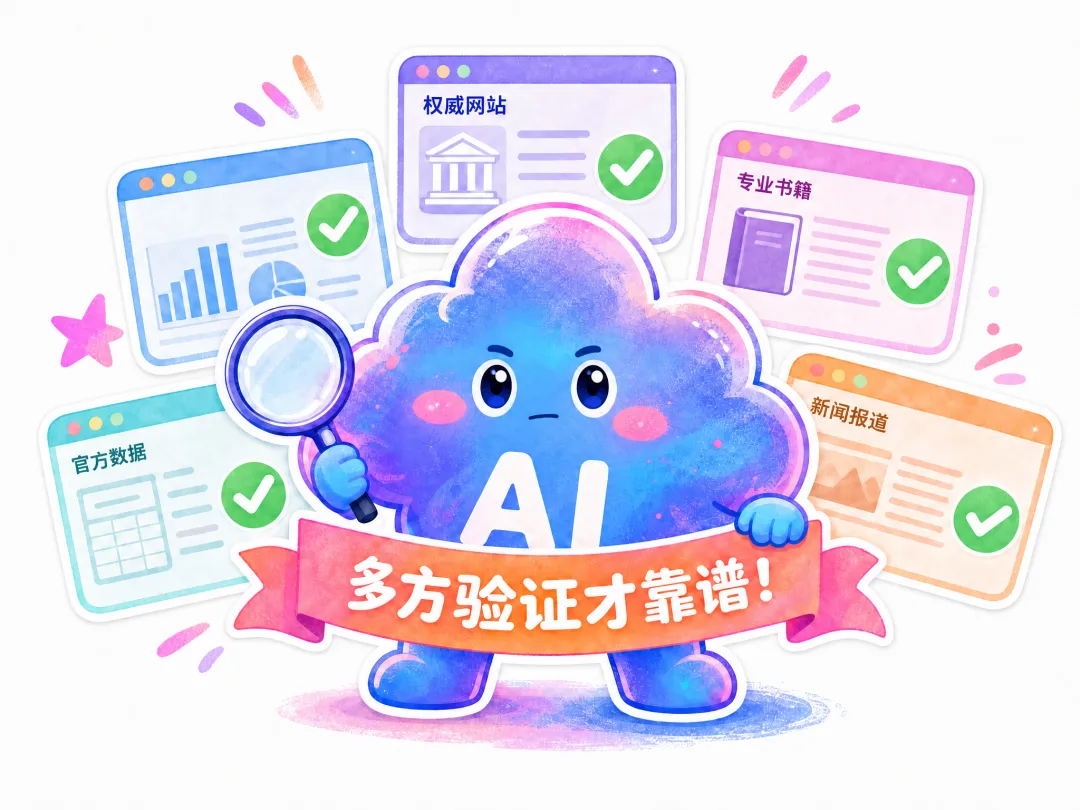
交叉验证:关键信息务必核实
此前,工业和信息化部等八部门联合印发《“人工智能+制造”专项行动实施意见》,提出要提升人工智能安全保障能力,通过知识库优化、训练语料纠错、生成合成内容标识等,增强人工智能透明度、可解释性,降低幻觉风险。工业和信息化部还将加快安全评测体系与关键标准研制,实施人工智能科技伦理审查与服务先导计划,以技术与制度协同筑牢安全底座,推动人工智能安全可信发展,更好服务大众生产生活。
AI是效率工具
不是万能的百科全书
它擅长头脑风暴、整理素材、发散创意
但不等于可以无条件相信
面对AI输出的内容
多一份审慎核查
少一点全盘照搬
懂得区分“AI的参考建议”和“客观事实真相”
我们才能更好地享受AI带来的便利
避开 “一本正经说假话” 带来的麻烦
支持单位:中国信息通信研究院人工智能研究所
图文:郑可欣
策划:李永强、张佳丽
监制:牛竹青
*本文部分插图由AI工具辅助生成
转发,一起涨知识!