ARTICLE · 1213206
OpenAI重磅研究刷屏:43%岗位边界已碎!未来最火的AI工作,人类连名字还没起
假如你现在坐进时光机,一键穿越回1976年。
走在纽约街头,有人拦住你问:“嘿,你在2026年是干什么工作的?”
你老老实实回答:“我的工作,是为托管在云端的视频流媒体移动应用,优化搜索引擎广告。”
对方大概率会觉得你疯了
在1976年,“云”只是天上飘的白色水汽;“应用(App)”这个词还没被智能手机发明出来;商业互联网和搜索引擎根本不存在为了解释清楚你这一个岗位名称,你必须先给对方科普整整四代当时连影儿都没有的未来科技。
而在同一年,如果有人预言“以后给报纸写分类广告文案的人会变少”,所有人都听得懂,也都会陷入失业的恐慌。
这就是今天全人类面对AI浪潮时,最大的认知盲区。
近日,OpenAI首席经济学家Ronnie Chatterji与团队应用科学家Harrison Satcher接连抛出重磅研究《We don’t have the nouns yet》(我们还没有那些名词),在硅谷与经济学界掀起轩然大波。
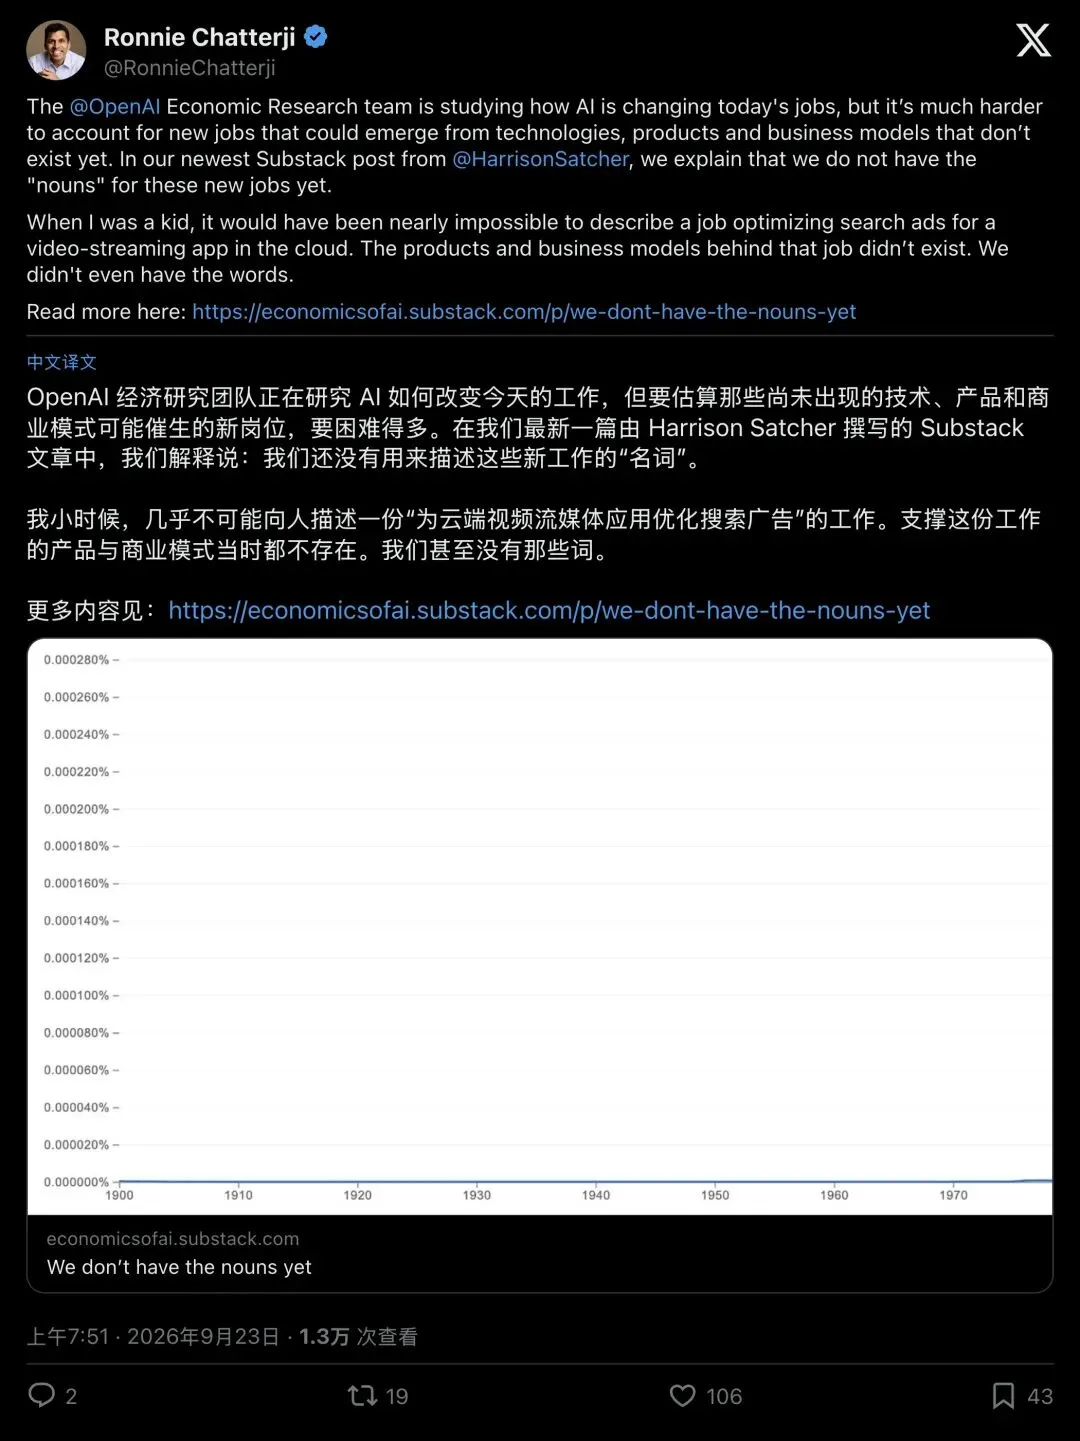
▲ OpenAI首席经济学家Ronnie Chatterji发文指出:核算尚未出现的技术与商业模式所催生的新工作极其困难,因为我们甚至还没有对应的“名词”
他们的核心结论极其犀利:我们之所以对AI抢饭碗感到绝望,是因为即将消失的旧工作都有现成的名字;而未来最庞大、最赚钱的新工作,人类甚至连称呼它们的“名词”都还没造出来。
那些连名字都没有的工作,究竟是怎么从空气里长出来的?剥开OpenAI内部百万级对话数据与三百年技术演进史,我们可以拆解出未来职业裂变的三大底层机制。
01机制一:“相邻可能”的多米诺骨牌,为什么预测模型永远算不出新饭碗?
在经济学里,有一个致命的算账陷阱:看得见的损失,与看不见的收益。
当一台新机器出现时,谁会丢掉饭碗是一目了然的。1900年代内燃机汽车刚上路时,报纸戏称它为“富人的无马马车”,全社会都在替马车夫、养马场主和街头铲马粪的工人焦虑;可当时没有任何一个经济学家能预言,这台 noisy 的铁盒子后来会催生出高速公路土木工程师、红绿灯维保员、车险定损专员、汽车旅馆老板和得来速(Drive-thru)餐厅服务员。
为什么人类在技术起点上,永远患着严重的“想象力贫血症”?
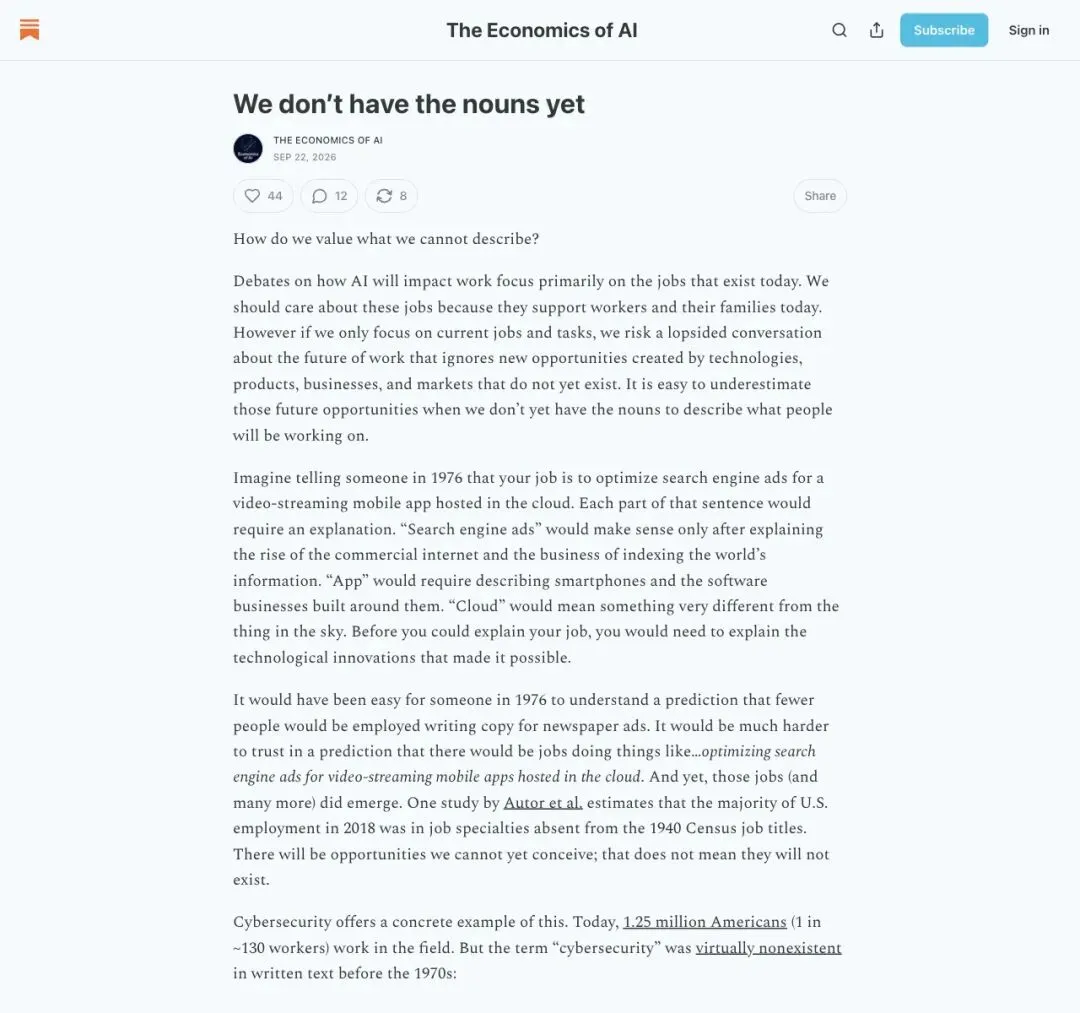
▲ OpenAI经济研究团队在Substack发表《We don’t have the nouns yet》,开篇直击本质:“我们如何给无法描述的东西估值?”
Satcher在文中搬出了硬核证据:今天全美有约125万人从事“网络安全(Cybersecurity)”工作,相当于每130个打工人里就有一个。但如果翻开1970年代之前的英文书刊,你会发现“Cybersecurity”这个词在人类语言里几乎是一片空白。
麻省理工学院经济学家David Autor的研究揭示了一个类似的事实:2018年美国绝大多数的就业人口,干的都是1940年人口普查职业表里根本不存在的行当。
新工作不是凭空掉下来的,它遵循复杂科学中著名的“相邻可能(Adjacent Possible)”机制,以及通用技术(GPTs)的“创新互补性”。
简单来说,技术创造工作就像推倒一排藏在迷雾里的多米诺骨牌,每一块骨牌倒下,才会解锁下一块骨牌的“相邻可能”:
人类先造出了火箭,才顺手解锁了发射卫星的可能; 有了漫天卫星,才解锁了民用GPS定位; 当GPS与另一条科技树上的智能手机撞在一起,才突然炸出了网约车平台与外卖软件; 直到这一步,围绕这些App做UI设计、算法调度、运力维护的数百万个新岗位,才正式拥有了自己的名字。
要求今天的人类在AI大模型刚诞生时,就列出十年后的新职业清单,就像要求1950年代造火箭的工程师,精准预测出“外卖骑手路径算法工程师”一样荒谬。 语言永远滞后于商业模式的裂变,没词儿,绝不代表没机会。
02机制二:从“任务跨界”到“胶水代码”,一个新工种孵化的四步暗线
既然新职业在事前叫不出名字,那它在破土而出之前,到底长什么样?
为了抓到这个“幽灵”,OpenAI经济研究团队干了一件大事。他们在《Work at the Frontier》(工作在前沿)系列报告中,直接剖析了全美超过80万条真实的工作类ChatGPT对话数据,结果揪出了一个惊人的现象,任务交叉(Task Crossover)。
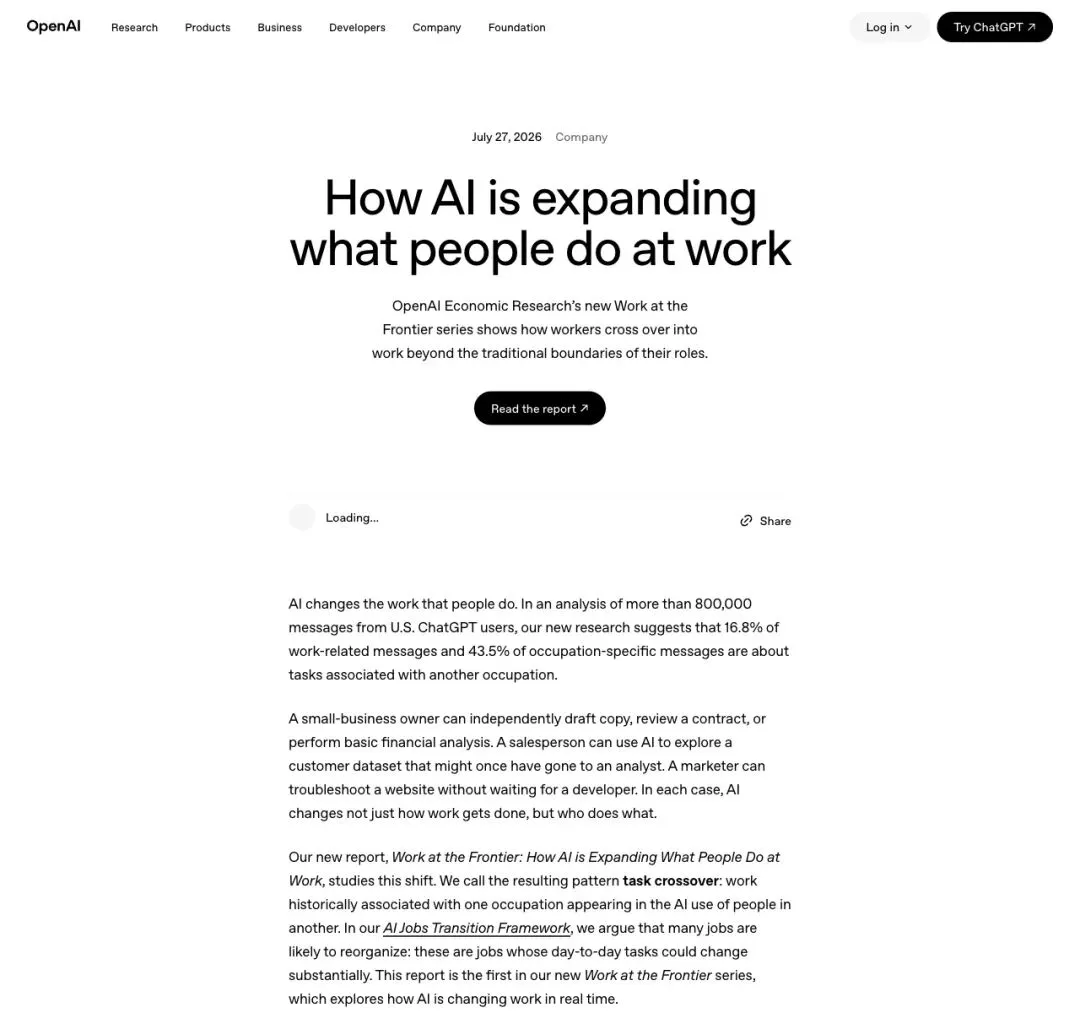
▲ OpenAI报告披露重磅数据:在特定职业的AI使用中,高达43.5%的任务跨越了原有的岗位边界
数据显示,在所有与特定职业相关的AI使用中,高达43.5%的对话,干的都是传统上属于“别人家岗位”的活儿!
小餐馆老板在用AI写营销文案;销售人员在对话框里抓客户数据做分析;市场部员工正忙着给网站排查代码故障。岗位名称虽然还没改,但工种之间的围墙已经在对话框里塌了一半。
结合经济史学家Joel Mokyr梳理的电气化、民航与微机革命史,以及科技圈的一线洞察,我们可以清晰地拆解出通用技术孵化新职业的“四阶段演进铁律”:
- 第一阶段(基建与焦虑)
:技术刚铺开,全社会盯着存量替代,只能用旧词套新物(比如把汽车叫“无马马车”,把早期AI工种叫“提示词工程师”)。 - 第二阶段(接口固化与跨界混战)
:正是我们眼下所处的阶段!内部表现为43.5%的“任务交叉”;外部则如网友一针见血的机制拆解,只有当底层API接口彻底稳定后,第三方开发者才能写出连接现实业务的“胶水代码(Glue Code)”。 - 第三阶段(新商业物种涌现)
:通用技术与千行百业的资产发生化学反应。就像电网遇上光学和声学,突然长出了电影院和无线电广播。 - 第四阶段(分工沉淀与赐名)
:围绕新物种的日常运转,那些原本由打工人“跨界兼职”干的琐碎任务,正式独立成高薪专职,最终被写进招聘软件和国家统计局的职业字典。
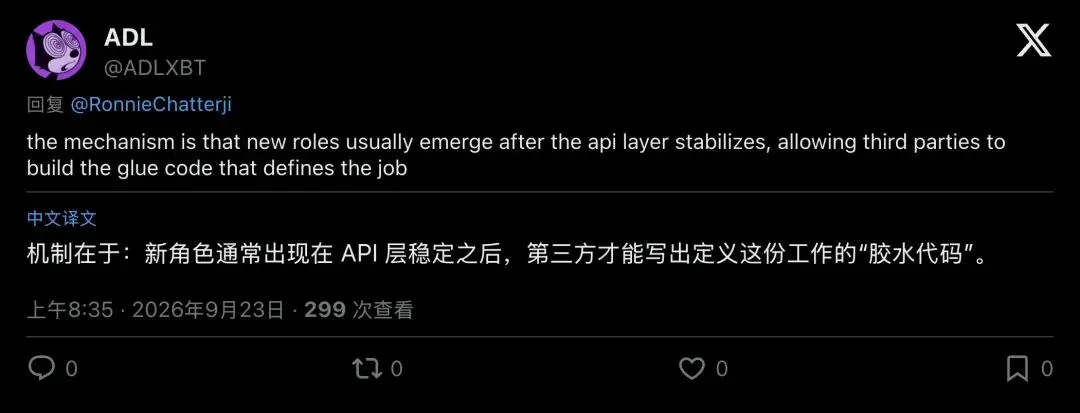
▲ 评论区高赞洞察:新职业往往诞生在API层稳定之后,由第三方编写出定义该岗位的“胶水代码”
今天,第一波叫得出名字的AI工作其实已经浮出水面:2023至2025年间,LinkedIn上全球新增了约130万个AI相关岗位,连电信巨头T-Mobile都在招“AI成本管理分析师”;美国非IT岗位要求生成式AI技能的招聘量更是暴增了9倍。但这仅仅是开胃菜,更深层的变革还在后头。
03机制三:三阶冲击波与“财富工作”,为什么AI造出的饭碗可能跟代码毫无关系?
如果以为未来的新工作全都带着“AI”两个字,那就又掉进了另一个思维死角。
《大西洋月刊》记者Annie Lowrey在近期引发热议的《非AI的AI工作》(The Non-AI AI Jobs)一文中,与耶鲁大学预算实验室执行主任Martha Gimbel一起,把技术对就业的冲击拆解成了“三阶冲击波”。
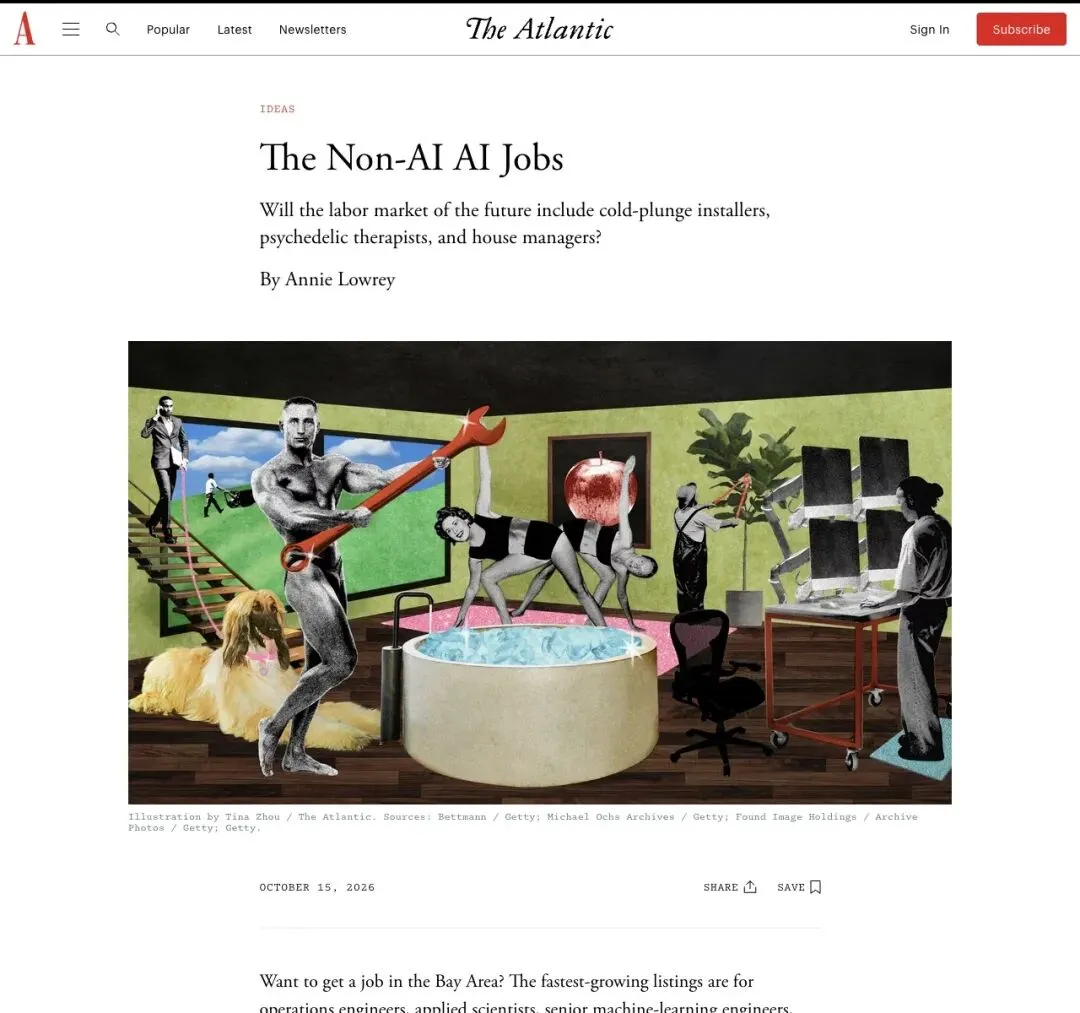
▲ 《大西洋月刊》刊文追问:AI时代的未来劳动力市场,会不会由冷水浴安装工和家庭事务经理组成?
一阶效应是直接的:造大模型、建数据中心、洗数据。二阶效应是伴生的:就像看着一台内燃机炉子,没人能想到后来会需要“空姐”和“空中交通管制员”一样,麦肯锡预测未来数年仅围绕AI应用支持与合规迭代,就会诞生50万到200万个此前无法想象的二阶新岗位。
而最颠覆常识的,是三阶效应,“财富工作(Wealth Jobs)”。
底层逻辑很简单:当通用技术极大拉升了全社会的生产率、让一部分人暴富并抬高整体购买力后,人类会把省下来的钱,疯狂砸向祖辈看来“荒唐透顶”的情绪、健康与体验服务。
Gimbel举了一个让人会心一笑的例子:今天很多年轻人会打电话给爸妈说,“我刚花钱请人帮我做了一件某事”。爸妈听完第一反应绝对是骂一句“纯粹乱花钱!”但沉默两秒后,爸妈往往会小心翼翼地追问一句:“……那感觉爽吗?”你老实回答:“其实挺爽的”
两百年前,人类在技术上就完全有能力提供婚礼策划、普拉提私教、宠物心理疏导,甚至是极少数的“水侍酒师(Water Sommelier)”和“冷水浴安装工”。但当时的生产力不允许普通人为此买单。
AI越是把数字世界里的生产成本打到地板价,现实世界里那些依赖“真人体温、当面共情、物理折腾与背锅担责”的服务溢价就会被推得越高。 正如OpenAI的Satcher转发这组观点时所赞叹的:由AI催生的新工作,最终可能与AI本身毫无关系。
04尾声:在词典追上时代之前,普通人该如何破局?
当然,看懂了长周期的乐观机制,绝不意味着我们可以粉饰眼前的阵痛。
历史从不保证被淘汰的马车夫能直接转行当飞机管制员。新机会与旧失业的错位,不在同一个时间、不在同一个城市、甚至不在同一代人身上发生,才是技术革命最残酷的摩擦成本。在词汇追赶上来之前,现实里的每个人仍然得面对日常的生计。
但也正因如此,OpenAI这份报告给所有普通人指明了一条最实在的生存法则:
千万不要把自己死死焊在今天名片上的那个“旧名词”里。
当43.5%的岗位边界已经在AI对话框里融化时,那些不等新名词发明出来、就主动用AI去跨界吞并上下游任务的人,那些正在业务缝隙里手搓“胶水代码”的人,以及那些深耕人际信任与真实体验的人,他们不需要等字典更新,因为他们自己,正在成为那个新名词本身。