ARTICLE · 1215611
端侧AI工具链原理(01):AI编译器、传统编译器与Runtime:一个模型如何变成可执行资产
本文是端侧 AI 工具链原理第 1 篇。本辑不从某个平台的命令行开始,而是先建立一张稳定的全栈地图:模型、编译器、Kernel 库、驱动与 Runtime 分别负责什么。
开篇:模型转换成功,为什么设备上仍然跑不起来
算法团队导出一个 ONNX 模型,工具提示转换成功,设备却可能出现三种结果:模型加载失败、部分算子回退 CPU、能够运行但性能远低于预期。
原因是“转换成功”只证明某一段流程通过,并不等于模型已经完成从数学语义到目标硬件的全部 Lowering。
完整链路可以写成:

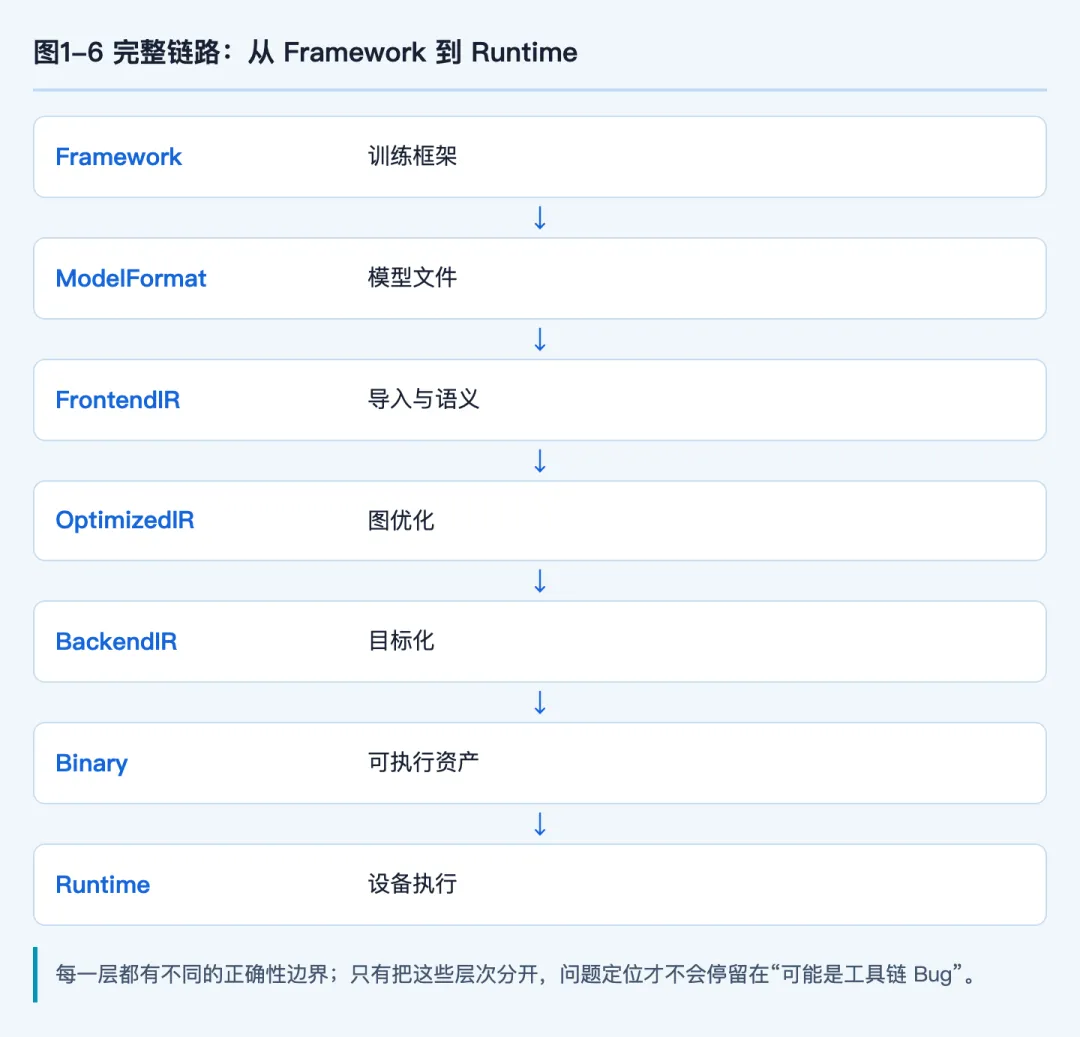
每一层都有不同的正确性边界。只有把这些层次分开,问题定位才不会停留在“可能是工具链 Bug”。
一、传统编译器解决什么问题
传统编译器通常把 C/C++等程序转换为目标 ISA。它处理控制流、标量与向量指令、寄存器分配、指令调度、链接和二进制生成。
其典型对象是:
传统编译器也做 Loop 优化和向量化,但它通常看不到“这是一个 Attention Block”“这个 Tensor 是 NCHW 布局”“这一组卷积可以跨层融合”等高层语义。
二、 AI 编译器多处理了哪几层
AI 编译器的输入不是任意程序,而是带有 Tensor、Shape、数据类型和算子语义的计算图。它需要处理:
AI 编译器不是传统编译器的替代品。后端仍可能调用 LLVM 完成 CPU 代码生成,也可能使用目标厂商汇编器、 Firmware Compiler 或 Kernel 库。
三、为什么需要多层 IR
一个 IR 若同时表达模型语义、硬件 Tile 和最终指令,会迅速变得难以维护。多层 IR 的价值,是在不同阶段保留恰当的信息。
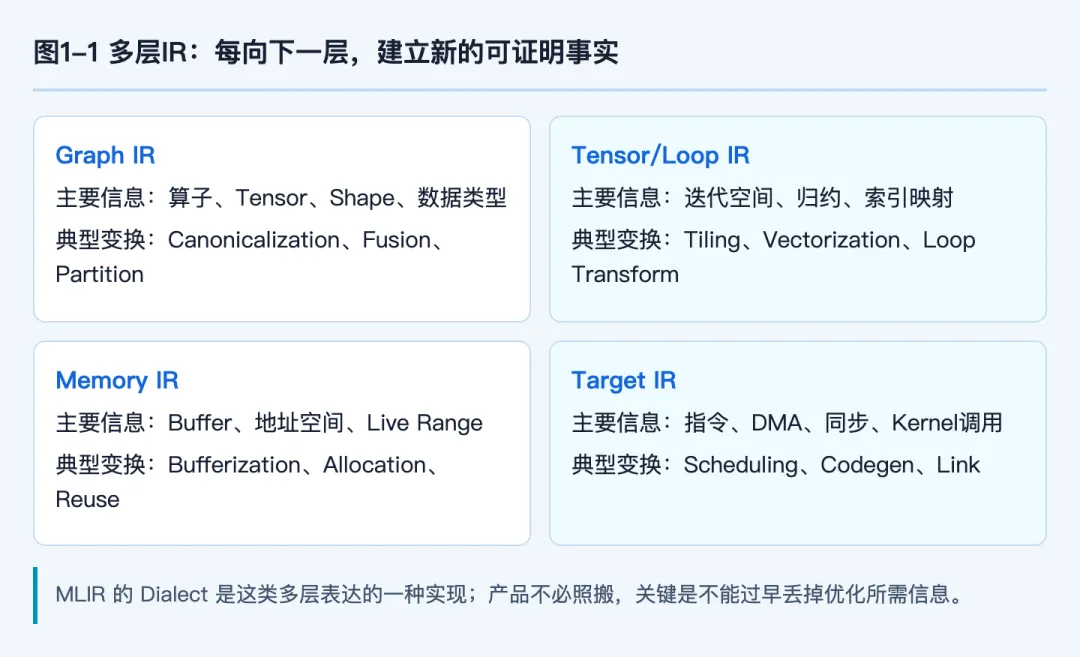
MLIR 的 Dialect 设计就是一种多层表达方法:高层算子可以逐步 Lower 到 Linalg、Vector、MemRef、GPU 或 LLVM 等更低层语义。但具体产品不必照搬 MLIR,关键是不能过早丢掉优化所需信息。
四、 Runtime 不是“运行一下二进制”
编译器生成的资产通常不能独立执行。Runtime 负责把静态计划放入动态系统环境,包括:
Runtime 面对的是“这一次执行”的状态,编译器面对的是“所有合法执行”的计划。两者的分界取决于硬件可编程性和产品需求。
五、静态编译和动态调度怎样分工
假设输入序列长度S在[1, 4096]变化。编译器可以为若干 Bucket 生成计划, Runtime 根据实际S选择:
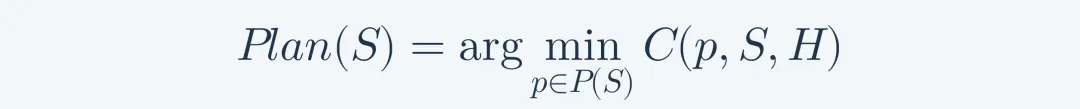
其中P(S)为支持该 Shape 的计划集合,H为当前硬件状态,C为时延、内存和功耗的综合代价。
静态阶段适合完成可证明、可复用的优化;动态阶段适合处理输入、负载、温度和并发变化。把所有决策都留给 Runtime 会增加启动和调度开销,把所有决策都固化又难以适应动态环境。
六、 Kernel 库在工具链中处于什么位置
很多后端不会为每个算子从零生成指令,而是选择经过优化的 Kernel 实现。
一个 MatMul 可能有多个候选:
编译器需要根据 Shape 和硬件状态选择 Kernel,并为其准备 Layout 、 Workspace 和同步。Kernel 库越成熟,编译器越像“选择与组合系统”;硬件越专用,后端越可能直接生成 Command 或 Microcode 。
七、驱动、 Firmware 与 Runtime 不是一层
典型端侧栈可以分为:
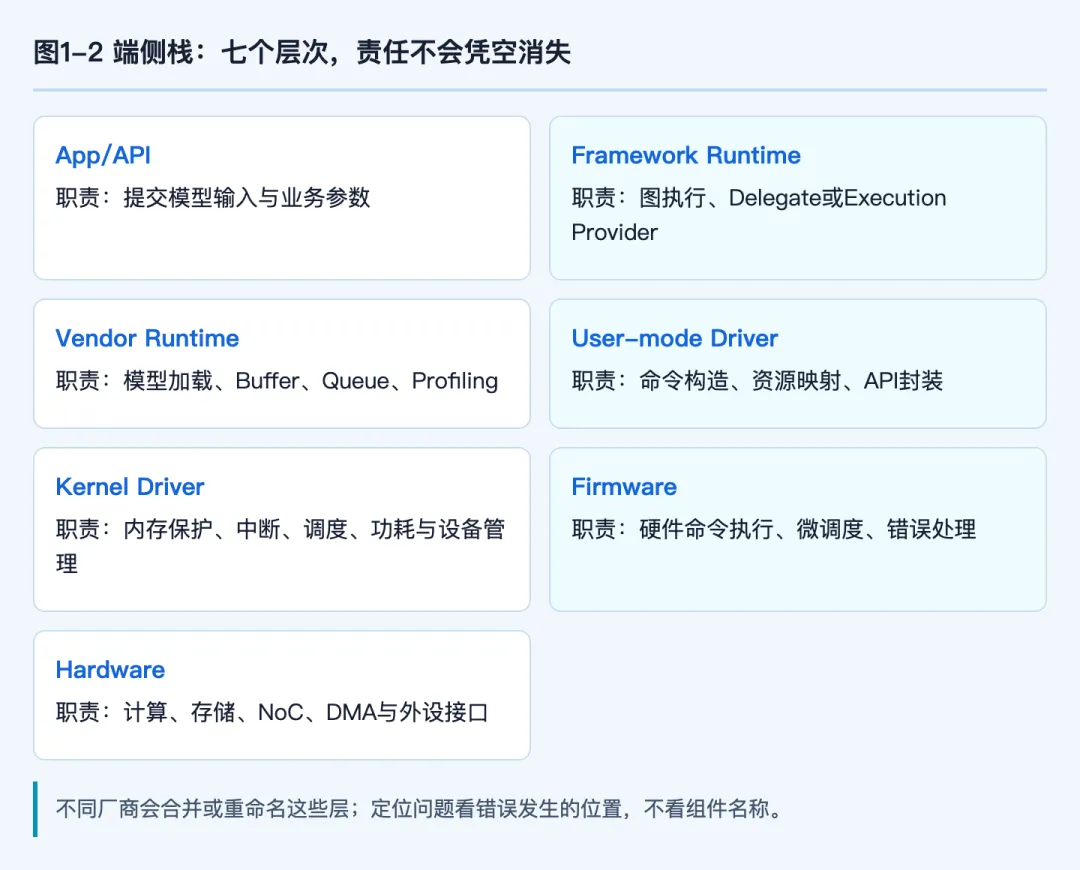
不同厂商会合并或重命名这些层,但责任不会凭空消失。定位问题时应根据错误发生的位置,而不是根据组件名称猜测。
八、一次推理的真实时间线
首次执行可能包含:
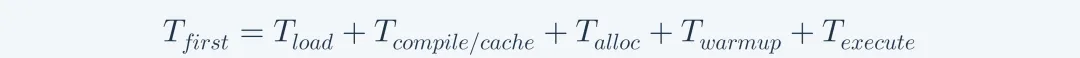
稳态执行可能接近:
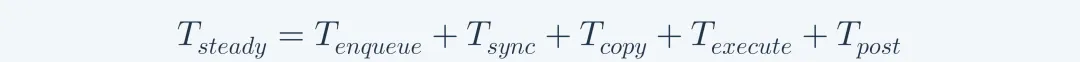
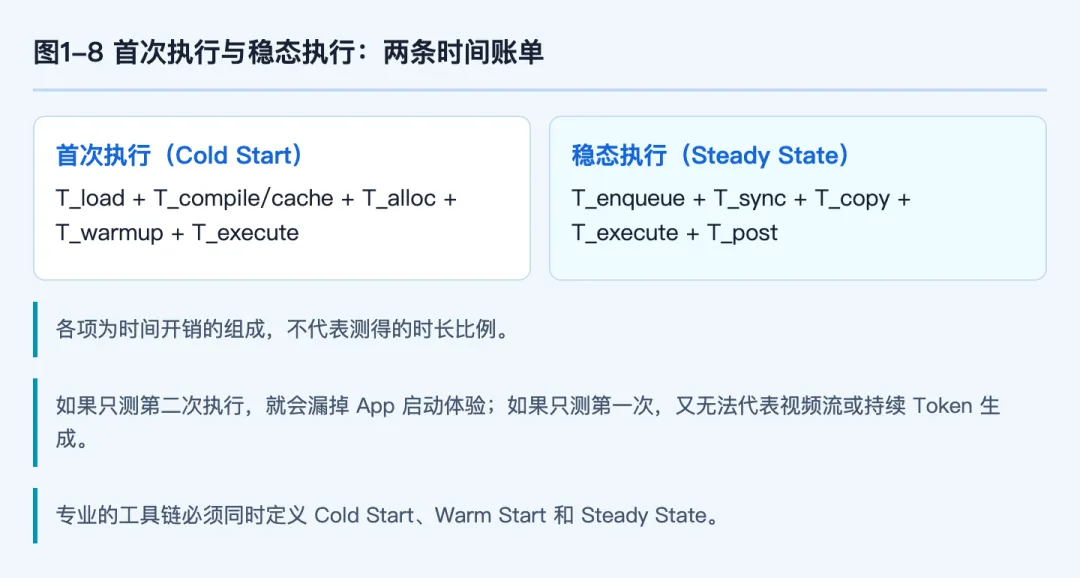
如果只测第二次执行,就会漏掉 App 启动体验;如果只测第一次,又无法代表视频流或持续 Token 生成。
专业的工具链必须同时定义 Cold Start、Warm Start 和 Steady State。
九、工具链的三类失败
语义失败
模型格式转换后结果改变,常见原因是算子版本、Padding、Resize 坐标、广播和量化语义不一致。
映射失败
图语义正确,但目标后端不支持某个算子、Shape、数据类型或参数组合,导致编译失败或 Fallback。
性能失败
模型完整落到加速器,却因为 Reformat、 Spill、低利用率、同步或内存带宽而慢。
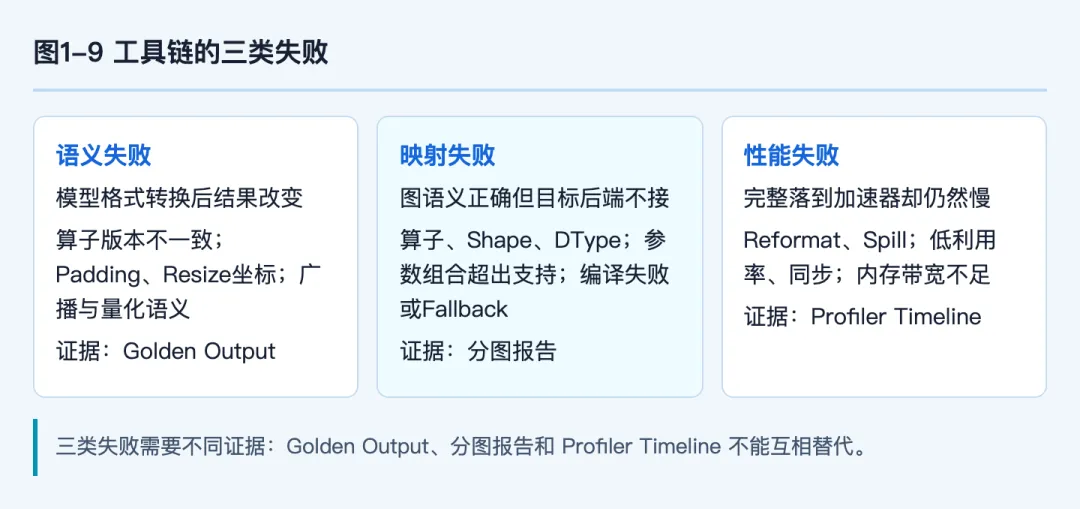
三类失败需要不同证据:Golden Output、分图报告和 Profiler Timeline 不能互相替代。
十、交付物不应只有一个模型文件
可复现的可执行资产至少包括:
这些内容共同构成 Artifact Contract。只保存一个.bin文件,会让后续升级无法判断差异来自模型、编译器还是 Runtime。
十一、用一个 Transformer Block 走完编译链
以包含 RMSNorm、QKV Projection、RoPE、Attention、Output Projection 和 MLP 的 Block 为例,高层图只说明 Tensor 依赖。进入工具链后,至少发生六轮责任转移。
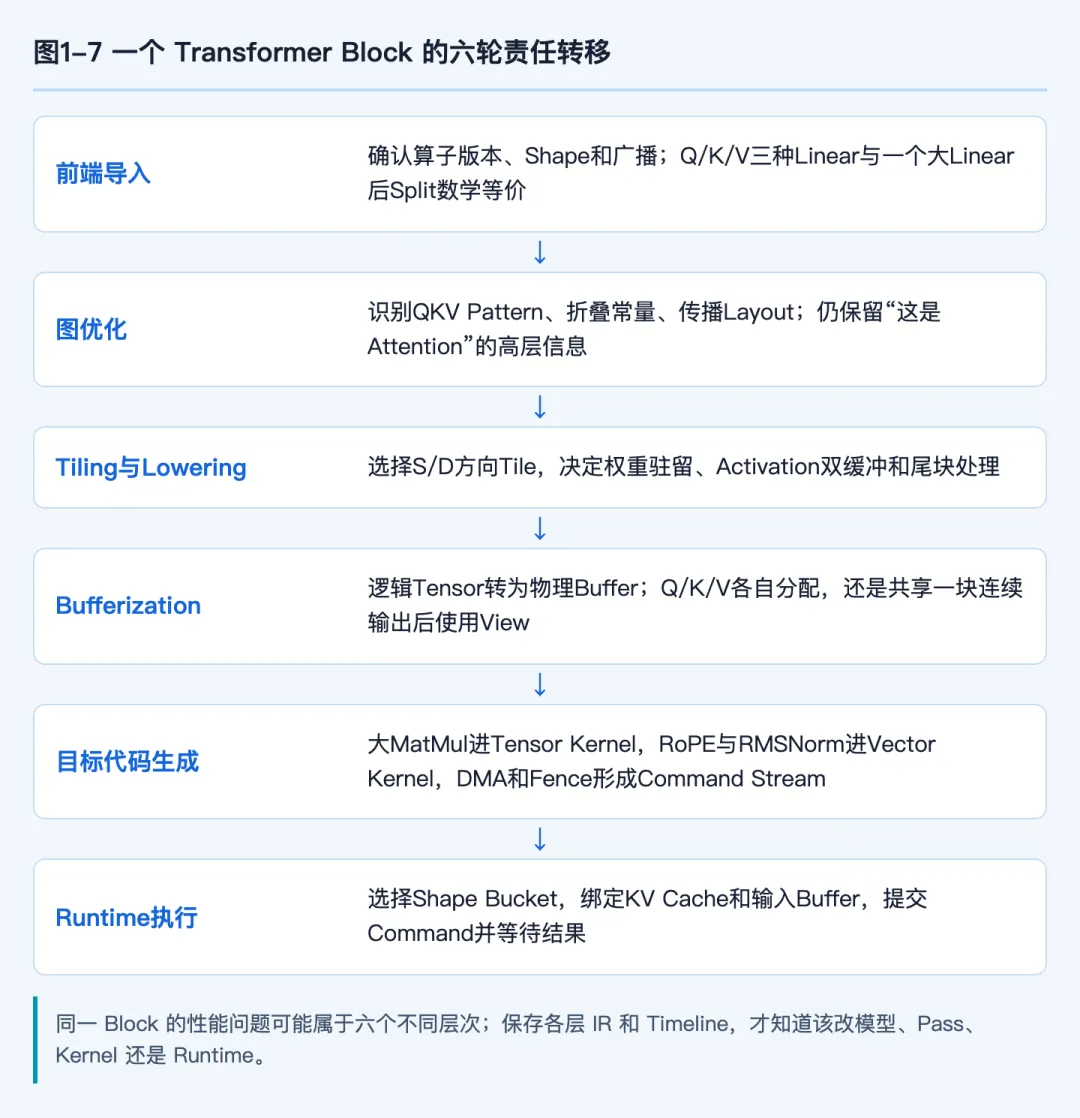
前端导入
前端确认算子版本、Shape 和广播,把框架特有表达规范化。例如 Q、K、V可能由三个 Linear 表示,也可能由一个大 Linear 后 Split 。两种图数学等价,却对应不同 Fusion 机会。
图优化
编译器识别 QKV Pattern、折叠常量、传播 Layout,并决定 RMSNorm 和 Residual 能否进入同一后端。此阶段仍保留“这是 Attention”的高层信息。
Tiling 与 Lowering
设 Hidden Size 为D、Head 数为H、序列长度为S。QKV的主要矩阵形态为[S,D] x [D,3D]。编译器选择S/D方向 Tile ,并决定权重驻留、Activation 双缓冲和尾块处理。
Bufferization
逻辑 Tensor 转为物理 Buffer。Q、K、V是否各自分配,还是共享一块连续输出后使用 View,会直接改变峰值内存和后续 Layout。
目标代码生成
大 MatMul 进入 Tensor Kernel,RoPE 和 RMSNorm 进入 Vector Kernel,DMA 和 Fence 形成 Command Stream。若 RoPE 不支持而回退 CPU,Graph 边界必须显式插入。
Runtime 执行
Runtime 选择对应 Shape Bucket,绑定 KV Cache 和输入 Buffer,提交 Command 并等待结果。动态序列长度、并发 Context 和设备温度都在此时出现。
这个例子说明,同一 Block 的性能问题可能属于六个不同层次。只有保存各层 IR 和 Timeline,团队才知道应该修改模型、Pass、Kernel 还是 Runtime 。
十二、 Compiler 与 Runtime 的边界怎样设计
把决策放在编译期,优点是可重复、启动开销低、容易做全局搜索;放在 Runtime,优点是能根据真实 Shape、并发和温度变化。
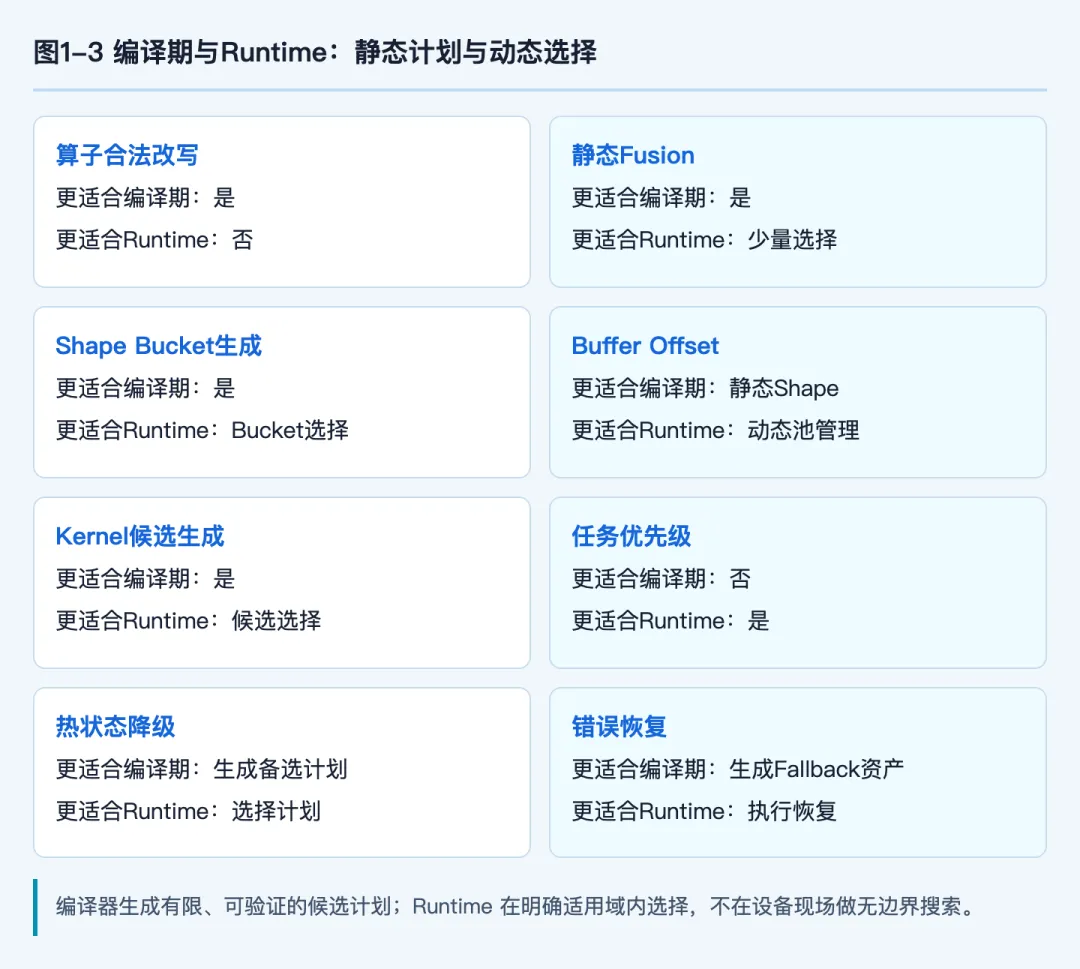
一个稳定原则是:编译器生成有限、可验证的候选计划,Runtime 在明确适用域内选择,不在设备现场进行无边界搜索。
十三、工具链问题的定位矩阵
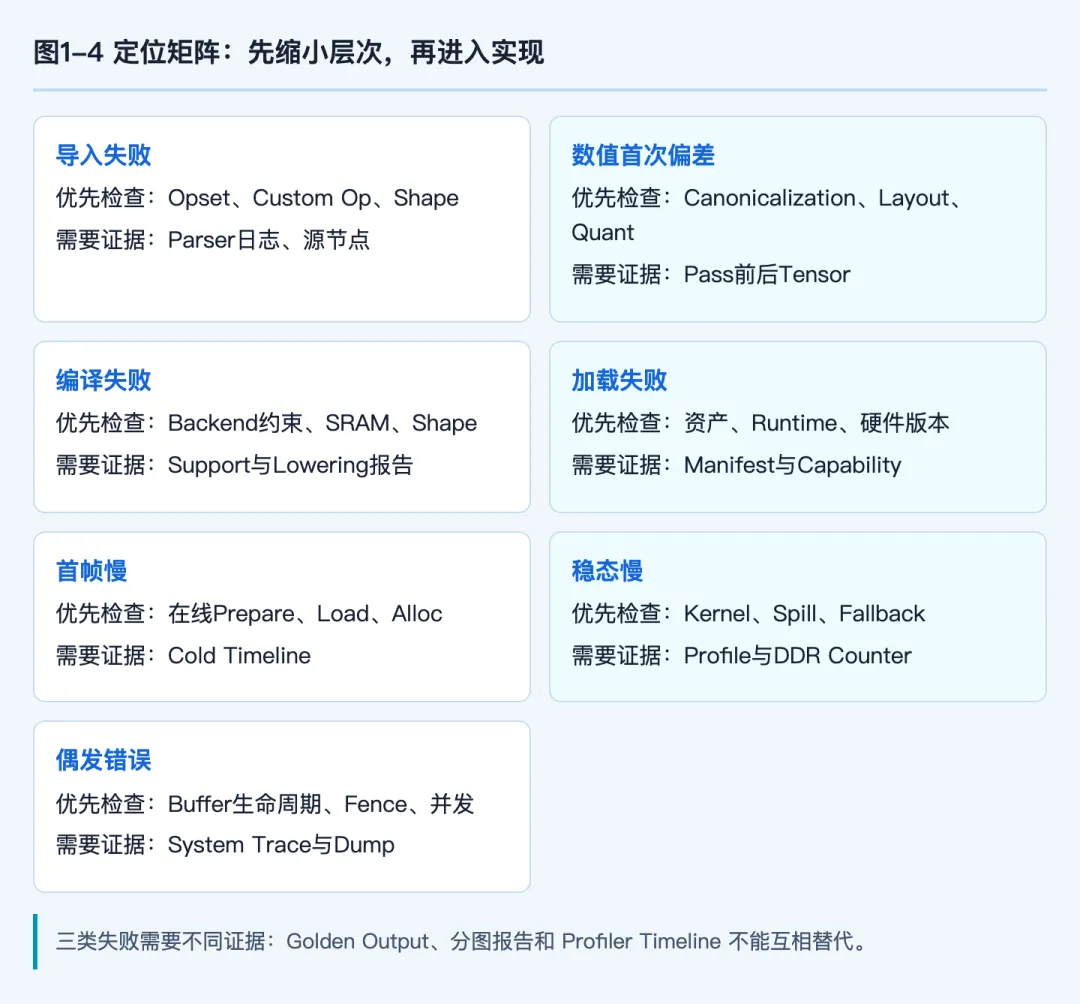
先按现象缩小层次,再进入具体实现,可以避免所有问题都在模型端反复试导出。
十四、多层 IR 到底怎样保存和收缩语义
“使用多层 IR”不是把同一张图换几次语法,而是每向下一层都要建立新的可证明事实。
Graph IR :回答算子语义和 Tensor 关系
这一层保留 Conv、Attention、Norm等领域语义,Tensor具有逻辑 Shape、DType、Layout 与 Quant 信息。优化器可以证明 QKV Fusion 是否合法,却还不承诺具体循环和 Buffer。
Graph IR 的 Verifier 至少检查:输入输出数量、Rank、广播、属性范围、量化 Axis、Side Effect 和 Use-Def。任何“后端自己处理”的模糊字段,都会在后续变成不可定位的分歧。
Structured/Loop IR :回答迭代空间和归约
MatMul 不再只是一个节点,而被描述为 Parallel 维M/N与 Reduction 维K。卷积展开为 Batch、Output Channel、Spatial、Input Channel 和 Kernel 循环。
这一层决定:
如果 Graph IR 在此之前丢失了 Layout 或 Quant Axis,循环索引即使数学正确,也可能读取错误物理通道。
Memory IR :回答值在哪里存在
Tensor SSA 值被 Buffer 化为地址空间、Offset、Stride、Alignment 和 Live Range。此时需要明确 Local SRAM、DDR、Constant Memory 和 Host Shared Memory。
一个高层reshape可能 Lower 为零拷贝 View,也可能因为目标 Layout 不连续而变成真实 Copy。只有 Memory IR 才能给出答案。
Target IR :回答硬件怎样执行
Tile 变成 DMA、Tensor/Vector 指令、Barrier 和 Fence。此层需要保证:本地 Buffer 不越界、异步依赖完整、指令数据类型和 Accumulator 匹配、硬件 Revision 支持。
每层的输出不是“尽量接近下一层”,而是满足一组后置条件。推荐为每次 Lowering 保存:
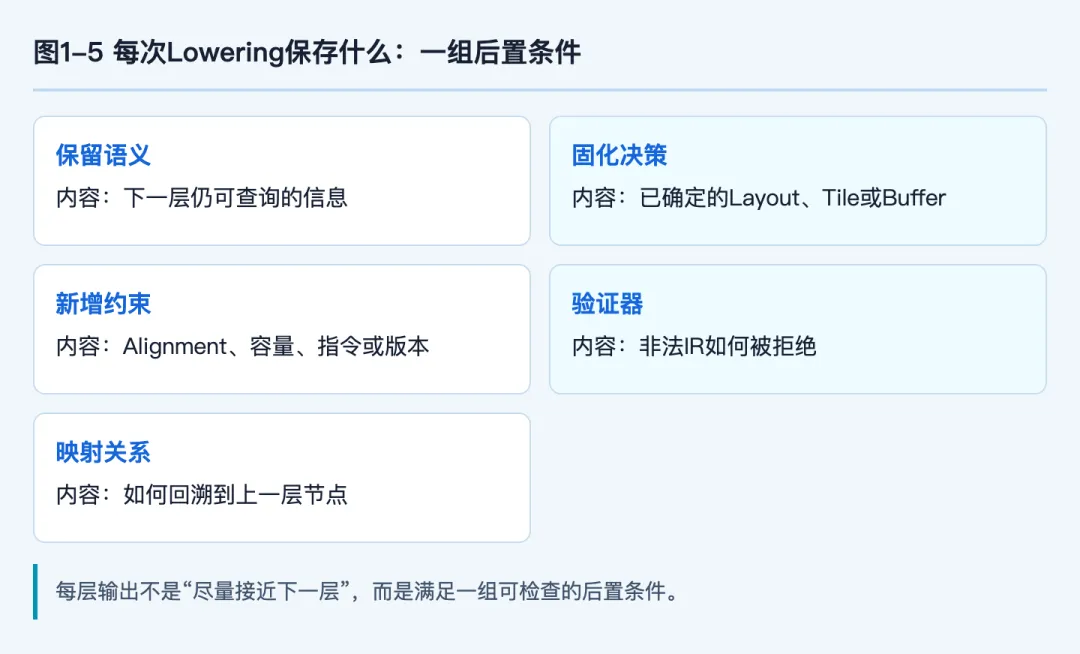
十五、传统编译器和 AI 编译器在哪里真正汇合
AI 后端并非到最后才使用传统编译技术。在 CPU/GPU/可编程 DSP 路径中,Loop IR 会继续 Lower 为 Vector、LLVM IR 或目标汇编,随后执行寄存器分配、指令调度和链接。
但两者优化目标不同。传统寄存器分配关心 Live Range 与 Spill;AI 编译器在更高层还可以改变 Tile、Fusion 和 Layout,从根源上缩短 Live Range。若等到 LLVM 层才发现 Spill,许多 Tensor 级选择已经无法恢复。
因此,跨层反馈非常重要:低层报告 Register Pressure、指令数和 Local Memory 占用,高层据此调整 Fusion 与 Tile。编译流程不是单向瀑布,而是有边界的迭代搜索。
十六、一个成熟工具链需要哪些调试入口
没有这些入口,工具链只能“给答案”,不能解释答案。模型规模增大后,无法解释本身就会成为交付瓶颈。
工程检查清单
结尾:工具链是一组连续契约
AI 模型从 Framework 走到 NPU,不是一次格式转换,而是连续降低抽象层次的过程。每一层都要回答:输入语义是什么、输出保证是什么、失败如何被发现。
下一篇将进入最常见的入口文件:PyTorch、ONNX、TFLite 与 IR 分别承载什么,为什么“格式能打开”不等于“语义可移植”。
参考资料
参考链接
[1] MLIR Documentation: https://mlir.llvm.org/docs/
[2] MLIR Linalg Dialect: https://mlir.llvm.org/docs/Dialects/Linalg/
[3] ONNX IR Specification: https://onnx.ai/onnx/repo-docs/IR.html
[4] Google AI Edge: LiteRT: https://ai.google.dev/edge/litert
--------------------------------
我是半川
一个偏爱在芯片底层与光影算法里死磕细节的工程师
从本辑开始了纯软件的系列,开始进入到相对更加舒服的领域,也做完了所有的铺垫和宏观加微观的表述,开始进入到熟悉的影像及芯片底层相结合的部分,徐徐展开,慢慢来,个人的表述更多是从应用角度出发,所以如果有表述不对的地方希望一起讨论,加油!