ARTICLE · 1221240
AI生成的教案,你敢直接上讲台吗
AI生成的教案,你敢直接上讲台吗
先看一份教案。
初一数学,《勾股定理》第一课时,AI三分钟出稿。排版漂亮,环节齐全,学情分析、教学目标、教学过程、板书设计一应俱全。拿起来顺顺利利就能讲。
问题出在三个地方。
第一处,巩固练习。两直角边分别是7和24,求斜边。根号下49加576,等于25。AI印的参考答案是26。就多了一道勾。全班几十个孩子照着26往下练,错得整整齐齐,还没人知道自己错在哪。
第二处,教案开头写着,依据2011年版义务教育数学课程标准。2022年版新课标,都用进去第四年了。
第三处,导入环节。第一课时,学生还没见过定理本身,AI先塞进来一道要用逆定理才能判断的题。超纲,而且错配了学段。
三个错,藏在一条极其流畅的叙述里。读起来哪儿都通顺,哪儿都不像有问题。
说句实话,这份教案是我把培训里讲的问题类型拼起来的复原案例,不是哪一个具体班级的真事。但你可以拿去问问身边让AI出过教案的老师,这样的错,他们多半都捡到过。
事情是这样的。10月14日,北师大未来教育高精尖创新中心把一场培训送进了海淀区建华实验学校,讲AI怎么辅助教师教学。培训梳理了AI常见的六类典型问题,幻觉、质量参差、时效滞后、偏见、逻辑与计算错误、超纲与学段错配。前面那份教案,一口气占了三样。
培训里有句话说得挺直白。流畅不等于正确,必须先审后用。
为什么AI写的东西读着那么顺?因为流畅本来就是它的看家本领。大模型干的事,是预测下一个最可能出现的词,一个字一个字往后接,接得越顺,它越成功。它的目标是让句子通顺,不是让事实准确。你读到的通顺,是生成机制的正常发挥,不是正确性的任何保证。
有个研究数据挺说明问题。EduWild的研究团队做过一个测试,给教师配置的AI聊天机器人接入教学工作流之后,53.8%的对话跳过了工作流步骤。将近一半的对话,AI没走完该走的流程,直接把答案递到了教师手上。工具不会主动提醒你它抄了近道。话都递到你嘴边了,你不追问,它不会自己说。
所以问题从来不在于AI会不会出错,而在于它出错的方式太安静。人写错东西,写着写着自己就露馅了。AI不,它把错误包装得跟真理一个口气。
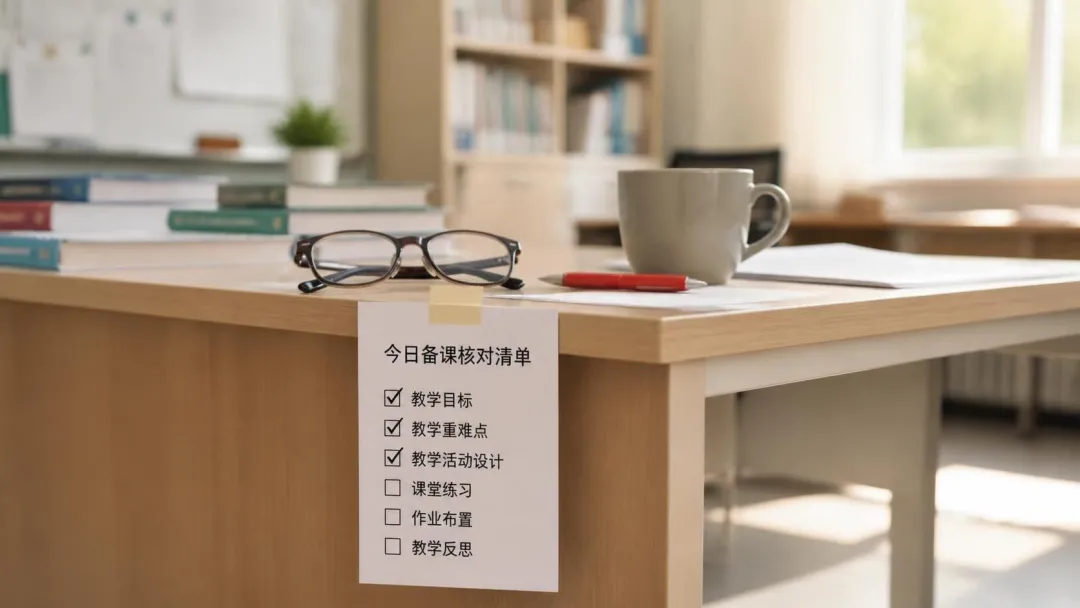
北师的方案,是给每份AI初稿上一道六查。事实核查、来源验证、逻辑一致性、时效核对、适配检查、偏见与合规。听着像六件麻烦事,拆开看,每一条都对应一类翻车方式。
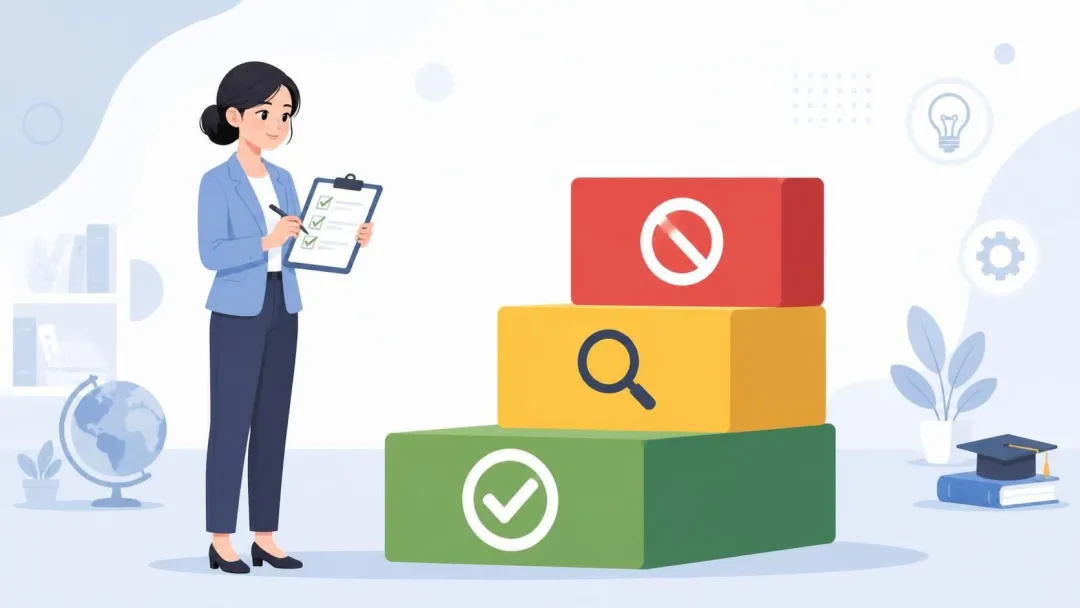
六查全做一遍,每份教案都这么查,不现实。所以还得叠一层风险分级,按内容可能造成的后果分三档。
零风险档,自用参考。备课灵感、素材参考、课堂点子,不直接进课堂,抽查事实和适配两查就行。
需复核档,进课堂的内容。课件、讲义、学案,六查全做,改动的地方再核一遍,标注来源,留存审查记录。
禁入课堂档,不经终审不许用。试卷和评分标准、对外发布材料、涉及学生数据和评价的内容,教师逐字终审,签字负责。这一档没有商量。
顺带说一句学生数据。培训里划的红线就四个词,先脱敏、不出本地、最小授权、人工复核。学生的姓名、成绩、家庭信息,喂给AI之前先脱敏,不往本地以外传,能不给的权限就不给,最后再过一遍人工复核。工具越顺手,数据交出去越顺手,这条线守不住,前面省的工夫全都不作数。
这套东西好在哪?可教、可做、可展示。
可教,六查是个系统,不是零碎技巧,一个学期就能跑成习惯。培训最后留的三个学习目标,其实就是照着做就行,完整跑一次教学任务,按清单改一份AI初稿,再把流程沉淀成自己的操作手册。
可做,把这张清单打印出来,贴在办公桌边上。AI出稿,你照着查,查完签字。医生的术前核查单、飞行员的起飞检查单,没人嫌它们慢。清单不生产安全,清单保证的是,出问题的时候,有人知道该在哪一步拦住它。
可展示,流程图加清单,做成一张海报挂在备课室,比一百句强调都管用。
再说句戳心的。AI读过全网的教案,知道《勾股定理》的标准流程,但它不知道你班上哪个孩子会在根号化简上卡壳,不知道上周刚讲的平方根还有一半人没消化。这些判断,教案里查不出来,只有天天站在教室里的人有。所以六查里最要紧的不是查知识,是查适配。
有人可能要问,这么审来审去,AI的效率优势岂不是没了?坦率的讲,会还回去一部分,但还回去的这部分,本来就不是AI该赚的。
教师把关,不是不信任AI,是专业责任。教案上不会印你的名字,但站在讲台上的人是你,望着你的学生也是你的。AI负责起草,教师负责把关。这句话的落点,从来都是后半句。