ARTICLE · 1223246
AI 单价降了一半,为什么你的账单没少一半
前言
10 月 16 日到 19 日,四天里出了三组数据:
企业调用 AI 的次数:涨了很多;
AI 的计价单位 token:均价跌了约一半;
企业的 AI 总支出:比 8 月还低了一点;
用得更多,花得更少。这不矛盾,就是单价跌得比用量涨得更快。
一、先搞懂 token 是什么
AI 是按「字数」收钱的。你发给它的内容、它回给你的内容,都算字数。这个字数的单位,就叫 token。
中文里差不多一个字一个 token,英文里一个 token 大概是一个词或半个词。
所以各家说的「降价」,降的都是同一个东西:每个字的单价。
二、降了多少?
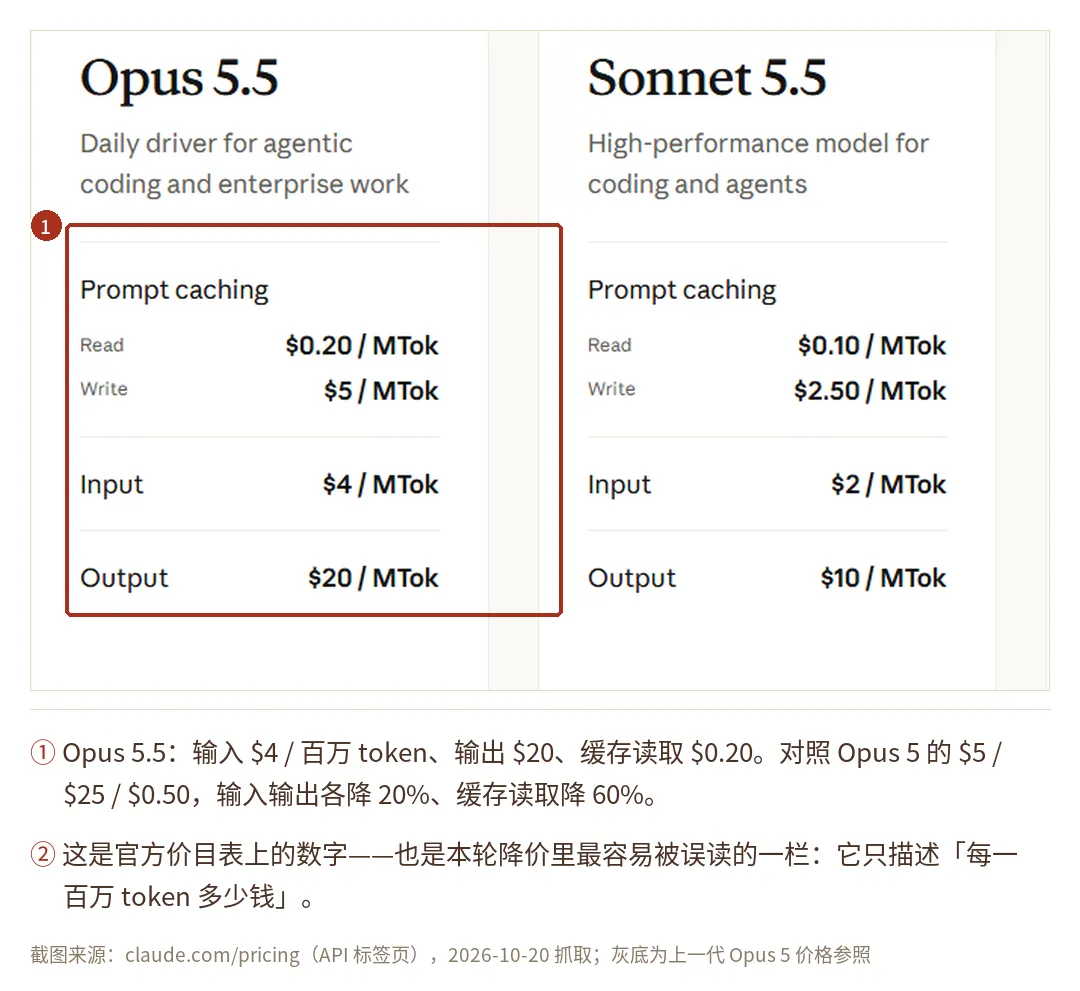
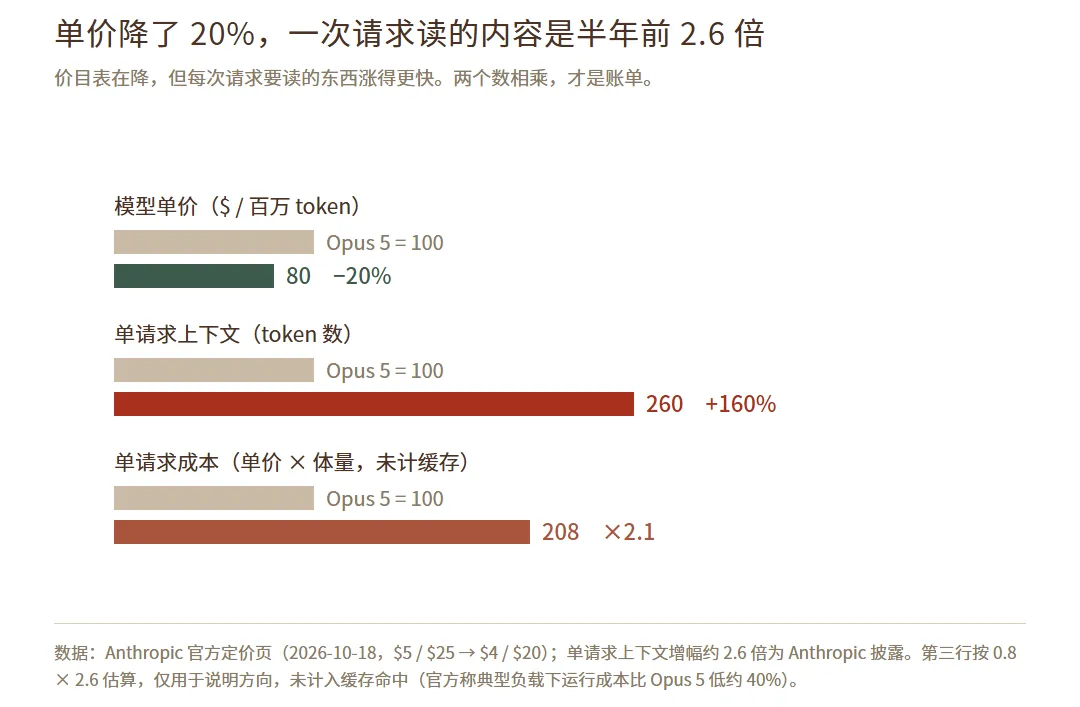
10 月 18 日,Anthropic 发布 Opus 5.5。每百万 token,输入 4 美元、输出 20 美元。
上一代是 5 美元和 25 美元,各降 20%。
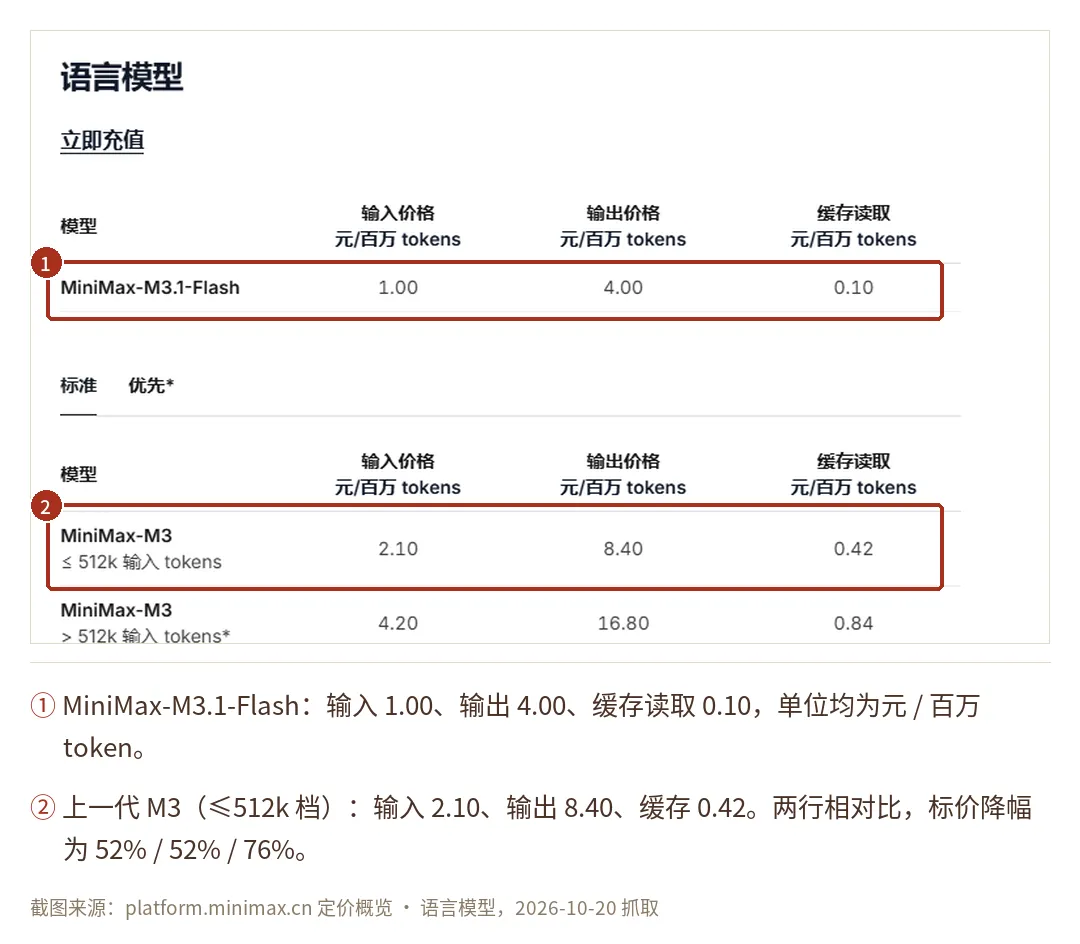
10 月 19 日,MiniMax 发布 M3.1 Flash。输入从 2.10 元降到 1.00 元,输出从 8.40 元降到 4.00 元,各降 52%;缓存从 0.42 元降到 0.10 元,降 76%。
这个模型发布前还有个小插曲。它先用一个假名字 Space Bunny 挂在平台上,匿名跑了超过 200 万亿 token,被人猜出来之后才正式挂牌。官方还给了个数据:输出速度接近上一代的 3 倍。
10 月 16 日,美国银行发了一份报告。说的是整个市场:token 的平均价格,从入夏到现在跌了约 50%。
三个数字,两个是厂商自己挂出来的价目表,一个是银行统计的市场均价。方向一致,都在降。
三、那为什么你的账单没少一半
因为算钱的是两个数相乘:单价 × 字数。
单价降了,字数也在涨。两个数得一起算。
Opus 5.5 的发布材料里有这么一行:现在一次请求携带的内容,是半年前的 2.6 倍。
这些内容有个名字,叫「上下文」。就是你塞给 AI 的东西:资料、聊天记录、代码、文档。它每次回答之前,都要把这些重新读一遍,读了就算钱。
为什么变多了?因为 AI 干的活变了。
两年前你用它,是问一句、答一句,一次几百个字。现在你让它读合同、改表格、写代码,它得连着干十几步。每一步的结果都得留着,下一步它才知道前面干了什么。到了第十步,它读的是前十步攒下来的全部内容。
单价打了八折,一次读的字数变成 2.6 倍。两个相乘,一次请求的实际花费,是上一代的 2.1 倍。
这里要说清一件事:单次请求变贵,不等于总账一定变贵。企业大部分的活交给了便宜模型,只有最难的活才用贵的那一档。分开说。
四、官方说降 70%,实测降 57%
再看一个例子。
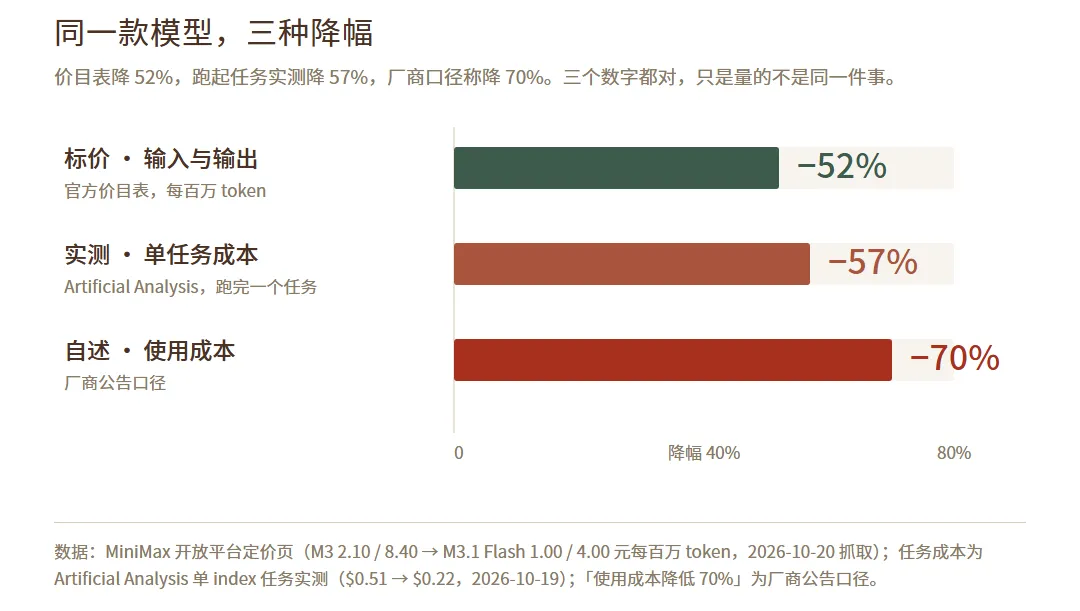
MiniMax 说,M3.1 Flash 的使用成本降了 70%。
同一天,第三方机构 Artificial Analysis 实测:跑完一个标准任务,花费从 0.51 美元降到 0.22 美元,降了 57%。
两个数都没错,它们量的是两件事:
厂商算的是「每百万 token 多少钱」,这是单价。
第三方算的是「把这件事办完一共多少钱」,这是总价。
注意一个细节:价目表降 52%,任务成本降 57%。总价比单价降得还多一点,因为新模型不光便宜,还更快、更省字。
那 70% 和 57% 差的这 13 个点,是怎么来的?厂商按最省钱的用法算,实测按真实用法算,中间差的就是来回。
办一件事不是一问一答。AI 要先想,再调工具,看结果,发现不对再改一遍。每多一轮,前面说过的内容都要重新发一次。第一轮 1 万字,第五轮可能就是 5 万字。
价目表其实早就写明了这一点。M3 那一代,一次读的内容超过 512k token,单价直接翻倍,2.10 元变 4.20 元。读得多,本来就贵。
举个例子。让 AI 改一份 50 页的合同:改第一版,它读一遍全文;改到第五版,前四版的内容还都在里面,每一版都得连着读一遍。价格降一半,读的量翻了几倍,账就下不来。
一句话:价目表上写的是单价,账单算的是总价。中间隔着你让 AI 干了多少活。
五、那企业的总支出为什么还是降了
因为跌得比涨得快。
先说得涨了多少。调用量涨得猛,是因为 AI 从「问答」变成了「干活」。办一件事要来回几十轮,每一轮都算一次请求。用的人多了,次数涨得更快。
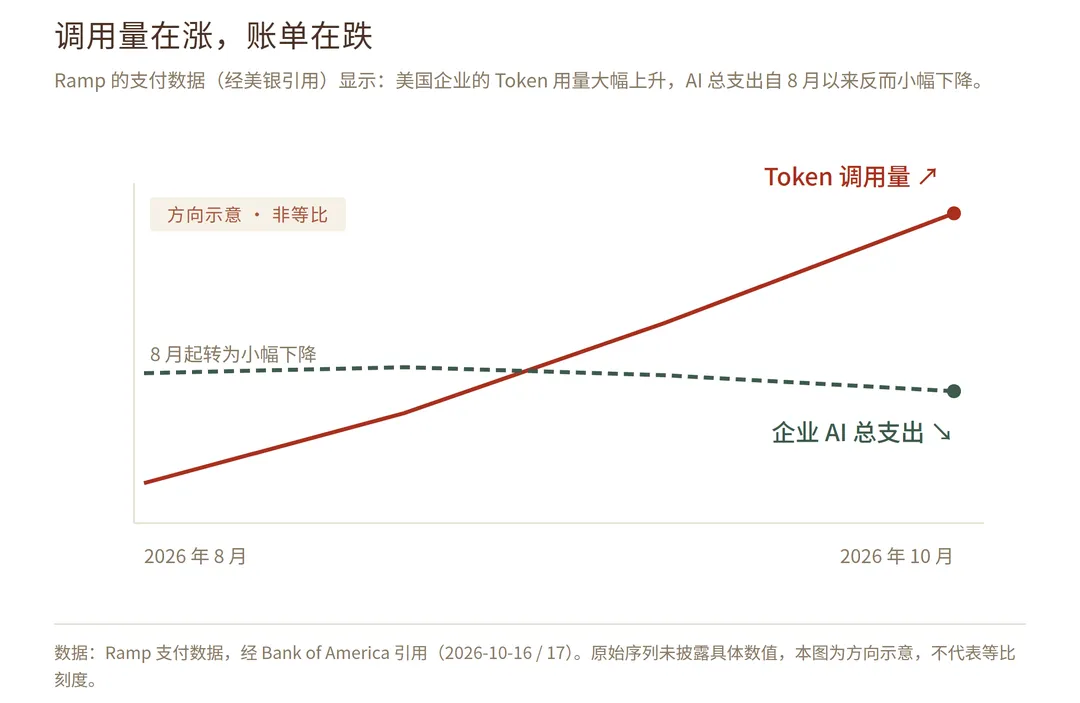
美国支付公司 Ramp 有一份企业消费数据,被美银引用:
企业调用 AI 的次数大涨,但 AI 总支出从 8 月开始小幅下降。
原因是单价跌了约 50%,跌的速度盖过了用量涨的速度。
除了降价,企业自己也做了三件事,都很朴素:
模型选定了就不再换,省掉反复测试的钱。
常用的长文档存进缓存,重复读只收一折,甚至更低。
按活挑模型,写文案用便宜那档,跑代码用贵那档。
对企业来说,现在是过去几年里 AI 最便宜的时候。同一笔预算,能干的事比半年前多得多。
顺带一提:同一款模型,价格可能差十倍。Kimi K3 官方价是 20 元每百万 token,第三方托管商报 0.24 美元,约合 1.6 元。开源模型谁都能托管,谁都能自己定价。
如果你只是拿 AI 聊天,这轮降价对你影响不大。真正吃 token 的是干活:读一份长合同、合并一堆表格、跑一遍代码再改 bug。这类活的账单,是聊天的几十倍。
比价之前,先看清你比的是谁家的价。
点动科技做的是算力运营与 Token 平台:自有算力集群提供推理能力,CCRMS 负责纳管、调度、计费与审计。
TArk 元舟在同一个体系里承担模型入口——上百款模型一个 API 接入,统一账户与用量,调用、监控、计费在一处完成。
放回上面这笔账里,能帮上的就是三件事:用量看得见,成本能按任务算清楚,通道出问题时毫秒级切到备用。降价能不能落到你账上,差的就是这几处。
让算力像水电一样随取随用。
元舟邀请码:CDTDMWOXH3
注册元舟,即刻领取10元额度!
向上滑动阅览数据
1. Anthropic 官方定价页 claude.com/pricing(API 标签页):Opus 5.5 与 Opus 5 价格、缓存读取价,2026-10-18 更新,2026-10-20 抓取
2. Opus 5.5 单请求上下文量为半年前 2.6 倍:Anthropic 发布材料,2026-10-18
3. MiniMax 开放平台「定价概览 · 语言模型」:M3.1 Flash 与 M3 价格,platform.minimax.cn,2026-10-20 抓取
4. Artificial Analysis 单任务成本($0.51 → $0.22)与 93% 幻觉率测量,2026-10-19
5. Ramp 企业支付数据(调用量与企业 AI 支出方向),经 Bank of America 策略客户报告引用,2026-10-16
6. Bank of America 策略客户报告(Sebastian Raedler):Token 均价入夏以来下跌约 50%,2026-10-16
7. Kimi 开放平台第一方价,platform.kimi.com,2026-10-20 抓取;第三方托管价经 OpenRouter 定价追踪,2026-10-19
8. 人民币对美元中间价 6.7208:中国外汇交易中心,2026-10-19
说明:文中美元与人民币换算按 6.7208 折算;厂商自述口径与第三方测量已分别标注;