ARTICLE · 1226900
把OCR模型塞进HTML里:扫描版PDF转Word,免安装、不联网,告别付费!
这次更新只做一件事:把"扫描件转 Word"这件事,完整地搬到本地来跑。
它到底是怎么做到的
一句话:把 OCR 引擎和识别模型,一起塞进了一个 HTML 文件里。
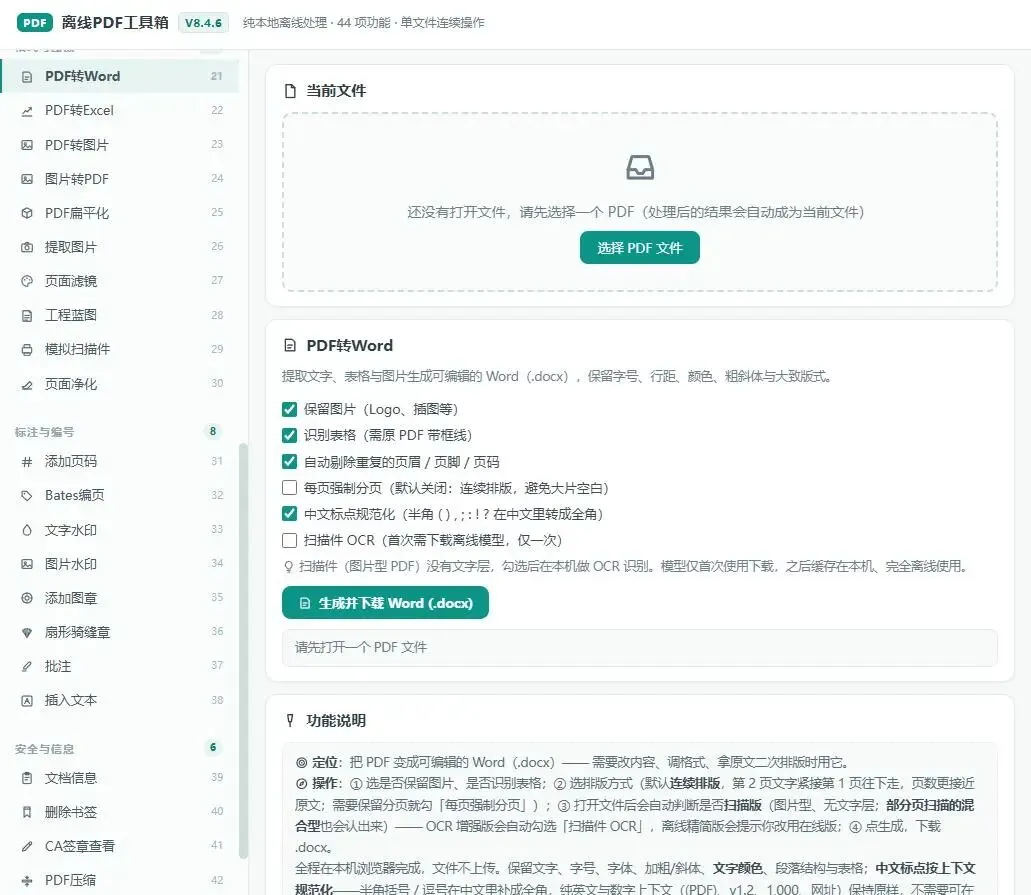
你拿到的是 OCR离线版.html,双击打开,选「PDF转Word」,勾上 OCR,点生成——几秒到几十秒后,得到一份可编辑的 .docx。
整个过程:
不联网:模型、引擎、PDF 解析库全部内联在那个文件里。你可以先拔网线再打开; 不上传:文件从头到尾没有离开你的电脑,没有服务器,没有接口; 不装东西:没有客户端、没有插件、没有运行库,不需要管理员权限,不写注册表; 不留痕:关掉页面,内存里的东西就没了。
U 盘拷过去能用,内网共享盘拷过去能用,隔离网里的机器照样能用。
为什么我坚持做"离线"
不是技术洁癖,是三个很现实的原因。
第一,隐私。带红章的通知、审批表、合同、名单,这些东西上传到任何一个第三方服务器,都是一次无法撤回的信任支出。离线跑,就根本不存在这个问题。
第二,内网。很多单位的办公机没有外网,或者不允许访问外部服务。在线工具再好,在那里也是零。
第三,可持续。在线服务会涨价、会关停、会改规则。一个能双击打开的文件,三年后还能打开。
扫描件千奇百怪,这才是真正的难点
把 OCR 引擎跑起来不难,难的是扫歪的、盖了章的、横过来拍的这些真实文件。
这次花了最多时间的,就是解决这些事。
目前转换的效果已经非常好!
但是我们下一步的目标是将转换的效果做到极致!
不说1:1还原,至少也要超过99%的相似!
能力边界,我也说清楚
它不是万能的,避免你白折腾:
能转:印刷体、扫描件、照片(清晰度别太差)、公文、合同、通知、表格清单; 有限:手写体、艺术字、极度模糊或有严重污损的扫描件,识别率会明显下降; 不行:复杂公式、化学结构式、彩色图文混排的杂志版式,转出来只能算"能用",不是"完美还原"。
另外,离线版的 OCR 只带中文、英文模型(含常用符号与数字)。
怎么用(三步)
下载 OCR离线版.html(一个文件,约 9 MB);双击打开,选「PDF转Word」,扫描版pdf会自动识别勾上「扫描件 OCR」; 点生成,等进度跑完,保存 .docx。
最后
我知道很多人对"免费工具"是有戒心的——怕广告、怕捆绑、怕偷偷上传。
这个工具的做法很笨:一个文件,全部内置,不联网也能跑。你可以断网验证,也可以直接看它有没有发请求。
为了实现这个效果,经过长时间的打磨,尝试了无数的方法,最终将模型的体积优化到了极致!一个不带OCR的PDF工具箱3MB,一个内置OCR模型的PDF工具箱体积仅9MB,浏览器运行也可以酣畅淋漓!
不过需要提醒大家一下的是,
目前离线OCR单文件版本尚未上线提供下载,因为还有一些细节需要优化!
预计于10月底之前上线!
不过,目前线上版本已经发布,可以到线上体验并反馈使用意见!OCR离线版上线了第一时间发文告诉大家。