ARTICLE · 1226895
不用一行源码,它把别人家软件的底裤扒给你看 · REA * EdgeRock-4B
开源大猩探 · GITHUB Vol.125
不用一行源码,它把别人家软件的底裤扒给你看
2026-10-21 · REA × EdgeRock-4B
你有没有过这种时刻:用别人家App的时候,某个功能顺滑得离谱,你心里痒痒——这玩意儿到底怎么实现的?
想知道答案,传统路子就两条。要么啃开源(前提是人家开源了),要么找逆向工程师。后者什么行情?按天计费,一天四位数起步,还未必排得上号。至于自己学?打开Ghidra的那一刻,百分之九十的人就被满屏的汇编劝退了。
我身边就有现成的例子。一个朋友做笔记软件,眼红某头部产品的剪贴板富文本处理能力,想搞明白原理。问了一圈,要么是“这得逆向,我不会”,要么是“能弄,工期两周起”。最后他花三个周末啃文档加瞎猜,勉强抄了个七成像。
但GitHub上有个项目,悄悄攒下了约34.9万颗星——README里挂着“30万星感谢有你”的里程碑横幅,Trendshift日榜稳居前列。它干的事一句话能讲完:让你直接用大白话,指挥AI Agent把任何软件拆开看。
它叫 REA(Reverse Engineer Anything),今天的主推。
先声明:这不是什么“AI代替逆向工程师”的爽文。它真正的价值,是把逆向这件事从“专家专属”拉到了“高级工程师踮踮脚够得着”的位置。就像当年Copilot没替代程序员,但让写CRUD的人快了一倍。
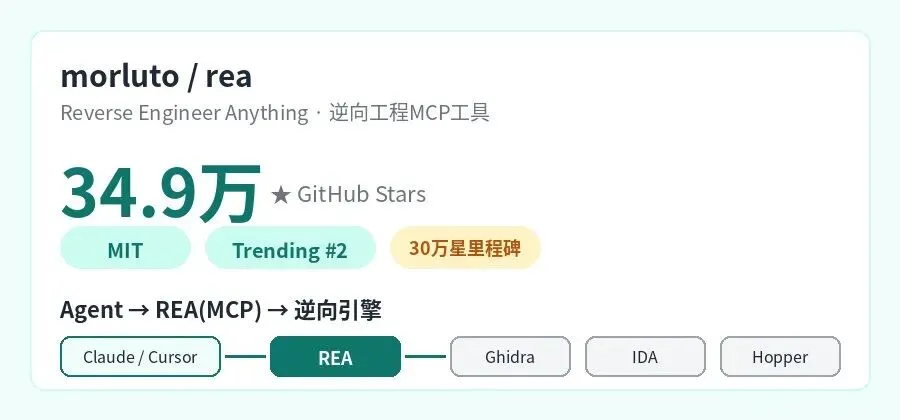
主推:morluto/rea —— 把逆向工程变成“说人话”
先泼一盆行业冷水
逆向工程这个行当,几十年来都是“老师傅手艺活”。工具不是没有:IDA Pro,商业授权一年几千美元;Hopper,便宜点也要掏钱;Ghidra免费,但那是NSA(美国国家安全局)放出来的家伙事儿,界面友好度约等于开飞机。
工具之外更难的是人。看得懂汇编、理得清调用链、猜得出编译器优化手法——这套本事没有三五年下不来。所以绝大多数开发者遇到“想知道它怎么做的”这种问题时,真实选择是:算了。
REA的打法很鸡贼:它自己不做逆向,它是一个MCP服务器,把你的AI Agent(Claude Code、Cursor、Codex、Gemini CLI这些)接到现成的逆向工具链上。MCP你可以理解成AI界的USB接口——插上去,Agent就多了几十种“拆装工具”可以调用。Agent负责动脑子串逻辑,Hopper/Ghidra/IDA负责干反编译的粗活,你负责用大白话提问。
以前是你学工具。现在是工具伺候你。
再算笔账,这就是开源对闭源最经典的一刀:
注意最后一行。做逆向的都知道,把目标软件上传到第三方在线服务是行业大忌。REA从头到尾本地跑,这一条直接命中要害。
它到底能拆什么
我翻完README列的支持清单,说实话有点吓人,这是一张“万物皆可拆”的表:
还有WASM、EVM字节码、网络抓包、甚至DOS时代的16位程序(Ghidra后端)。注意第二行:拆Electron应用(也就是市面上一大半桌面软件)不需要任何逆向引擎,纯静态分析就能跑。
三分钟上手(命令保真,来自README)
装好Node.js(22.x / 24.x / 26+)和npm,一行:
npx rea-agents setup它会列出你机器上装了的Agent,让你勾选、确认改动(还带配置备份),重启Agent完事。然后你就可以直接对它说人话:
搞清楚记事本App的搜索是怎么实现的,给我看证据,然后给我的项目写一个类似的。不想开Agent?终端里也能直接干活,比如拆一个解压出来的Electron应用目录:
npx -y rea-agents@latest analyze-javascript-application /absolute/path/to/app --json所有分析全部在本地跑,目标软件不会被上传。你的Agent拿到工具结果后,数据政策归模型厂商管——这句是README原话,挺实诚。
光说不练?人家有三个完整案例
DX-Ball音效还原:跟着一个声音调用钻进它的声像计算函数,看不完整的伪代码,重写成C语言——重构结果通过了3205个原始x86测试用例,63个编译函数字节级完全复现。
Notion剪贴板追踪:从渲染进程的剪贴板API一路追到preload、IPC、主进程,把富文本剪贴板格式摸了个底掉。以后想做类似功能,照抄思路就行。
东方Project TH04:把PC-98平台这个上世纪90年代的DOS游戏16位指令拆开,还原出弹幕环形扩散的角度计算公式。
从90年代的游戏到当下的Electron应用,通吃。
谁最该试试
我的判断是三类人:一是做二次开发的,遇到闭源依赖的黑盒行为,现在能问个明白;二是做安全研究的,审计一个Electron应用的IPC边界从几天缩到几小时;三是想学逆向的新人,跟着Agent的调查过程走一遍,比啃三个月教程入门快得多——它拆给你看的过程,本身就是最好的教材。
再泼一盆冷水(这是规矩)
- 深度二进制分析仍然要装引擎
:Ghidra免费但配置麻烦;Hopper和IDA是商业软件,REA的README明确写了——你必须合法持有这些工具的授权,破解版不支持。这条红线人家划得很清楚。 - 它降低的是“启动门槛”,不是“天花板”
:Agent给你的解释带证据、也带局限说明,但最终判断还得你来做。别指望它替一个真逆向工程师出庭作证。 - Node.js版本卡得比较死
(22.19+ / 24.11+ / 26+),老环境先升级。 - 34.9万星不代表零学习成本
:你得先有个顺手的Agent,MCP是什么最好也大概知道。纯小白建议从拆Electron应用入门,那条路最平。 逆向有法律边界,项目DISCLAIMER写得明白:只用于合法研究、互操作和你有权分析的软件。拆自己买的东西,行;拆来破解别人的东西,不行。
副推:rockmatrix-ai/EdgeRock —— 推理再长,内存不涨
第二个项目画风突变,但来头不小。
10月19日,岩山科技旗下岩芯矩阵联合港科大、CMU开源了 EdgeRock-4B,量子位当天出了深度报道,证券时报、新浪财经跟进,排面不小。它解决的问题一句话:大模型推理越长,KV Cache越吃显存,这个行业老大难,它直接给釜底抽薪了。
传统模型每生成一个token就往显存里多存一份历史,这份历史叫KV Cache。今年Agent火成这样,问题被放大到了极致:一个Agent任务跑几十轮工具调用,上下文滚到十几万token稀松平常,显存先扛不住,一张卡能同时伺候的请求数咔咔往下掉。推理服务老板看着GPU账单,心都在滴血。
推理到256K上下文,一条序列光KV Cache就要8GB——一张80GB的卡同时服务几十个请求就到头了。
业界之前的解法分两派,但都不治本。一派给每个token“瘦身”:MLA压缩、KIVI量化、谷歌TurboQuant,单token成本降了,缓存照样随长度涨。另一派是有界状态模型(RWKV、Mamba这些),内存天生固定,代价是远处的关键细节留不住,推理能力大打折扣——16个参评的有界状态模型里,就算做到14B参数,AIME均分最高也只有18.8%。
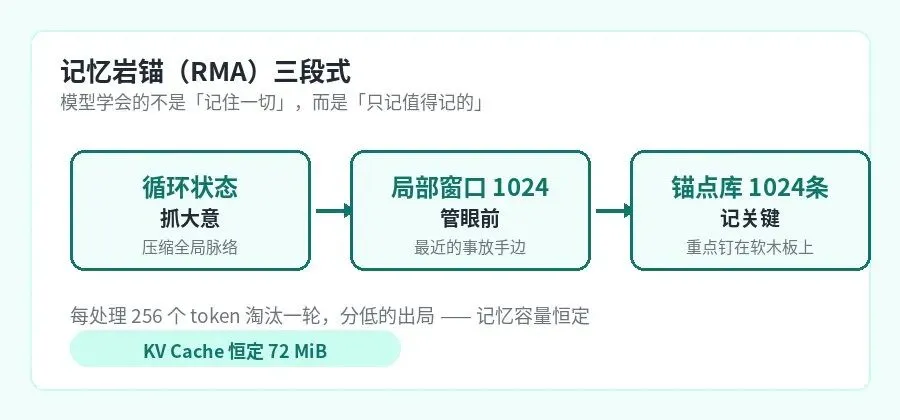
EdgeRock-4B的路子是给记忆打“岩锚”(Rock Memory Anchors):循环状态抓大意、1024token局部窗口管眼前、锚点库只留最值得记住的1024条记录——每处理256个token淘汰一轮,分低的出局。说白了就是,模型学会的不是“记住一切”,而是“只记值得记的”。
结果就是——每条序列的注意力KV恒定在72MiB,比源模型Qwen3.5-4B砍掉99.1%,上下文从4K涨到256K,内存占用一丝不动。
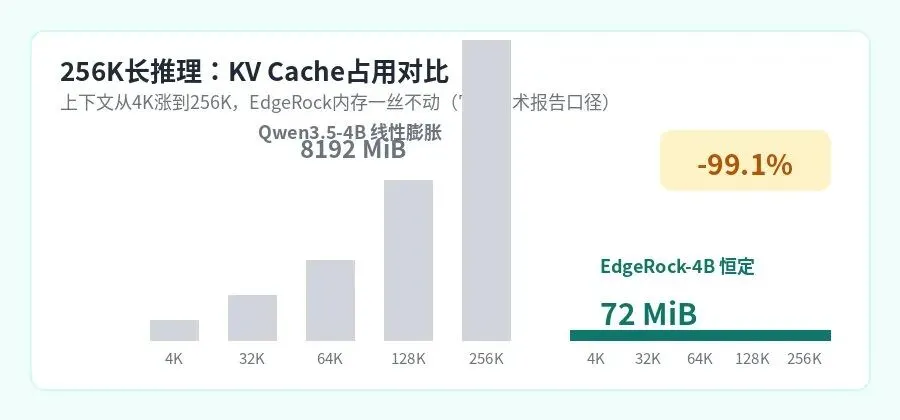
数字党直接看这组(官方技术报告口径):
| 72 MiB | ||
| 12,124 tok/s(512并发) | ||
| 512路 |
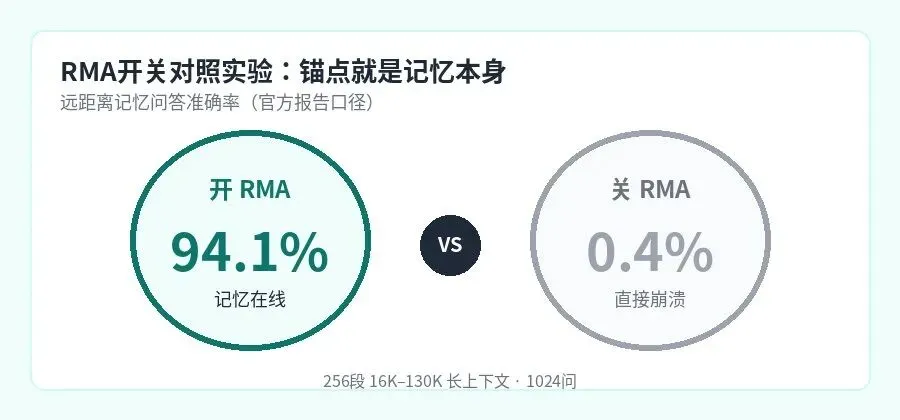
能力保留96.3%,吞吐干到6.42倍。更狠的是一个对照实验:把8个RMA模块全关掉,远距离记忆问答准确率从94.1%直接崩到0.4%——证明撑起长程推理的真是这套锚点,不是玄学。
打个比方你就懂了。传统模型像个强迫症秘书,领导说过的每句话都一字不落记在越来越厚的本子上,开会时间越长本子越沉,翻得还越慢。EdgeRock换了个聪明秘书:重点钉在软木板上(锚点),最近的事放手边(局部窗口),大方向记脑子里(循环状态)。会开三天三夜,桌子还是那么点地方。
这套东西对端侧的意义尤其大。机器人、车机、手机上的模型,内存本来就要跟感知、控制模块抢饭吃,KV Cache无限膨胀等于端侧部署判死刑。现在内存占用在设计时就定死了,工程上第一次可以“算得清账”。
跑起来也不复杂(README原命令):
git clone https://github.com/rockmatrix-ai/EdgeRock.gitcd EdgeRockpython -m venv .venv && source .venv/bin/activatepython -m pip install ./wheels/transformers-5.7.0.dev0-py3-none-any.whl -e .hf download rockmatrix-ai/EdgeRock --local-dir checkpoints/EdgeRock-4Bpython run.py demo --model checkpoints/EdgeRock-4B \ --prompt 'Solve 17 × 23, explaining your reasoning.'泼冷水时间:仓库目前560星,刚开源两天,社区检验几乎为零;“512路并发”是在Hopper 80GB专业卡上测的,你我的消费级显卡看看就好;GGUF版本需要定制的RMA后端,不能直接用llama.cpp和Ollama跑;MLX版本官方明说“Apple Metal未测试”;它是基于Qwen3.5-4B改造的,智力上限被底座框死。协议Apache-2.0可商用,这点干净。
另外它的模型家族铺得很全:NF4、INT8、FP8、AWQ、GPTQ量化包一应俱全,还有手机端的LiteRT预览版——虽然官方老老实实标注了“Android真机验证进行中”。这种“先开源再补作业”的姿态,比PPT发布顺眼多了。
但对做Agent、做长文档分析、被显存卡脖子卡得嗷嗷叫的团队,这个方向值得盯紧。毕竟“内存不随推理长度涨”这件事,以前是物理定律级别的约束,现在有人把它拆了。
写在最后
今天这两个项目,一个帮你看懂别人的软件,一个帮你跑得起自己的模型。一个34.9万人已经用脚投过票,一个刚落地两天热乎着。它们指向的其实是同一件事:开源社区正把过去只有大厂和专家玩得起的能力,一件一件搬到普通人桌面上。五年前逆向是玄学,三年前大模型推理是有钱人的游戏,现在一个npx、一个git clone,都在你手里。
你更想拆哪个软件的底?评论区聊聊,指不定下期就拿它开刀。
数据来源声明
1. REA星数(约34.9万)来自shields.io对GitHub API的实时读取(2026-10-21),“30万星里程碑”见其README;quick-start命令、支持清单、showcase案例均摘自官方README及rea.tools。
2. EdgeRock-4B星数(560)来自GitHub API(2026-10-21);82.9% AIME、72MiB恒定KV、6.42倍吞吐、94.1%/0.4%对照实验均为官方技术报告及README口径,未经第三方独立复测。
说明:本文星数与动态数据采集于2026-10-21,开源项目情况随时变化,请以官方仓库最新信息为准。逆向工程请遵守法律法规与目标软件许可协议,仅用于合法研究与你拥有权利的软件。