ARTICLE · 1234041
不再为PDF转文字付费了,这个工具免费并且速度快
GitHub 上名为 Indra 的项目已经有 914 个星了。官方给出的数据很刺眼:32 核 CPU 每秒可以处理 44 页,是 Tesseract 的 15 倍。第一眼看到的时候,我的想法就是:又是一个只会跑分的玩具吧?
但是它不需要显卡,不需要会员,甚至连模型也只有76MB。也就是说,它所要抢夺的就是按月收费的OCR服务。随之而来的问题就是:一个免费的工具,真的可以代替你手中的付费方案吗?
先算一笔账:你一直在为“识字”交月租
Datalab托管服务把PDF转Markdown按页收费,轻量版每1000页0.5美元,快速版4美元,高精度版10美元。虽然不贵,但是按照快速版到高精度版来计算的话,一本300页的老书就要1.2到3美元,积少成多。
Indra 把同样的基础能力搬到你的电脑上。代码开源,模型权重对个人、研究以及年营收或融资低于 2000 万美元的初创公司免费。对于普通用户以及小团队而言,软件的成本就是 0 元,所花费的只是电脑本来就要消耗的电力。
公司规模大、又要商用,那就得看授权条款,这事儿不能装看不见。要是你只是偶尔转几份合同、论文、发票,会员真不用急着开。
它可以做什么事情,不要被“100万参数”所吓到
100万参数在现在的AI圈子里已经很小了,好处就是轻。不需要PyTorch,也不需要GPU,普通的笔记本就可以运行。
据其介绍,它可以处理80多种语言,包括中文、日文、韩文、阿拉伯文;可以识别横排、竖排、倾斜甚至倒过来的页面;可以把标题、正文、列表、表格、脚注按照阅读顺序排列好,然后输出Markdown。
手写体可以识别,但是不要抱有太高期望,官方标准只有25.2%。合并单元格的表格以及模糊的老扫描件都是问题所在。这并不是在贬低,而是提前知道边界,就不会白费力气了。
怎么开始:一条命令就可以让它运行起来了
它不是双击就可以安装的软件,需要敲几条命令。坦白说,这一步会劝退一部分人,但是按照去做并不难。
安装好 Python 3.10 或更高版本之后,在终端中输入 pip install indra-ocr。 第一次运行的时候会自动下载大约 76MB 的模型,等上几分钟之后就会被缓存起来。 输入 indra-ocr 你的文件.pdf,Markdown 会直接显示;想要保存为文件的话,在后面加上 --out results/。 想要先看看效果的话,可以运行 indra-ocr-viewer,打开浏览器后在 http://localhost:8765[1] 上把 PDF 文件拖进去。文件一直都在本地。
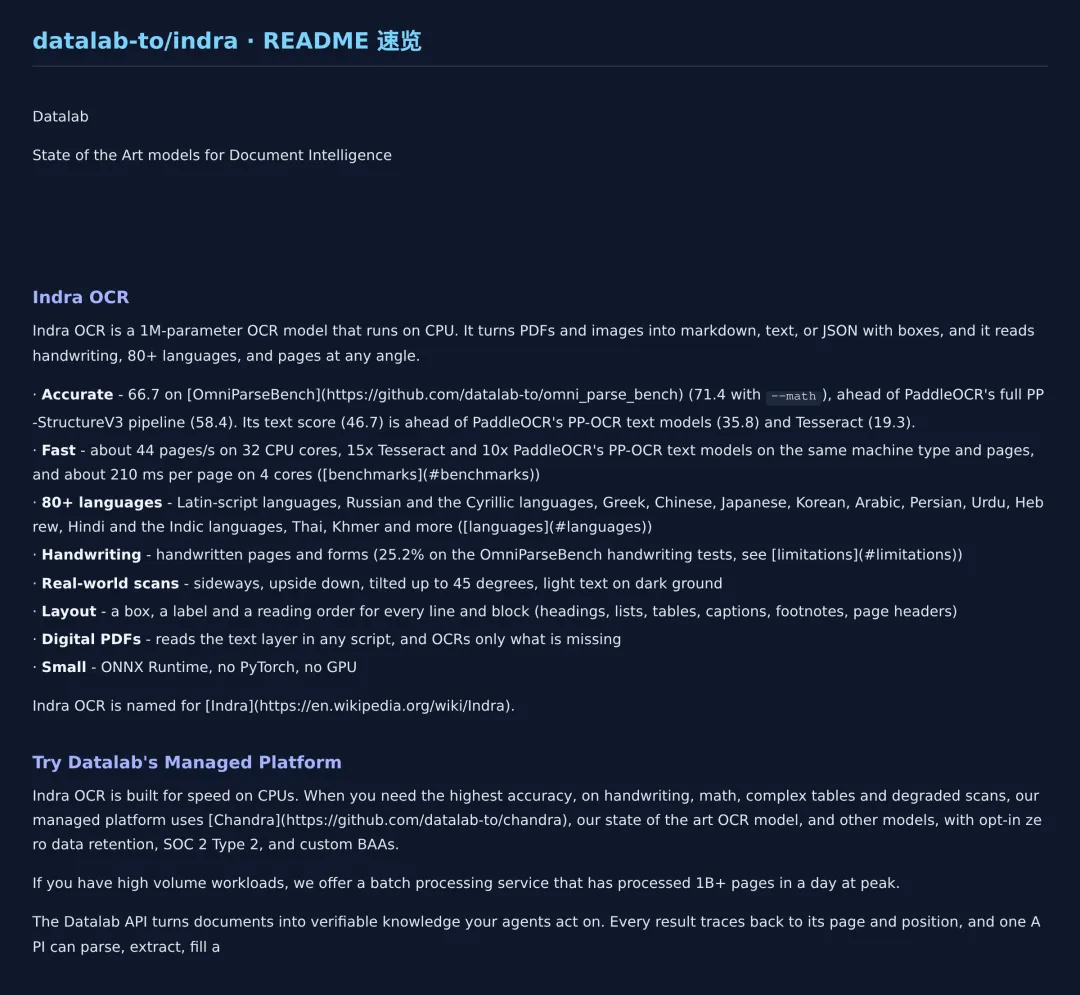
入口为GitHub:github.com/datalab-to/indra。不会敲命令的话,找一个懂电脑的朋友,十分钟之内就可以解决。
它是怎样工作的:四条流水线
把一页纸看作一条流水线,四个人分别负责其中的一段。
第一个工人用荧光笔把每行文字都圈起来,并且把歪页、倒页也整理好了。第二个工人负责认字,用CTC的方式进行对齐,像小孩子描红一样,看一个字对应一行;对于拿不准的行,会叫上另外几个专门研究中日韩、阿拉伯文、印度语系的同事一起查看,谁有把握听谁的。第三个工人负责“排版”,把散乱的纸条按照标题、正文、表格、脚注的顺序排列好。最后一个工人把东西装订成Markdown格式,可以直接粘到笔记软件里。
最难的是第三步。字认得再清楚,顺序不对,整句话照样读不出来。Indra 的卖点,就是把“认字”和“读懂版面”放在同一条流水线上。
真实的场景是:60页的合同,从3个小时变成了一杯茶
以一份60页的扫描合同为例,要整理成可以被搜索的文档。
以前的方法是逐页截屏、上传到识别软件、复制文字、手动删除页眉页脚、然后把段落拼接起来。顺利的话两三个小时,不顺利的话就要到半夜了。
把 PDF 交给 Indra,根据公开的数据,4 核的机器一页大约需要 210 毫秒,60 页十几秒就可以得到初稿了。输出自带标题层次,页眉页脚默认会去掉。剩下的工作就是核对数字、人名了。
钱也省得明白:同样的活走付费接口,快速版约 0.24 美元,高精度版约 0.6 美元;本地跑是 0 美元。以前整理访谈扫描件的时候,最怕的就是双栏排版被误读为上下颠倒,这样的工具可以把阅读顺序调整过来,可以节省一大半返工的工作量。
这三种情况不适用
第一种是表格中有很多合并单元格、跨页断行;第二种是手写的潦草或者铅笔字;第三种是发黄、模糊的老档案。这三种情况都会出现翻车的情况,官方自己也承认。
真的要高精度的话,还要考虑到 Datalab 的付费服务,新用户的体验额度是 5 美元,个人邮箱的免费额度是每月 10 美元,工作邮箱是 20 美元。每月 10 美元可以转 2500 页,偶尔用一下就可以了。注意,免费额度当月用不完就会被清零,不能为了“先用着”而一次性购买 400 美元一个月的团队版。
另外还有一个坑:用它和 Datalab 的接口抢生意,但是授权不允许。普通的办公、学习、做自己的小产品是没有问题的。
工具本身不贵,贵的是你把时间全耗在重复活儿上。要是这办法能帮你省下一笔订阅费,点个赞;也转给那位天天帮公司转 PDF 的同事。你们一个月花在 OCR 工具上的钱是多少?评论区聊聊。
引用链接
[1]http://localhost:8765