ARTICLE · 1237387
博客跌到 9.3%,文档页涨到 33.5%:AI 引用的不是内容,是证据
博客跌到 9.3%,文档页涨到 33.5%:AI 引用的不是内容,是证据10 月 21 日,AI 可见度平台 SEMAI 发布了《AI Search 2026 Report》,样本是它自己追踪的 25 万条以上 URL,覆盖 ChatGPT、Gemini、Perplexity 和 Google AI Overviews 四个引擎。报告里最扎眼的是一组对比数字: 在 ChatGPT 5.6 Luna 记录到的引用链接中,文档页与支持页占 33.5%,而文章、指南类只占 9.3%。同一套提问、同一套测量方法,他们在今年 2 月也跑过一次——那时候文章与指南占 41.2%,文档与支持页只有 1.4%。 不到八个月,两个数字几乎对调。 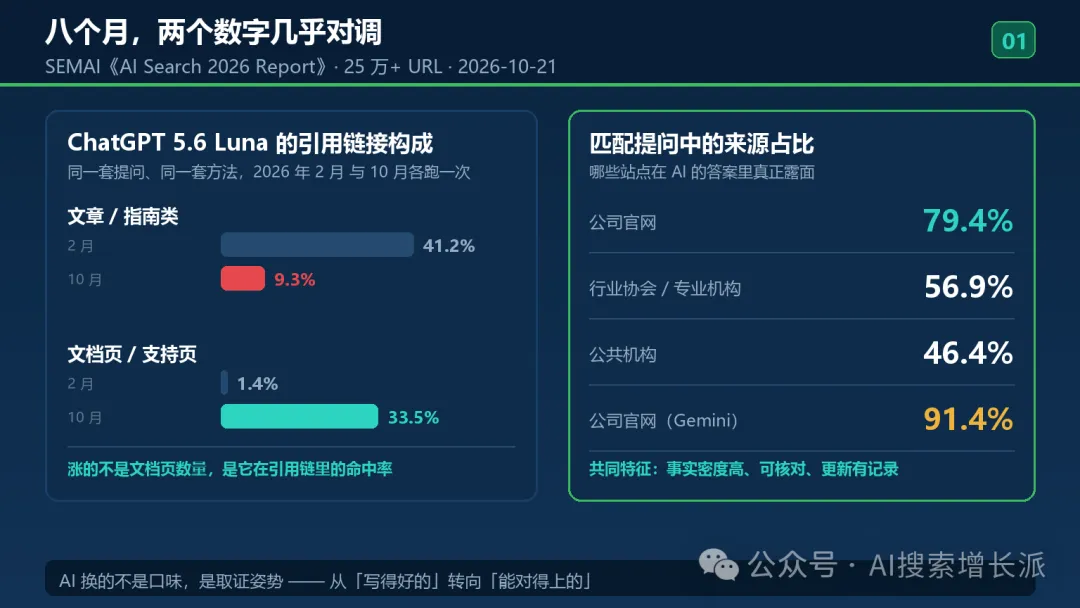
同一份报告还给了一组数字:公司官网出现在 Luna 79.4% 的匹配提问里,Gemini 上达 91.4%;行业协会与专业机构 56.9%;公共机构 46.4%。 我给个判断:不是 AI 的口味变了,是它的取证姿势变了。它不再挑"写得好的",在挑"能对得上的"。你的内容策略如果还停留在"多写几篇行业洞察",8 个月前可能有效,现在大概率无效。 过去两年,我们给品牌做 AI 可见度诊断,最常被问的问题是"我们的文章够不够多"。从这份报告开始,这个问题要换成另外一句:你的那些事实,能不能被 AI 一段一段地摘走,并且摘走之后还能对上号?
先把"文档页"这个词说清楚,否则很容易误读。 这里说的文档页,不是内部手册,而是那些结构稳定、边界清晰、一句话就能定位到一个事实的页面:产品规格表、参数对照页、价格与计费说明、兼容性清单、服务等级承诺、常见问题、更新日志、接口文档。 它们和一篇 3000 字行业文章的区别在哪? 一篇文章的价值在于"论述",它把事实串成观点,读者需要读完才能拿到结论。而文档页的价值在于"取证",一个页面里可能有二三十个彼此独立、各自成立的硬事实,任何一个都可以被单独摘出来,单独核对,单独引用。 AI 写答案的动作,本质上不是"阅读",是"取证"。它拿到一个提问,拆成若干子查询,去检索,然后从检索结果里挑出能支撑句子的事实块,拼成答案,最后给每个事实块挂一条来源。 在这个动作里,观点文章的处境非常尴尬:它的核心资产(观点)恰恰最难被单独摘走,因为观点脱离论证链就站不住;能被摘走的只是零散事实碎片,散落在三千字里,密度低、定位难,还常和营销话术混在一起。 文档页正好相反。它的每一个字段都是可摘的、可对账的、可追溯到一行表格的。 所以 SEMAI 那个数字并不神秘:当模型换了一代,检索与引用策略也随之调整,"好摘的事实"权重上升,"需要理解的观点"权重下降。从 1.4% 到 33.5%,涨的不是文档页的数量,是文档页在引用链里的命中率。 补一个交叉印证:行业协会与专业机构出现在 56.9% 的匹配提问、公共机构 46.4%,两类站点同样"事实密度高、可核对、更新有记录"。这不是 ChatGPT 的孤例,是整条引用链在向可核对迁移。
如果说第一节讲的是"哪种页面容易被摘",这一节讲的是更残酷的一层:摘走了,也不一定会写进答案。 一篇针对中文生成式搜索的研究,把这件事量化了。研究者 Tao Zhen、Yue Liu、Gege Zhang、Yixuan Niu 等人在 DeepSeek、Qwen、豆包、腾讯元宝四个中文 AI 助手的网页版与 App 上,各跑 614 个问题、每个问题重复三次,清洗后得到160,860 条引用做审计。结论有四条,每一条都值得品牌方贴在墙上: 第一,39.3% 的展示链接从未被真正引用。屏幕上摆着的十几条来源,接近四条实际上没有在任何一句话里被用到——它们是"搜索残留"。也就是说,被列出来不等于被读到,更不等于被采信。 第二,被引用页面里出现的 632,256 个品牌名称,只有 8.3% 最终出现在 AI 的回答里。注意这个分母:不是全网,而是"已经被 AI 检索到、已经摆在引用列表里"的页面。即便到了这一步,91.7% 的品牌名依然在生成阶段被丢弃了。 第三,13.02% 的答案里出现的品牌名,在它引用的页面里根本找不到。研究者称其为"幽灵提及",而当提问表述含糊时,这个比例升到 27.5%——模型动用了预训练记忆,而不是实时检索结果。 第四,Qwen 的 App 与网页版,同一问题的返回链接只有 1.4% 重合,DeepSeek 相对一致也只有 40.8%。手机测出来的可见度,和电脑上测的可能是两回事。 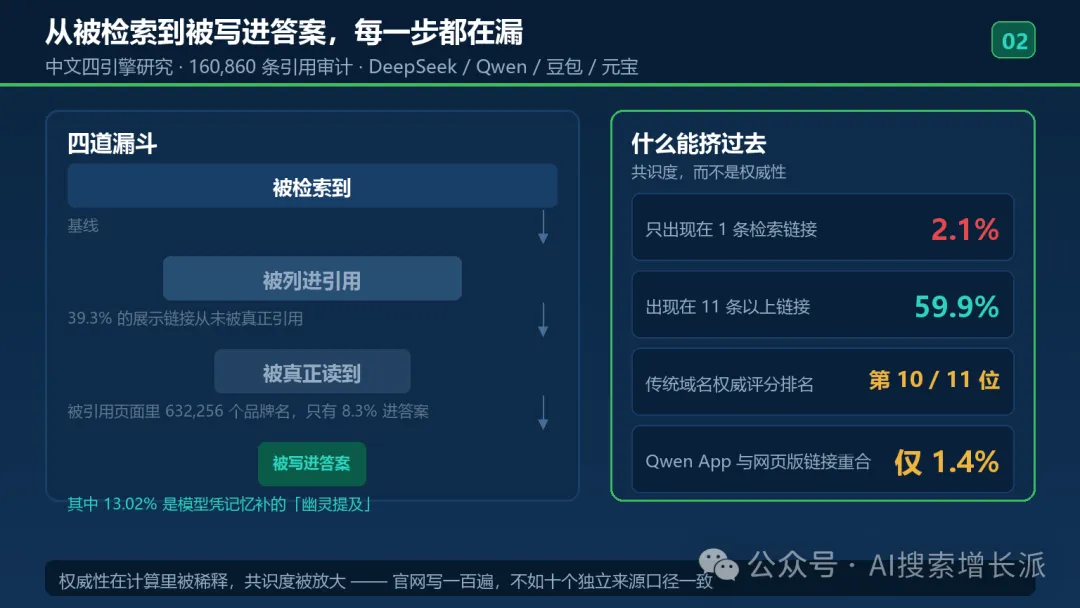
四条串起来是一个漏斗:被检索 → 被列进引用 → 被真正读到 → 被写进答案,每一步都在漏。39.3% 的链接白摆着,91.7% 的品牌名在最后一步被扔掉;剩下进答案的里头,还有一成三是模型"凭记忆补的",跟你怎么优化毫无关系。 这意味着,用"我们在 AI 答案里被提到了"当汇报口径是有系统性偏差的。你观测到的那点提及,多少来自真实引用、多少来自模型记忆惯性,绝大部分团队根本没拆开过。
既然答案层这么挑剔,那什么东西能挤过去?同一份中文研究给了最有力的一组数字: 一个品牌名,如果只出现在 1 条检索链接里,它进入回答的概率是 2.1%;如果出现在 11 条或更多链接里,这个概率接近 59.9%。 而研究者测试的传统域名权威评分(综合收录页面数、站点权重、域名年龄),在 11 个影响因素里,只排第 10 位。 这两句话,基本推翻了过去二十年的 SEO 直觉。 SEO 时代的逻辑是"把主站做重":域名越老、权重越高、内容越多,排名越稳。但在生成式检索里,模型要的不是"一个特别强的来源",而是"多个来源说法一致"。原因很简单:模型在一次回答里要同时处理几十条检索结果,它判断一个事实是否可信,靠的不是某条来源的分量,而是这个事实在不同来源之间的重合度。 换句话说,权威性在计算里被稀释了,共识度被放大了。 这也解释了 SEMAI 报告里那个容易被忽略的细节:行业协会与专业机构出现在 56.9% 的匹配提问里。它们单个站点的流量可能很小,但它们的说法被大量站点复述,于是成了"共识节点"。 对品牌来说,这是一个很硬的结论:你的关键事实,在自己的官网上写一百遍,也不如它在十个互不相关的第三方页面上以一致的口径出现十次。前者是音量,后者是共识。模型只认后者。 必须提醒边界:共识不等于刷量。今年国内已出现多起 GEO 行政处罚,模式高度一致——批量编造虚假排名、虚构榜单与市占率、伪造第三方测评。复旦团队 10 月 8 日挂在 arXiv 的实验更极端:他们编造了一个叫"Cactus Gravity Protocol"的虚构概念,发在那些本就被高频引用的开放平台上,七天内 10 个 AI 搜索工具里有 8 个开始引用它。 这条链路可以被污染,正因可以被污染,它才正在被清算。共识度工程的前提,是你放出去的每一条事实都能被独立复核。不能复核的,不叫共识,叫风险敞口。
最后一个必须破除的幻觉,是"一次测评定生死"。 Pineprompt 在 2026 年 9 月 30 日至 10 月 13 日做了一次七引擎基准:200 条非品牌类购买意向提问,覆盖 10 个品类,每日定时跑,共收集 18,792 条回答。结论是: 8,269 个被提及的品牌里,只有 12.9% 被全部七个引擎同时点名;46.2% 只在一个引擎上出现过。Google AI Overview 与 ChatGPT 的提及品牌集合的 Jaccard 相似度只有 45.6%。 同时,同一提问在相邻两天的品牌集合变动,ChatGPT 是 36.0%,Perplexity 高达 68.8%,其余引擎落在 41%—56% 之间。 翻译成人话:你赢了 ChatGPT,不等于你赢了 Google;你今天赢了一次,不代表明天还在。 再叠加第二节里 Qwen App 与网页版只有 1.4% 重合那条——监测这件事,必须是"多引擎 × 多端 × 时间序列",缺一个维度,你看到的就是被裁剪过的现实。 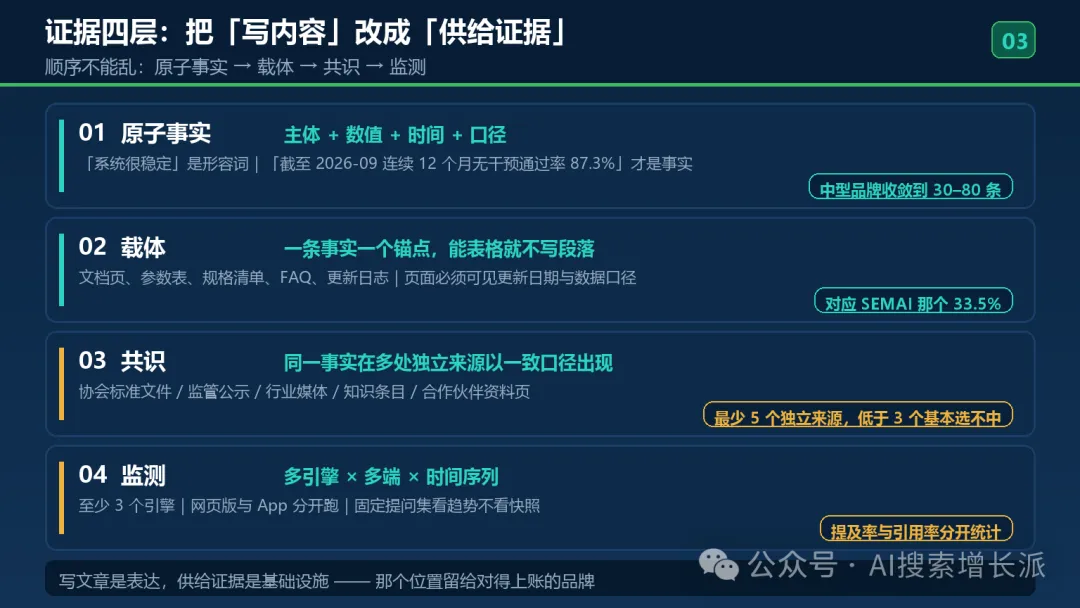
讲了四节问题,给一套可执行的框架。我们内部叫它证据四层,从上到下依次是原子层、载体层、共识层、监测层。顺序不能乱。 第一层:原子事实 把你的品牌主张拆成最小的、可独立成立的事实单元。一个合格的原子事实必须带齐四个要素:主体、数值、时间、口径。 "我们的系统很稳定"不是事实,是形容词。"截至 2026 年 9 月,某产线排产模块连续 12 个月无干预通过率 87.3%,统计口径为日计划首次下发至锁定版本"——这才是原子事实。 实操建议:中型品牌值得被 AI 引用的原子事实通常在 30—80 条。少于 30 条,可引用资产太薄;多于 80 条,说明没收敛,资源会被摊薄。 第二层:载体 给每一条原子事实找一处"可定位的家"。三条硬标准: 这一层直接对应 SEMAI 那个 33.5%。文档页不是让你把官网改成一个大手册,而是让你把已有的事实从散文里搬进结构里。 第三层:共识 让同一条原子事实,在多个互不相关的第三方页面上以一致的口径重复出现。 优先级从高到低:行业协会与专业团体的公开名录与标准文件、公共机构与监管公示、行业媒体与垂直媒体的事实性报道、百科与知识类条目、问答与专业社区中被引用的口径、合作伙伴与渠道商的公开资料页。 判断标准很朴素:一条事实最少要有 5 个独立来源口径一致,才谈得上有机会;低于 3 个,在检索层基本不会被选中。参照前面那条曲线,1 条来源是 2.1%,11 条来源是 59.9%,中间每一条来源的边际收益都不小。 做这层最容易犯的错,是把"发稿"当成"共识"。同一篇通稿投二十个站,来源数看着是二十,但文本高度同源,模型去重之后看到的可能仍是一两条。要的是口径一致的独立表述,不是同一段话的二十份拷贝。 第四层:监测 最后一层决定你能不能看见真实进展。四个动作缺一不可:
把今天这几组数字摆在一起看,指向的是同一件事: 文档页从 1.4% 涨到 33.5%,说明可摘取的结构在被奖励;91.7% 的品牌名在最后一步被丢弃,说明进了检索也不等于进了答案;1 条来源 2.1% 对 11 条来源 59.9%,说明共识度压过权威性;12.9% 的全引擎通吃率,说明没有哪个数字可以代表全局。 所以,2026 年剩下的这点时间,GEO 该做的不该是"再多写三十篇文章",而是三件事: 把事实从观点里剥离出来,把事实搬进可定位的结构里,让同一组事实在足够多的独立来源上以一致的口径活着。 写文章是表达,供给证据是基础设施。AI 答案里那个位置,从来不是给写得好的人留的,是给对得上账的人留的。
私信领取企业 AI 就绪度免费诊断 AI搜索增长派,一个相信"AI答案里应该有更多好品牌"的GEO服务商
一、换的不是口味,是取证姿势
二、8.3%:你的名字进了引用页,也未必进得了答案
三、1 条链接 2.1%,11 条链接 59.9%:赢的是共识度,不是权威性
四、12.9% 通吃、日变动最高 69%:单一快照是自欺
五、方法论:把"写内容"改成"供给证据"
一条事实一个锚点:页面内要有稳定的标题锚点或可直达的段落标识,别让模型在一整页里找一句话; 字段化优先:能用表格、参数表、规格清单表达的,不要写成自然段; 版本与日期可见:页面上必须能看到最后更新时间和数据口径,这是模型判断新鲜度的直接依据。
多引擎:至少同时覆盖三个以上主流引擎,别用单引擎数据下结论; 多端:网页版与 App 分开跑,尤其中文引擎,两端差异可能极大; 时间序列:固定提问集、固定频次,看趋势不看快照。日间波动 36%—69% 是常态,只看一天等于看噪声; 分开统计提及率与引用率:两者背离时,说明你有定位问题而不是触达问题——被点名但没被引用,通常就是载体层没做。