ARTICLE · 1240949
别再让 AI 甩你一大段文字了:这个开源 Skill,把回答直接变成一张能读的网页
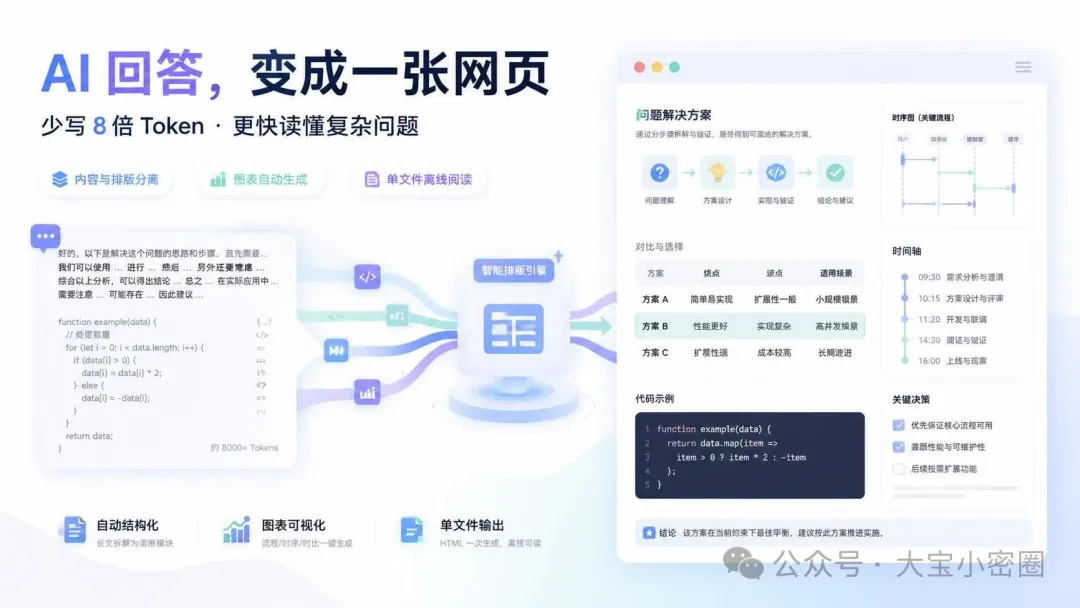
你有没有发现,AI 越强,你读它回答越累?一个稍微复杂点的问题,它甩给你几千字,术语一层套一层,读完还是没懂。有个开源 Skill 专门治这个:你照常提问,它把答案直接渲染成一张能读的网页——有流程图、有时序图、有对比表,单文件、可离线,模型要写的 token 还只有原来的 1/8。
先说一个反常识的事实:AI 回答不好读,很多时候不是因为内容差,而是因为"形态不对"。
你问"TCP 三次握手是怎么建立的",它给你 2000 字。 里面有 SYN、ACK、seq、状态机……每个词都认识,连起来就是进不了脑子。
但你换一种形态:一张时序图 + 一张状态图 + 一张标志位表。 同样的内容,三十秒就看明白了。
Andrej Karpathy 也说过类似的话: 当 LLM 承担越来越多的工作,"跟得上它的输出"本身成了难点。 一张图、一个网页,远比一大段文字更容易吸收。
问题在于:直接让 AI 写 HTML,它写得出来,但很慢、很贵,而且经常画歪。
直到我看到这个项目——它换了个思路,把"内容"和"排版"拆开了。
它是什么:一个 Agent Skill,不是网站
项目叫 Answer me with HTML,作者 QingYunA。
目前约 3,600 Star、MIT 协议,2026 年 10 月 2 日创建——到今天才半个月,已经涨得很猛。
它不是又一个"AI 生成网页"的产品,而是一个装进 AI 编程助手里的 Skill。
装好之后,你什么都不用改,照常提问:
- > Explain the TCP three-way handshake > Map out how the modules in this repo fit together > Redis or Memcached for our cache?
AI 会先写一份很短的 Markdown 草稿,交给 Skill 自带的 CLI。 大约 50 毫秒后,你得到一张网页。
注意这个分工: 模型只写内容,排版、配色、画图,全交给 CLI。
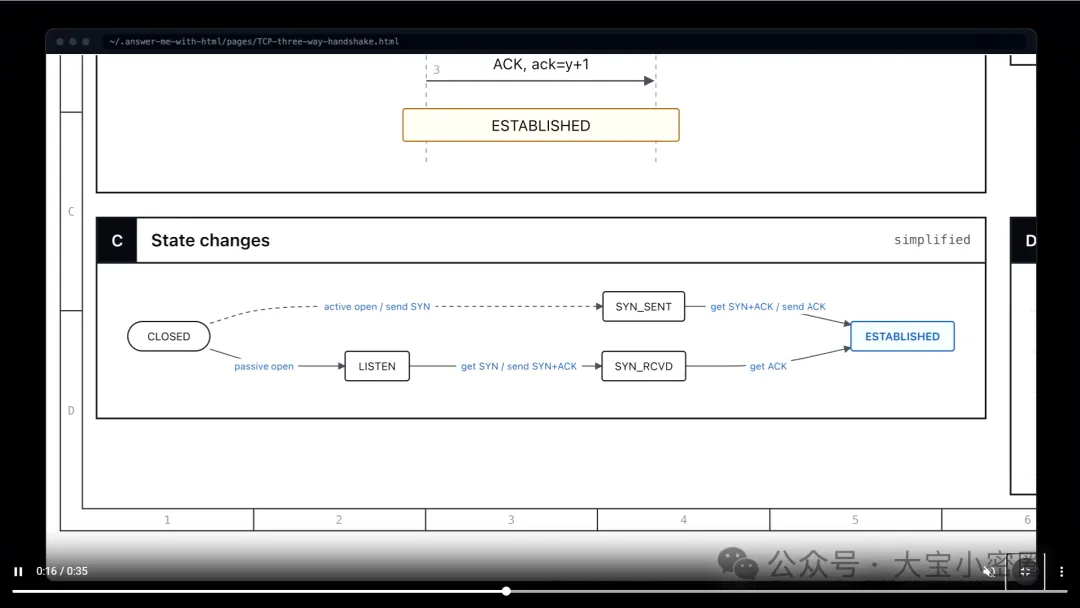
这才是它真正聪明的地方。
为什么不直接让 AI 写 HTML?
你当然可以直接说"用 HTML 回答我"。 模型现在也能写出像样的页面。
但项目作者统计了模型手写的 9 个页面,平均 4,893 个 token,然后拆开看这些 token 花在哪:
| SVG 图表:坐标和路径 | 47% | |
| CSS 样式 | 15% | |
| HTML 标签 | 17% | |
| 正文内容 | 21% |
看明白了吗?模型手写 HTML 时,将近 80% 的 token 都花在"排版"上,真正的内容只占两成。
而且图表最要命: 模型得自己算 SVG 坐标,箭头经常指向空气。
这个 Skill 的做法是: 模型只写那 21% 的内容,剩下的全交给程序算。
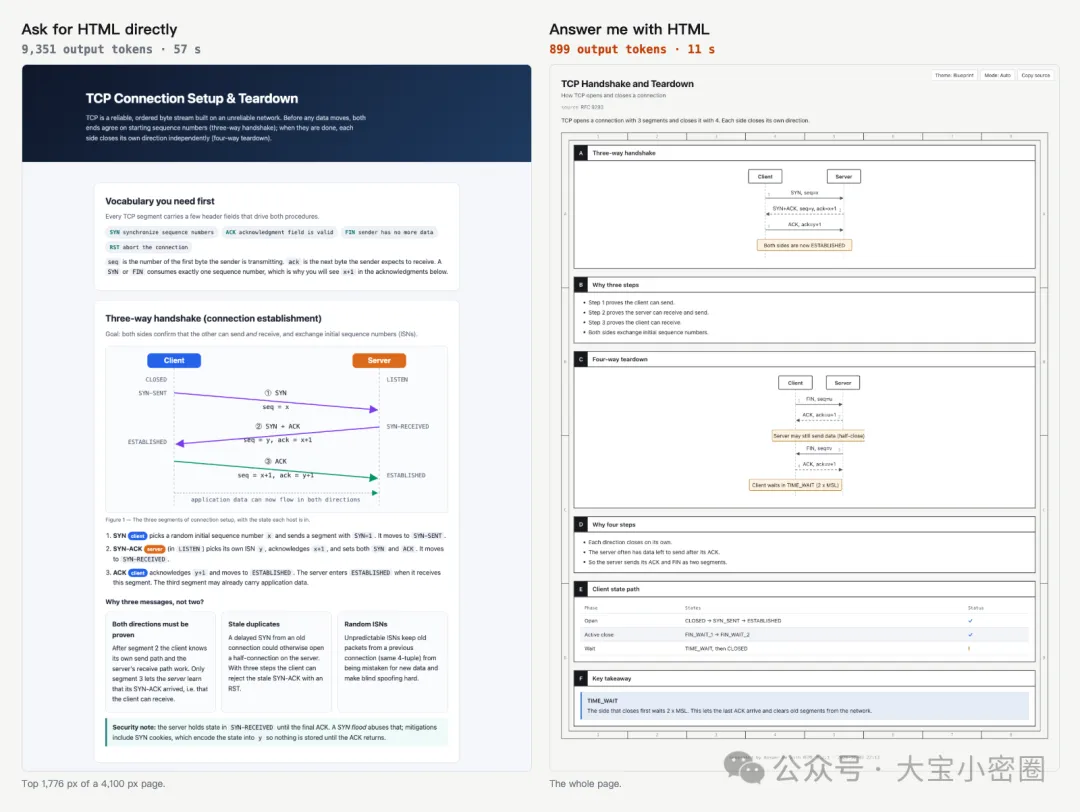
结果有多明显?
| 模型输出 token | 612 | |
| 耗时 | 12 秒 |
官方结论:token 少 8 倍,速度快 2.6 倍。 (基准是 3 个主题 × 3 次运行的中位数,Claude Sonnet 5.5,普通 Claude Code 环境。)
解释视频更夸张: 输出 token 少约 18 倍,速度快 12 倍。
你问什么,它给你什么
这是最能体现它价值的一张表:
| 不给页面 |
最后一条特别重要: 它不是无脑给你生成网页。 AI 会判断"这个问题值不值得做一页"—— 相关概念多、步骤复杂、需要多方对比,才做;一句话能答的,就不折腾。
你也可以直接说"用 HTML 解释",强制它做。
它到底怎么"画"出来的
模型写的草稿,长这样(这是 README 里的真实示例):
---title: TCP three-way handshake---## A Three-way handshake {span=2}```sequence numClient -> Server: SYN, seq=xServer -> Client: SYN+ACK, seq=y, ack=x+1Client -> Server: ACK, ack=y+1note Client, Server: ESTABLISHED```## C State changes {span=2}```flow LR(CLOSED) -> LISTEN: passive openLISTEN -> SYN_RCVD: get SYN / send SYN+ACKSYN_RCVD -> *ESTABLISHED: get ACK```
就这么多。 没有 CSS、没有坐标、没有 <div>。
剩下的交给 CLI: 选模板、排面板、套主题、用 dagre 自动布局流程图、按时序图标签宽度算间距。
而且它会"自己纠错": 草稿写错了,CLI 会返回行号、出错的组件、和一个正确示例,AI 一次就能改对。
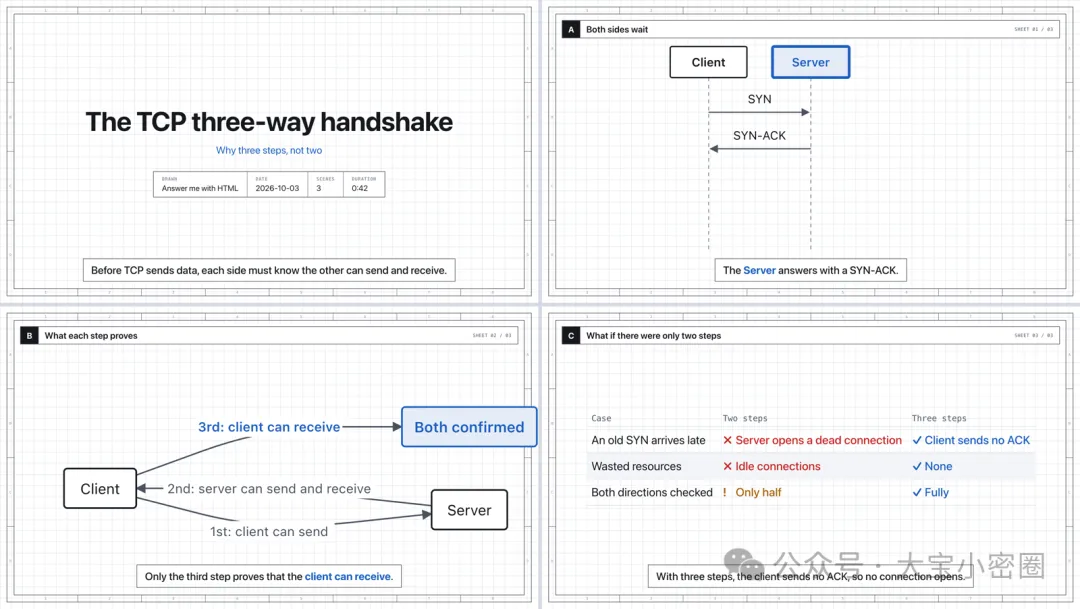
组件不是随便画的,是按"信息形状"选的
它内置了一整套组件,AI 会根据信息的结构自动选:
flow | |
er | |
sequence | |
tree | |
timeline | |
chart | |
annot | |
limits | |
callout | |
ask | |
src=lines=),不是重打一遍 | |
ok / no / warn 自动变 ✓ ✗ ! |
它不是"给你一块画布随便画",而是"先理解你要表达什么,再选最合适的图形"。 这个设计思路,比单纯堆组件库高一个层次。
几个我觉得很妙的细节
① 三种主题,还能自己加
blueprint 像工程蓝图,shadcn 是干净卡片,paper 适合长文阅读。默认长文用 paper、图表用 blueprint,都支持明暗模式。 官网还有主题目录,可以自己加。
② 单文件,零依赖,离线可开
每一页就是一个 .html,没有 CDN、没有网络字体。 断网也能打开,发给别人也是发一个文件。
③ 支持中文、繁体、英文、日文
这几种语言有独立的按钮和字体,其他语言用英文按钮也能正常工作。
④ 有一套"写作检查"
草稿会按 ASD-STE100(航空维修手册用的受控英语标准)检查: 句子太长、用词啰嗦、被动语态。默认只警告,开 strict 模式会直接拒绝不合格的稿子。 连中文错别字和空话也会查。
⑤ 页面上能直接回答
你可以给任何面板写评论,在 AI 提出的决策项里选答案, 点"Reply"按钮,你的批注和选择会合成一条消息,粘回给 AI 就行。
⑥ 页面自带"源码"
每一页都内嵌了生成它的 Markdown, 点"Copy source"就能拿回来。想改、想复用、想存档,都行。
⑦ 真实代码,不是重打
代码块可以从你的文件里引用指定行(src= lines=), 页面上的代码就是你项目里的代码。而且会拒绝读取文件夹外的文件、以及带密钥的文件。
怎么装
需要 Node.js 20 或更新版本。 没有 npm install 步骤,CLI 直接打包在 Skill 里。
最省事的方式,把这句话粘给你的 AI:
Install Answer me with HTML: read https://raw.githubusercontent.com/QingYunA/answer-me-with-html/main/INSTALL.md and follow it.
Claude Code 用户也可以直接跑:
- /plugin marketplace add QingYunA/answer-me-with-html /plugin install answer-me-with-html@answer-me-with-html
或者一条命令(支持 70+ 种 Agent):
- npx skills add QingYunA/answer-me-with-html
官方支持 Claude Code、Codex、Cursor、OpenCode、Pi、DeepSeek Harness 等。
强烈建议开"always-on 模式": 每次给出结论、总结、计划、对比时,都自动附一页小页面(常规回答 2–4 个面板), 不弹窗、不打断你。 默认是关的,需要往规则文件里加一条规则。
几条必须说清的边界
第一,它是一个"Skill",不是独立软件。
你得先有一个能跑 shell 命令的 AI Agent(Claude Code、Codex、Cursor 等),再装它。 没有 Agent,它本身不工作。 另外需要 Node.js 20+。
第二,那些"8 倍 / 2.6 倍"是官方自测,样本不大。
基准是 9 个页面、3 个主题 × 3 次运行,只用了 Claude Sonnet 5.5 一个模型,在普通 Claude Code 环境里测的。方向可信,但别把它当成"所有模型、所有问题都 8 倍"。你自己的问题越复杂、图表越多,收益才越明显。
第三,token 省 8 倍,账单可不会省 8 倍。
这一点作者自己写得很诚实: 实际费用只降了约 15%。 因为每一轮对话,系统提示、你的问题、历史上下文都要重新读一遍, 这部分开销跟用不用 Skill 无关。 省的是"模型输出",不是"模型输入"。
第四,它是本地文件,不是在线服务。
页面存在 ~/.answer-me-with-html/pages/ 里。 分享就是发 HTML 文件,没有托管、没有链接失效问题,但也没有"打开就能看"的云地址。 页面多了要自己清(am clean)。
第五,always-on 模式会"生产"很多页面。
每个结论都配一页,时间长了会堆一堆。 官方给了清理命令,但"自动生成"和"越堆越多"是一体两面,嫌烦就别开,或者调成"少主动"。
第六,它解决的是"表达形态",不是"内容正确性"。
页面再好看,内容错了还是错的。 它帮你把 AI 的输出变得可读、可核对,但 关键结论、代码、数据,还是得你自己验证。 别因为"图很漂亮"就放松警惕。
第七,项目非常新。
2026 年 10 月 2 日创建,半个月冲到 3,600 Star, 迭代极快(今天还在提交)。功能长得快是好事,但也意味着接口、行为可能变, 别在关键流水线里裸奔,先小范围试。
写在最后
AI 时代最讽刺的一件事是: 我们造出了能写几千字的模型,然后被这几千字淹没。
这个项目没有去卷"模型更强",而是问了一个更聪明的问题: "为什么答案非得是一段文字?"
它把回答从"文本流"变成了"信息页": 该用图的地方用图,该用表的地方用表,该对比的地方并排对比,该让你决策的地方直接给你选项。
而且它用最工程化的方式解决了成本问题: 模型只写内容,排版交给代码。 同样一个问题,token 少 8 倍、速度快 2.6 倍,页面还更好看。
Karpathy 说,LLM 时代的瓶颈正在从"生成"转向"吸收"。 这个 Skill,就是给"吸收"造的一副眼镜。
如果你每天都在用 Claude Code / Cursor 这类工具,又受够了满屏的 Markdown 长文,它值得试一次:
- GitHub:github.com/QingYunA/answer-me-with-html
- 官网:answer-me-with-html.com
- 安装:
npx skills add QingYunA/answer-me-with-html
- 协议:MIT
觉得有意思的话,点个赞 or 转给身边那个天天被 AI 长文淹没的朋友。
别再让 AI 甩 · END