ARTICLE · 1241129
[手扎] AI接口自动化测试 AI-api-test-harness_04 LLM是助手不是司机-意图调度与四Agent
LLM 是助手不是司机:意图调度与四个 Agent
概述:前一篇立起“跑 + 判 + 报告”确定性闭环,这篇开始往闭环上接 AI。
核心一条:LLM 不主动说话,只有被意图调度点到了才干活。
调度是“司机”,LLM 是“助手”——开车的是确定性规则,LLM 只在规则覆盖不到的开放处被叫来帮忙,
而且它的建议最终还要过一道确定的验证门。
“分析这个失败的用例”这句话,怎么被理解、路由、交给对的 agent、再回框架变成可验证的结果?
机制集中在 src/ah/core/dispatch.py 和 src/ah/llm/agents.py。
一、意图:把一句自然语言,变成一顶帽子
用户的话千变万化,但落到框架本质是在问“用户想让测试系统做什么”。这个“想做什么”就是意图。
src/ah/core/dispatch.py 里 _default_intents() 定义了九种规范意图——规范,即框架认得、能路由
的全部意图,超出这九个归为 unknown 兜底:
generate_data | ||
diagnose | ||
heal | ||
analyze_report | ||
run_case | ||
run_flow | ||
predict | ||
assist | ||
unknown |
关键在 _default_intents() 里每个意图绑了一个 agent 字段——决定落地时找谁干活:
generate_data | AgentDataGen |
diagnose | AgentTriage |
heal | AgentHeal |
analyze_report | AgentReport |
predict | Predictor |
assist | Assist |
run_caserun_flow | orchestrator |
route("这个用例为什么失败?") 文档示例返回 label == "diagnose"。一句自然语言进来,帽子扣上
(diagnose),接下来交给 AgentTriage——整套机制的最小演示。
二、调度三层:规则优先,LLM 兜底,隔离保底
意图不是一步到位让模型猜,是三层递进。src/ah/core/dispatch.py 里 identify 方法的真实分支:
def identify(self, text: str, *, use_llm: bool = True, gate: Any = None) -> Intent:
    """识别文本意图;规则失败且 LLM 可用时可选 LLM 兜底。

    返回的 ``Intent`` 若未命中,则 ``label`` 为 :data:`UNKNOWN`、置信度为 0。
    """
    if gate is None:
        gate = getattr(self, "_gate", None)
    hay = (text or "").lower()
    best: Optional[tuple[float, Intent]] = None
    for label, kws in self._keywords.items():
        for kw in kws:
            if kw.lower() in hay:
                cand = self._intents.get(label)
                if cand is None:
                    continue
                score = float(len(kw))  # 越长越具体,权重越高
                if best is None or score > best[0]:
                    best = (
                        score,
                        Intent(
                            label=label,
                            agent=cand.agent,
                            description=cand.description,
                            confidence=0.8 + min(0.2, score / 40.0),
                            matched_keyword=kw,
                        ),
                    )
    if best is not None:
        return best[1]  # 第一层:确定性关键词规则
    # 第二层:LayaGate 前置(intent 环节,默认关)。
    # 高置信 AUTO → 直接采用;否则落回 LLM 兜底(字节等价护栏)。
    if gate is not None:
        try:
            dec = gate.decide("intent", text, _LAYANTENT_QUESTIONS)
            if dec.action.value == "auto" and isinstance(dec.value, dict):
                laya_label = dec.value.get("intent")
                if laya_label in self._intents:
                    base = self._intents[laya_label]
                    return Intent(
                        label=laya_label, agent=base.agent,
                        description=base.description, confidence=dec.confidence,
                        matched_keyword=None,
                    )
        except Exception as exc:  # Laya 故障绝不破坏原流程
            log.debug("intent laya gate failed: %s", exc)
    # 第三层:LLM 兜底。仅在显式启用且 LLM 可用时。
    if use_llm and self._llm is not None:
        try:
            result = self._llm.judge(
                "intent-dispatch",
                "Classify the user request into exactly one of: "
                + ", ".join(self.intents())
                + ".\nReturn JSON: {\"intent\": \"<label>\", \"reason\": str}\n"
                f"REQUEST: {text}",
                model="strong",
            )
            label = str(result.get("intent", "")).strip()
            if label in self._intents:
                base = self._intents[label]
                return Intent(
                    label=label, agent=base.agent, description=base.description,
                    confidence=0.6, matched_keyword=None,
                )
        except Exception as exc:  # LLM 兜底绝不破坏 hermetic
            log.debug("intent LLM fallback failed: %s", exc)
    return Intent(label=UNKNOWN, agent="unknown",
                  description=_INTENT_DESCRIPTIONS[UNKNOWN], confidence=0.0)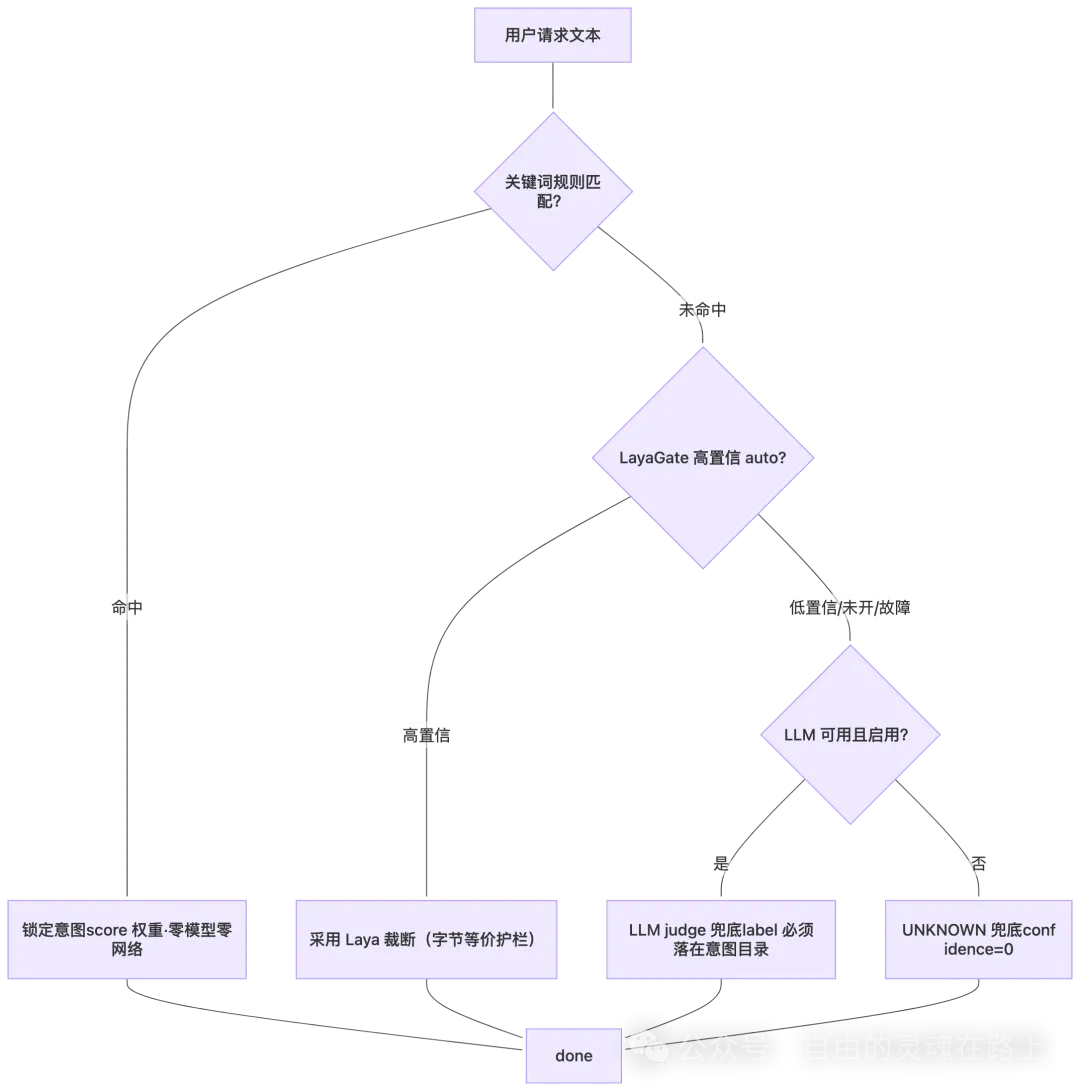
三层递进,一个朴素原则:能确定就不求模型,模型判到高置信就用,判不准就退回老路,老路也断就保底不崩。
这不是为省 token,是让调度这条主路永远可用、永远可预期。
三层分工:
- 关键词规则(
_DEFAULT_KEYWORDS):快、稳、零成本、零网络,覆盖率高的常规问法在这一层解决。
代码里score = float(len(kw))——越长越具体、权重越高,锁定最具体的那条。 - LayaGate 前置 + LLM 兜底: 规则没命中先问一层 LayaGate(决策模型前置层,
src/ah/evidence/laya_gate.py),dec.action.value == "auto"高置信才采用,任何Exception都log.debug后落回。Laya 真判不了或没配,
才轮到 LLM judge——注意兜底也受限:label必须落在self._intents目录里才被接受,模型不能发明新意图。 - 隔离保底: Laya、LLM 都没配(
LLMOFF=1)或都返回不了合法意图,不抛,落到UNKNOWN(confidence=0)。
所以意图机制在LLMOFF=1下也能跑:关键词层不需要模型,光它就能覆盖大部分。
三、四个 Agent,各管一摊
src/ah/llm/agents.py 定义四个 LLM agent,是被调的“劳力”。各自的专注点决定能干的活。
AgentDataGen | llm_gen 用例合成请求参数 | |
AgentTriage | explain_failure | |
AgentHeal | _should_attempt | |
AgentReport | analyze_resultssummarize_records 转 markdown 摘要 |
• AgentDataGen: 为 llm_gen 用例合成请求参数。配合用例 schema、围绕被测接口生成有意义的请求体,
把“造数据”这件开放的事从人手里接过去。
• AgentTriage: 分析失败根因,把 expected 200 got 500原始断言翻译成"根因是脚本预期错、
还是服务真的有问题"。
• AgentHeal: 反思循环向更强模型要修正用例。先 _should_attempt 判断该不该试,通过才尝试,
调更强模型产出修正候选——最靠近“改代码”的一个。
• AgentReport: 把一批 StepResult 变成人读的总结文字。报告模块“预测分析 · LLM 建议”就是它的产物。
四个 agent 最大的共同点:只输出“建议”,不擅自改任何真实状态。AgentHeal 候选要被人或框架确认后才生效;AgentTriage 分析给人看;AgentDataGen 参数要过用例执行验证。没有一个 agent 能绕过验证直接改线上行为。
这层约束是“助手不是司机”的实体化——它们干活,但方向盘不在它们手里。
四、安全跳过:依赖缺失也不抛
调度里的关键设计:DispatchResult 的安全跳过语义。dispatch.py 的 dataclass,docstring 写得很直白:
@dataclass
class DispatchResult:
    """一次 ``dispatch`` 的产物。

    为避免破坏调用方,当必要依赖缺失时不会抛出,而是设置 ``skipped=True`` 与
    说明性的 ``reason``;真正执行成功时 ``output`` 持有 agent/编排器的返回值。
    """
    intent: Intent
    action: str
    output: Any = None
    skipped: bool = False
    reason: Optional[str] = None
    metadata: dict[str, Any] = field(default_factory=dict)
用户说“修一下这个用例”,调度发现 heal 需要的 client/ctx 运行时依赖没就绪,不抛异常炸掉整个流程,
而是返回 skipped=True + 一句 reason(如“缺少 case 参数。”)。
为什么必须这样?LLM 能力和依赖本质是可选的。测试框架不能因为"用户说了句想让它做的事,
但某个增强依赖没就绪"就崩溃。skipped=True 是优雅降级:告诉调用方“意图认出来了,但干不了,原因在这”,
调用方选择忽略/记录/走别的路。
构造细节:IntentRouter.__init__ 默认惰性创建“各自无模型的 agent 实例”,保证 hermetic——
四个 agent 在 LLMOFF=1 下是“没有模型的后端”,返回固定值不触网。真正被 dispatch 分支点到、
且 LLM 可用时,才注入真模型干活。LLMOFF=1 下整个调度链路都能跑、能被测试覆盖,一个 token 都不花。
五、验真门:AI 的建议,要过确定的验证才算数
LLM 接入里最坚持的一条:LLM 的建议不能直接信,要过重跑验证。
拿 AgentHeal 举例。它反思循环生成一个“修正后的用例”候选。如果框架直接采纳写回,风险很大——
模型可能生成一个恰好让测试变绿、但其实是把断言改松了的“作弊用例”。这是测试里最要命的假象:
把红灯当真绿。
处理方式:候选要过 run_single 重跑验证才采纳。AgentHeal 给的修正不是“说你行你就行”,
是拿去真的跑一遍,看结果是否符合预期——跑得绿才采纳,跑不绿就弃。这一步把“模型建议的用例”
变成“被验证过的用例”,在采纳前把 AI 幻觉挡在门外。
同样的哲学贯穿所有生成类能力:进化候选过 min_quality 门控,自愈建议过重跑验证。它们共同回答——
怎么既享受 LLM 的生成能力,又不被它的幻觉干扰到测试的确定性。答案是:生成可以做,采纳必须过确定性的门。
模型负责“想”,框架负责“验”,验不过就扔。
六、一条请求的完整旅程
追一遍“这个用例为什么失败?”的旅程:
进入 IntentRouter,先走关键词规则层。话里有“失败”,命中 diagnose 规则,意图锁定diagnose。
零模型、零网络,瞬间完成。调度到 AgentTriage,调用explain_failure。缺 case 参数返回skipped=True;给了就分析失败上下文,
产出根因解释。根因解释回到报告/用户面前。 AgentTriage只分析,不擅自改。
再看“把这个用例修一下”:
关键词命中 heal,意图锁定 heal。调度到 AgentHeal。先_should_attempt该不该修,不该修就跳过;该修反思循环产出修正候选。候选采纳前过 run_single重跑验证:真跑一遍,符合预期才采纳。采纳后用例更新,下一轮运行由确定性断言检验。
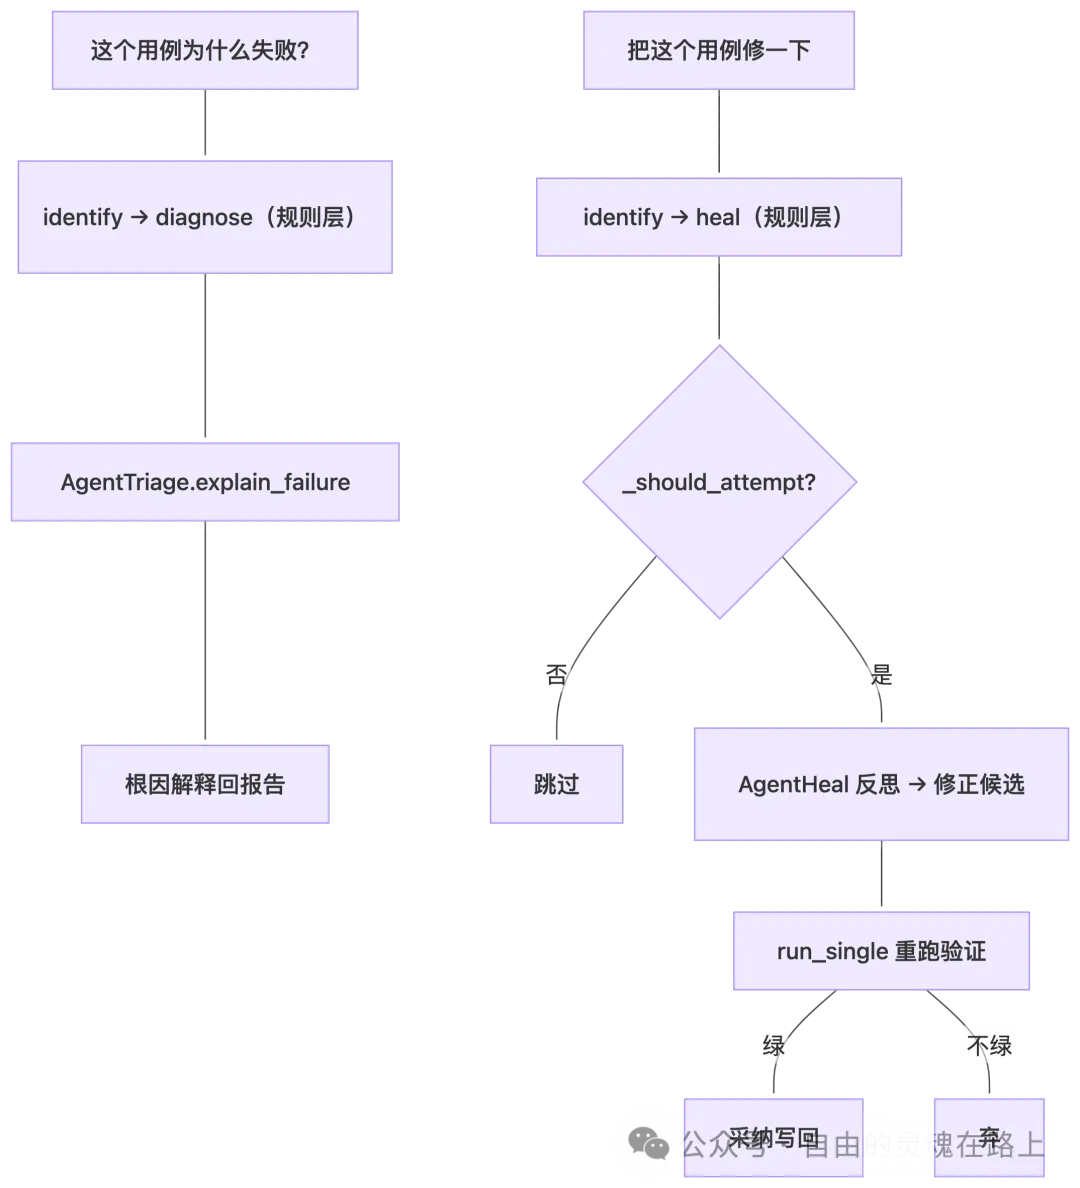
两条旅程对比,看清“司机”和“助手”的分工:路由和验证是司机(确定性),分析和生成是助手(LLM)。
助手干多少活都行,最终决定权在司机手里。
七、命令落地:从意图到 CLI
意图调度落了地、能通过 CLI 触达。命令入口 ah(或 python -m ah.cli)。
用户想生成用例参数,落到框架是 add-case 加一句自然语言——ah add-case <project> "生成一个创建订单的用例",
底层让 AgentNL2Case(自然语言转用例助手)把描述转成用例,追加 + 去重写回 data/<name>.yaml,
可加 --run-live 对真实服务验证。前面的意图调度,正是 add-case 这类自然语言入口背后的通用机制:
先认意图,再路由到对应能力。
LLM 关闭时 add-case 返回明确错误(零网络)——不悄悄降级成别的,而是把“这活必须靠 LLM”摊开讲清楚,
让用户知道该去配 key 或换别的入口。
意图调度不是一个孤立的“给一句描述分类”小功能,它是自然语言动作的总入口:生成数据、诊断、修复、分析、
预测、跑流程,全从这里进去,各自落到对应的确定性执行或 LLM 助手。它把“用户可以像跟人说话一样用这个框架”
这件事,工程化成了一台可控的机器。
八、LLM 接入的地基是“门”
沉淀四条经验:
- 调度三层递进,规则永远有优先权。 关键词层零成本、零网络、可预期,先走它;LayaGate 高置信才裁;
LLM 只是兜底。90% 常规意图不烧 token、不依赖网络、结果稳定。LLM 是可选的放大器,不是必经的瓶颈。 - 所有 agent 只出建议,不擅自改状态。 没有一个能绕过验证直接改线上行为。分工上司机管路由和验证,
助手管分析和生成——这是“助手不是司机”的实体保证。 - 依赖缺失要安全跳过,绝不抛崩。
DispatchResult(skipped=True)让 LLM 能力成为永远可选的层:
缺依赖回收缩成“认了意图但没干成,附原由”,调用方不崩,框架在LLMOFF=1下依然全绿。 - 验证门是防幻觉的核心。
run_single重跑验证、min_quality 门控,把“模型建议的用例”变成“被验证过的用例”。
想享受生成能力,就必须接受采纳前过确定性门。
下一篇把“生成 + 验证”推到极致:不靠用户开口,让框架自己在跑、分析、生成、持久化的闭环里长出用例——
它怎么保证长出来的用例不失控、能回滚。源码可回查:src/ah/core/dispatch.py、src/ah/llm/agents.py。