ARTICLE · 1242228
知识向量化与索引化:代码仓库/需求文档/技术文档的语义基建
需求理解、技术调研、研发执行这几个研发阶段的Agent能力,有一个共同的底层基建——知识向量化索引化。没有它,Agent只能理解当前上下文,无法做跨文档、跨仓库的语义检索。本文要拆解的就是全生命周期Agent的"大脑":如何将代码仓库、需求文档、技术文档三类知识向量化索引化,支撑全链路语义检索。
1. 开篇:为什么Agent需要知识向量化
先看一个没有知识向量化的场景:
RD问Agent:"我们系统里有没有处理过退款逻辑?"
如果没有知识向量化,Agent只能:
在当前对话上下文中搜索——找不到,因为没聊过 用grep在代码仓库里搜"退款"——可能找到,也可能找不到(如果代码里写的是refund或 drawbacks)
但如果有知识向量化,Agent可以:
语义检索代码仓库——找到 RefundService.processRefund(),即使RD问的是"退款"语义检索需求文档——找到三个月前的退款PRD 语义检索技术文档——找到退款流程的设计文档 跨文档关联——告诉RD"退款逻辑在RefundService中,对应PRD是xxx,设计文档是xxx"
这就是知识向量化的价值:让Agent从"只能看到当前上下文"变成"能看到整个项目的所有知识"。
1.1 三类知识的向量化
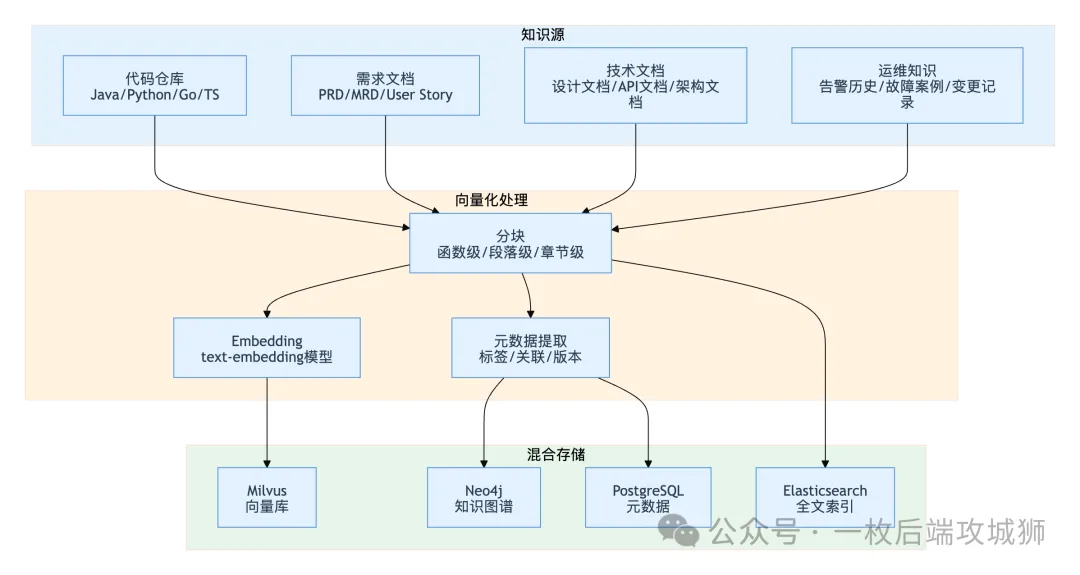
1.2 全生命周期中的知识检索场景
2. 统一知识索引架构
2.1 混合存储方案
from dataclasses import dataclass, fieldfrom typing importOptional, Anyfrom enum import EnumclassKnowledgeType(Enum): CODE = "code" REQUIREMENT = "requirement" DESIGN = "design" INCIDENT = "incident"@dataclassclassKnowledgeChunk:"""统一知识块""" chunk_id: str knowledge_type: KnowledgeType source: str# 来源(仓库名/文档ID) title: str# 标题 content: str# 内容 embedding: list[float] # 向量 metadata: dict# 元数据 version: str# 版本 created_at: str updated_at: strclassUnifiedKnowledgeStore:"""统一知识存储——混合存储方案"""def__init__( self, milvus_client, # 向量库 neo4j_client, # 知识图谱 postgres_client, # 元数据 es_client, # 全文索引):self.milvus = milvus_clientself.neo4j = neo4j_clientself.postgres = postgres_clientself.es = es_clientdefindex(self, chunk: KnowledgeChunk) -> bool:"""索引一个知识块"""try:# 1. 存入向量库self.milvus.insert( collection_name=f"knowledge_{chunk.knowledge_type.value}",id=chunk.chunk_id, vector=chunk.embedding, fields={"title": chunk.title,"content": chunk.content[:500],"source": chunk.source,"version": chunk.version,"knowledge_type": chunk.knowledge_type.value, } )# 2. 存入元数据库self.postgres.execute("""INSERT INTO knowledge_chunks (chunk_id, knowledge_type, source, title, content, metadata, version, created_at, updated_at) VALUES (%s, %s, %s, %s, %s, %s, %s, %s, %s) ON CONFLICT (chunk_id) DO UPDATE SET content = EXCLUDED.content, metadata = EXCLUDED.metadata, version = EXCLUDED.version, updated_at = EXCLUDED.updated_at""", [ chunk.chunk_id, chunk.knowledge_type.value, chunk.source, chunk.title, chunk.content,str(chunk.metadata), chunk.version, chunk.created_at, chunk.updated_at, ] )# 3. 存入全文索引self.es.index( index=f"knowledge_{chunk.knowledge_type.value}",id=chunk.chunk_id, document={"title": chunk.title,"content": chunk.content,"source": chunk.source,"knowledge_type": chunk.knowledge_type.value,"version": chunk.version, } )# 4. 存入知识图谱(关联关系)self._update_graph(chunk)returnTrueexcept Exception as e:returnFalsedefsearch( self, query: str, query_embedding: list[float], knowledge_types: list[KnowledgeType] = None, top_k: int = 10,) -> list[dict]:"""混合检索:语义+全文+图谱""" results = []# 1. 语义检索 semantic_results = self._semantic_search( query_embedding, knowledge_types, top_k )# 2. 全文检索 keyword_results = self._keyword_search( query, knowledge_types, top_k )# 3. 图谱检索(关联扩展) graph_results = self._graph_search( semantic_results[:3], top_k )# 4. 融合排序 merged = self._fusion( semantic_results, keyword_results, graph_results )return merged[:top_k]def_semantic_search( self, embedding, types, top_k) -> list[dict]:"""向量语义检索""" collections = ( [f"knowledge_{t.value}"for t in types]if typeselse ["knowledge_code", "knowledge_requirement","knowledge_design", "knowledge_incident"] ) all_results = []for coll in collections: results = self.milvus.search( collection_name=coll, vector=embedding, top_k=top_k, output_fields=["title", "content", "source", "version"] ) all_results.extend(results)return all_resultsdef_keyword_search( self, query, types, top_k) -> list[dict]:"""全文检索""" indices = ( [f"knowledge_{t.value}"for t in types]if typeselse ["knowledge_code", "knowledge_requirement","knowledge_design", "knowledge_incident"] ) all_results = []for idx in indices: results = self.es.search( index=idx, query={"match": {"content": query}}, size=top_k ) all_results.extend(results["hits"]["hits"])return all_resultsdef_graph_search( self, seed_results: list[dict], top_k: int) -> list[dict]:"""图谱检索——基于种子结果扩展关联"""ifnot seed_results:return [] related = []for seed in seed_results[:3]: seed_id = seed.get("id") or seed.get("_id")ifnot seed_id:continue# 查询关联节点 cypher = """ MATCH (n)-[r:RELATES_TO|DEPENDS_ON|IMPLEMENTS|REFERENCES]->(m) WHERE n.chunk_id = $chunk_id RETURN m.chunk_id as related_id, m.title as title, m.knowledge_type as type, r.relation_type as relation LIMIT $limit """ results = self.neo4j.run( cypher, chunk_id=seed_id, limit=top_k ) related.extend(results)return relateddef_fusion( self, semantic, keyword, graph) -> list[dict]:"""融合排序""" scores = {}# 语义结果加权for r in semantic: rid = r.get("id") or r.get("_id", "") score = r.get("score", r.get("_score", 0)) scores[rid] = scores.get(rid, 0) + score * 0.5# 全文结果加权for r in keyword: rid = r.get("_id", "") score = r.get("_score", 0) / 10# ES分数归一化 scores[rid] = scores.get(rid, 0) + score * 0.3# 图谱结果加权for r in graph: rid = r.get("related_id", "") scores[rid] = scores.get(rid, 0) + 0.2# 排序 sorted_ids = sorted( scores.keys(), key=lambda x: scores[x], reverse=True )# 构建结果列表 all_results = {r.get("id", r.get("_id", "")): r for r in semantic + keyword}return [ {**all_results.get(rid, {"id": rid}), "fusion_score": scores[rid]}for rid in sorted_ids ]def_update_graph(self, chunk: KnowledgeChunk):"""更新知识图谱"""# 创建节点self.neo4j.run("""MERGE (n:Knowledge {chunk_id: $chunk_id}) SET n.title = $title, n.knowledge_type = $type, n.source = $source""", chunk_id=chunk.chunk_id, title=chunk.title,type=chunk.knowledge_type.value, source=chunk.source, )# 创建关联关系for ref in chunk.metadata.get("references", []):self.neo4j.run("""MERGE (m:Knowledge {chunk_id: $ref_id}) WITH n, m MERGE (n)-[:REFERENCES]->(m)""", chunk_id=chunk.chunk_id, ref_id=ref, )2.2 知识图谱关联模型
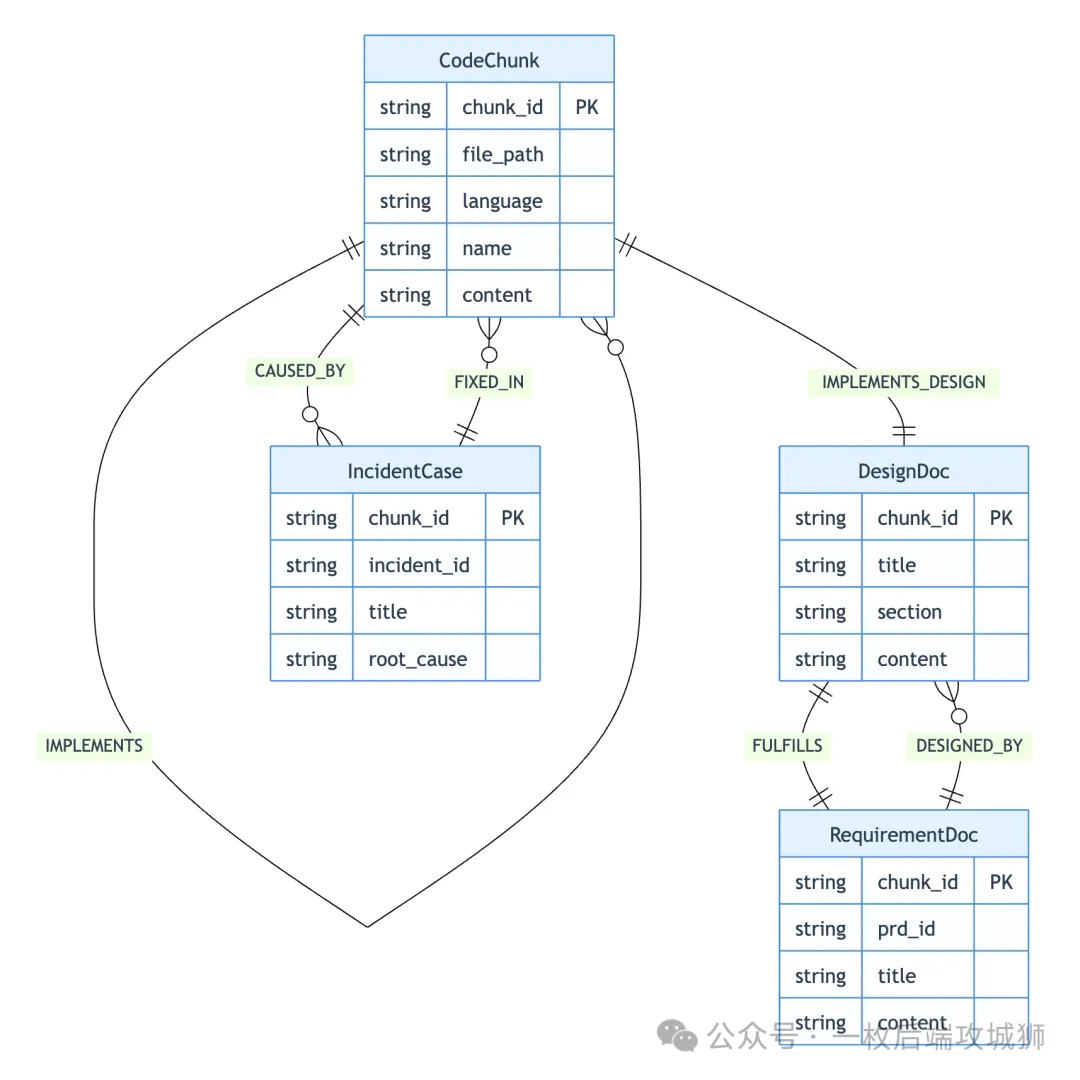
3. 代码仓库向量化
3.1 多粒度分块策略
classCodeIndexer:"""代码仓库索引器""" GRANULARITY = {"file": "文件级——适合概览检索","class": "类级——适合模块检索","function": "函数级——适合精确检索", }def__init__(self, chunker, embedder, store: UnifiedKnowledgeStore):self.chunker = chunkerself.embedder = embedderself.store = storedefindex_repo( self, repo_name: str, repo_path: str) -> dict:"""索引整个代码仓库"""import os stats = {"files": 0, "chunks": 0, "errors": 0}for root, dirs, files in os.walk(repo_path):# 跳过 .git, node_modules, target 等 dirs[:] = [d for d in dirs if d notin {".git", "node_modules", "target","build", ".idea", "__pycache__"}]for file in files: file_path = os.path.join(root, file) rel_path = os.path.relpath(file_path, repo_path) language = self._detect_language(file)if language == "unknown":continuetry:withopen(file_path, 'r', errors='ignore') as f: content = f.read() chunks = self.chunker.chunk_file( rel_path, content, language )for chunk in chunks: chunk.repo_name = repo_name embedding = self.embedder.embed(self._build_embed_text(chunk) ) knowledge_chunk = KnowledgeChunk( chunk_id=chunk.chunk_id, knowledge_type=KnowledgeType.CODE, source=repo_name, title=chunk.name, content=chunk.content, embedding=embedding, metadata={"file_path": chunk.file_path,"language": chunk.language,"chunk_type": chunk.chunk_type,"start_line": chunk.start_line,"end_line": chunk.end_line,"imports": chunk.imports,"docstring": chunk.docstring,"calls": chunk.calls,"called_by": chunk.called_by, }, version=self._get_git_version( repo_path, rel_path ), created_at=self._now(), updated_at=self._now(), )self.store.index(knowledge_chunk) stats["chunks"] += 1 stats["files"] += 1except Exception as e: stats["errors"] += 1return statsdef_build_embed_text(self, chunk) -> str:"""构建用于embedding的文本""" parts = []if chunk.docstring: parts.append(f"Documentation: {chunk.docstring}") parts.append(f"{chunk.chunk_type}: {chunk.name}") parts.append(f"File: {chunk.file_path}")if chunk.imports: parts.append(f"Imports: {', '.join(chunk.imports[:5])}") parts.append(f"Code:\n{chunk.content}")return"\n".join(parts)def_detect_language(self, filename: str) -> str:import os ext = os.path.splitext(filename)[1].lower()return {".java": "java", ".py": "python", ".go": "go",".ts": "typescript", ".tsx": "typescript",".js": "javascript", ".kt": "kotlin",".rs": "rust", ".c": "c", ".cpp": "cpp", }.get(ext, "unknown")def_get_git_version(self, repo_path: str, file_path: str) -> str:"""获取文件的Git版本"""import subprocesstry: result = subprocess.run( ["git", "log", "-1", "--format=%H", "--", file_path], cwd=repo_path, capture_output=True, text=True, timeout=5 )return result.stdout.strip()[:8] or"unknown"except Exception:return"unknown"def_now(self) -> str:from datetime import datetimereturn datetime.now().isoformat()3.2 增量索引一致性
增量索引的核心难题是一致性——Git提交和索引更新之间的时间差可能导致检索到过期内容。
classConsistencyManager:"""索引一致性管理器"""def__init__(self, store: UnifiedKnowledgeStore):self.store = storedefcheck_consistency( self, repo_name: str, current_commit: str) -> dict:"""检查索引一致性"""# 获取最后索引的commit last_indexed = self.store.postgres.query_one("SELECT last_indexed_commit FROM repo_index_state ""WHERE repo_name = %s", [repo_name] )ifnot last_indexed:return {"status": "never_indexed","last_indexed": None,"current": current_commit,"behind_by": "unknown", } last_commit = last_indexed.get("last_indexed_commit")if last_commit == current_commit:return {"status": "consistent","last_indexed": last_commit,"current": current_commit,"behind_by": 0, }# 计算落后的提交数import subprocess result = subprocess.run( ["git", "rev-list", "--count",f"{last_commit}..{current_commit}"], capture_output=True, text=True ) behind = int(result.stdout.strip()) if result.returncode == 0else -1return {"status": "behind","last_indexed": last_commit,"current": current_commit,"behind_by": behind, }defreconcile( self, repo_name: str, repo_path: str, from_commit: str, to_commit: str) -> dict:"""修复一致性——增量更新索引"""import subprocess# 获取变更文件 result = subprocess.run( ["git", "diff", "--name-status", from_commit, to_commit], cwd=repo_path, capture_output=True, text=True ) stats = {"added": 0, "modified": 0, "deleted": 0}for line in result.stdout.strip().split("\n"):ifnot line:continue parts = line.split("\t") status = parts[0][0] # A/M/D file_path = parts[-1]if status == "A": stats["added"] += self._index_file( repo_name, repo_path, file_path )elif status == "M": stats["modified"] += self._reindex_file( repo_name, repo_path, file_path )elif status == "D": stats["deleted"] += self._delete_file_index( repo_name, file_path )# 更新索引状态self.store.postgres.execute("""INSERT INTO repo_index_state (repo_name, last_indexed_commit, updated_at) VALUES (%s, %s, NOW()) ON CONFLICT (repo_name) DO UPDATE SET last_indexed_commit = EXCLUDED.last_indexed_commit, updated_at = NOW()""", [repo_name, to_commit] )return statsdef_index_file(self, repo_name, repo_path, file_path):"""索引新文件"""# 实现参考 CodeIndexer.index_repo 中的单文件逻辑return1def_reindex_file(self, repo_name, repo_path, file_path):"""重新索引修改的文件"""self._delete_file_index(repo_name, file_path)returnself._index_file(repo_name, repo_path, file_path)def_delete_file_index(self, repo_name, file_path):"""删除文件索引"""self.store.milvus.delete(filter=f'source="{repo_name}" and 'f'metadata.file_path="{file_path}"' )self.store.postgres.execute("DELETE FROM knowledge_chunks ""WHERE source = %s AND metadata->>'file_path' = %s", [repo_name, file_path] )return14. 需求文档向量化
4.1 需求文档解析与索引
classRequirementIndexer:"""需求文档索引器"""def__init__(self, llm_client, embedder, store: UnifiedKnowledgeStore):self.llm = llm_clientself.embedder = embedderself.store = storedefindex_prd(self, prd_content: str, prd_metadata: dict) -> int:"""索引PRD文档"""# 1. 解析PRD结构 sections = self._parse_prd_sections(prd_content) count = 0for section in sections:# 2. 生成embedding embedding = self.embedder.embed(f"{section['title']}\n{section['content']}" )# 3. 提取关联 references = self._extract_references(section)# 4. 索引 chunk = KnowledgeChunk( chunk_id=f"req_{prd_metadata['prd_id']}_{section['section_id']}", knowledge_type=KnowledgeType.REQUIREMENT, source=prd_metadata.get("source", "jira"), title=section["title"], content=section["content"], embedding=embedding, metadata={"prd_id": prd_metadata["prd_id"],"section_id": section["section_id"],"section_type": section.get("type", "general"),"priority": prd_metadata.get("priority", "P1"),"author": prd_metadata.get("author", ""),"references": references, }, version=prd_metadata.get("version", "1.0"), created_at=prd_metadata.get("created_at", ""), updated_at=prd_metadata.get("updated_at", ""), )self.store.index(chunk) count += 1return countdef_parse_prd_sections(self, content: str) -> list[dict]:"""将PRD解析为章节""" prompt = f""" 将以下PRD文档解析为章节列表:{content[:5000]} 输出JSON数组: [{{ "section_id": "1.1", "title": "章节标题", "content": "章节内容", "type": "background/functional/non_functional/acceptance/dependency" }}] """ result = self.llm.chat(prompt)import jsontry:return json.loads(result)except json.JSONDecodeError:# 降级:按Markdown标题分章节returnself._fallback_parse(content)def_fallback_parse(self, content: str) -> list[dict]:"""降级解析:按Markdown标题分章节"""import re sections = [] current_title = "" current_content = [] section_id = 0for line in content.split("\n"):if line.startswith("#"):if current_content: sections.append({"section_id": str(section_id),"title": current_title,"content": "\n".join(current_content),"type": "general", }) section_id += 1 current_title = line.lstrip("#").strip() current_content = []else: current_content.append(line)if current_content: sections.append({"section_id": str(section_id),"title": current_title,"content": "\n".join(current_content),"type": "general", })return sectionsdef_extract_references(self, section: dict) -> list[str]:"""提取章节中的引用(关联到其他文档/代码)"""import re refs = []# 提取文档链接 refs.extend(re.findall(r'DOC-(\d+)', section["content"]))# 提取Jira Issue refs.extend(re.findall(r'[A-Z]+-\d+', section["content"]))# 提取类名/接口名 refs.extend(re.findall(r'\b([A-Z][a-z]+(?:[A-Z][a-z]+)+)\b', section["content"] ))return refs4.2 需求-代码双向追溯
classTraceabilityBuilder:"""需求-代码双向追溯链路构建器"""def__init__(self, store: UnifiedKnowledgeStore, llm_client):self.store = storeself.llm = llm_clientdefbuild_traceability( self, requirement_chunks: list[str], code_chunks: list[str]) -> dict:"""构建需求-代码追溯链路""" trace_map = {"requirement_to_code": {},"code_to_requirement": {}, }for req_id in requirement_chunks:# 获取需求块内容 req_chunk = self._get_chunk(req_id)ifnot req_chunk:continue# 语义检索相关代码 embedding = req_chunk.embedding related_code = self.store._semantic_search( embedding, [KnowledgeType.CODE], top_k=5 ) code_ids = [r.get("id") for r in related_codeif r.get("score", 0) > 0.7] trace_map["requirement_to_code"][req_id] = code_idsfor code_id in code_ids:if code_id notin trace_map["code_to_requirement"]: trace_map["code_to_requirement"][code_id] = [] trace_map["code_to_requirement"][code_id].append(req_id)# 存入知识图谱self._persist_traceability(trace_map)return trace_mapdef_get_chunk(self, chunk_id: str) -> Optional[KnowledgeChunk]:"""获取知识块""" result = self.store.postgres.query_one("SELECT * FROM knowledge_chunks WHERE chunk_id = %s", [chunk_id] )ifnot result:returnNonereturn KnowledgeChunk(**result)def_persist_traceability(self, trace_map: dict):"""将追溯关系存入知识图谱"""for req_id, code_ids in trace_map["requirement_to_code"].items():for code_id in code_ids:self.store.neo4j.run("""MERGE (req:Knowledge {chunk_id: $req_id}) MERGE (code:Knowledge {chunk_id: $code_id}) MERGE (req)-[:IMPLEMENTED_BY]->(code)""", req_id=req_id, code_id=code_id, )defquery_trace( self, chunk_id: str, direction: str = "forward") -> list[str]:"""查询追溯链路"""if direction == "forward":# 需求→代码 cypher = """ MATCH (n)-[:IMPLEMENTED_BY]->(m) WHERE n.chunk_id = $id RETURN m.chunk_id as related_id """else:# 代码→需求 cypher = """ MATCH (n)-[:IMPLEMENTED_BY]->(m) WHERE m.chunk_id = $id RETURN n.chunk_id as related_id """ results = self.store.neo4j.run(cypher, id=chunk_id)return [r["related_id"] for r in results]5. 技术文档向量化
5.1 技术文档索引
classDesignDocIndexer:"""技术文档索引器"""def__init__(self, llm_client, embedder, store: UnifiedKnowledgeStore):self.llm = llm_clientself.embedder = embedderself.store = storedefindex_design_doc( self, doc_content: str, doc_metadata: dict) -> int:"""索引技术设计文档""" sections = self._parse_sections(doc_content) count = 0for section in sections: embedding = self.embedder.embed(f"{section['title']}\n{section['content']}" ) chunk = KnowledgeChunk( chunk_id=f"design_{doc_metadata['doc_id']}_{section['section_id']}", knowledge_type=KnowledgeType.DESIGN, source=doc_metadata.get("source", "wiki"), title=section["title"], content=section["content"], embedding=embedding, metadata={"doc_id": doc_metadata["doc_id"],"section_id": section["section_id"],"section_type": section.get("type", "general"),"version": doc_metadata.get("version", "1.0"),"author": doc_metadata.get("author", ""),"project": doc_metadata.get("project", ""),"mermaid_diagrams": section.get("has_diagram", False), }, version=doc_metadata.get("version", "1.0"), created_at=doc_metadata.get("created_at", ""), updated_at=doc_metadata.get("updated_at", ""), )self.store.index(chunk) count += 1return countdef_parse_sections(self, content: str) -> list[dict]:"""解析文档章节"""import re sections = [] current_title = "概述" current_content = [] section_id = 0 has_diagram = Falsefor line in content.split("\n"):if re.match(r'^#{1,3}\s', line):if current_content: sections.append({"section_id": str(section_id),"title": current_title,"content": "\n".join(current_content),"type": self._classify_section(current_title),"has_diagram": has_diagram, }) section_id += 1 current_title = re.sub(r'^#{1,3}\s', '', line).strip() current_content = [] has_diagram = Falseelse:if"```mermaid"in line: has_diagram = True current_content.append(line)if current_content: sections.append({"section_id": str(section_id),"title": current_title,"content": "\n".join(current_content),"type": self._classify_section(current_title),"has_diagram": has_diagram, })return sectionsdef_classify_section(self, title: str) -> str:"""分类章节类型""" title_lower = title.lower()ifany(k in title_lower for k in ["背景", "目标", "background"]):return"background"ifany(k in title_lower for k in ["架构", "architecture"]):return"architecture"ifany(k in title_lower for k in ["接口", "api", "interface"]):return"api"ifany(k in title_lower for k in ["数据模型", "er图", "data model"]):return"data_model"ifany(k in title_lower for k in ["流程", "flow", "sequence"]):return"flow"ifany(k in title_lower for k in ["风险", "risk"]):return"risk"ifany(k in title_lower for k in ["部署", "deploy"]):return"deployment"return"general"6. 文档与代码版本漂移检测
6.1 漂移检测引擎
classDriftDetectionEngine:"""文档-代码版本漂移检测引擎"""def__init__( self, store: UnifiedKnowledgeStore, llm_client):self.store = storeself.llm = llm_clientdefdetect_all_drifts(self) -> list[dict]:"""检测所有文档-代码漂移""" drifts = []# 1. 检测API漂移 drifts.extend(self._detect_api_drifts())# 2. 检测数据模型漂移 drifts.extend(self._detect_model_drifts())# 3. 检测配置漂移 drifts.extend(self._detect_config_drifts())return driftsdef_detect_api_drifts(self) -> list[dict]:"""检测接口定义漂移""" drifts = []# 获取所有API设计文档章节 api_docs = self.store.postgres.query("SELECT chunk_id, title, content, metadata ""FROM knowledge_chunks ""WHERE knowledge_type = 'design' ""AND metadata->>'section_type' = 'api'" )for doc in api_docs:import re# 提取设计文档中的接口 designed_apis = re.findall(r'(GET|POST|PUT|DELETE)\s+(/\S+)', doc["content"] )for method, path in designed_apis:# 在代码中搜索该接口 search_results = self.store.search( query=f"{method}{path} endpoint controller", query_embedding=self.embedder.embed(f"{method}{path} endpoint" ), knowledge_types=[KnowledgeType.CODE], top_k=3, )ifnot search_results or \ search_results[0].get("fusion_score", 0) < 0.5: drifts.append({"type": "api_missing","severity": "major","detail": f"接口 {method}{path} "f"在设计文档中定义但代码中未找到","doc_id": doc["chunk_id"], })return driftsdef_detect_model_drifts(self) -> list[dict]:"""检测数据模型漂移""" drifts = []# 获取所有数据模型设计章节 model_docs = self.store.postgres.query("SELECT chunk_id, title, content, metadata ""FROM knowledge_chunks ""WHERE knowledge_type = 'design' ""AND metadata->>'section_type' = 'data_model'" )for doc in model_docs:import re# 提取表名 tables = re.findall(r'CREATE TABLE\s+(\w+)', doc["content"] )# 提取字段 fields = re.findall(r'(\w+)\s+\w+(?:\([^)]+\))?\s+(?:NOT NULL|NULL|DEFAULT)', doc["content"] )for table in tables:# 在代码中搜索对应的Entity results = self.store.search( query=f"{table} entity model class", query_embedding=self.embedder.embed(f"{table} entity model" ), knowledge_types=[KnowledgeType.CODE], top_k=3, )ifnot results or \ results[0].get("fusion_score", 0) < 0.4: drifts.append({"type": "model_missing","severity": "minor","detail": f"表 {table} 在设计中定义但代码中未找到Entity","doc_id": doc["chunk_id"], })return driftsdef_detect_config_drifts(self) -> list[dict]:"""检测配置漂移"""# 简化实现:检测设计文档中提到的配置项是否在代码中存在return []6.2 漂移报告
# 文档-代码版本漂移报告## 漂移摘要| 类型 | 数量 | 严重度 ||------|------|--------|| API缺失 | 3 | Major || Model缺失 | 2 | Minor || 配置漂移 | 1 | Minor |## 详情### API缺失1. [Major] `POST /api/reconciliation/trigger` — 设计文档定义,代码未实现2. [Major] `GET /api/reconciliation/diffs` — 设计文档定义,代码中路径不一致(/api/reconciliation/differences)3. [Major] `POST /api/reconciliation/diffs/{id}/resolve` — 设计文档定义,代码未实现### Model缺失1. [Minor] 表 `reconciliation_result` — 设计文档定义,代码中未找到对应Entity2. [Minor] 表 `diff_resolution_log` — 设计文档定义,代码中未找到对应Entity**建议**:API缺失为Major级别,需在下次迭代中补齐或更新设计文档。7. 跨语言代码的语义对齐
7.1 问题
大型项目可能同时有Java和Python代码。同一个"用户认证"逻辑,Java叫AuthService.authenticate(),Python叫auth_service.verify()。向量检索时,由于函数名不同、语言风格不同,可能导致跨语言检索召回率低。
7.2 解决方案
classCrossLanguageAligner:"""跨语言代码语义对齐器"""def__init__(self, llm_client, embedder):self.llm = llm_clientself.embedder = embedderdefalign_embedding( self, chunk: dict, target_language: str = "en") -> list[float]:"""生成语言无关的embedding"""# 将代码描述翻译为目标语言,再embedding normalized = self._normalize_description(chunk)returnself.embedder.embed(normalized)def_normalize_description(self, chunk: dict) -> str:"""将代码块规范化为语言无关的描述""" prompt = f""" 将以下代码块转换为语言无关的功能描述(英文): 语言: {chunk.get('language', 'unknown')} 类型: {chunk.get('chunk_type', 'unknown')} 名称: {chunk.get('name', 'unknown')} 文档: {chunk.get('docstring', '无')} 代码:{chunk.get('content', '')[:500]} 输出格式: Functionality: <功能描述> Pattern: <设计模式> Dependencies: <依赖的组件> Input: <输入参数> Output: <输出> """returnself.llm.chat(prompt)8. 知识索引的运维与监控
8.1 索引健康度监控
classIndexHealthMonitor:"""索引健康度监控器"""def__init__(self, store: UnifiedKnowledgeStore):self.store = storedefget_health_report(self) -> dict:"""获取索引健康度报告"""return {"code_index": self._check_code_index_health(),"requirement_index": self._check_req_index_health(),"design_index": self._check_design_index_health(),"graph_connectivity": self._check_graph_health(),"drift_count": self._check_drifts(), }def_check_code_index_health(self) -> dict:"""检查代码索引健康度""" total_repos = self.store.postgres.query("SELECT DISTINCT source FROM knowledge_chunks ""WHERE knowledge_type = 'code'" ) stats = {}for (repo,) in total_repos: count = self.store.postgres.query_one("SELECT COUNT(*) as cnt FROM knowledge_chunks ""WHERE knowledge_type = 'code' AND source = %s", [repo] ) last_updated = self.store.postgres.query_one("SELECT MAX(updated_at) as last FROM knowledge_chunks ""WHERE knowledge_type = 'code' AND source = %s", [repo] ) stats[repo] = {"chunk_count": count["cnt"],"last_updated": last_updated["last"], }return statsdef_check_req_index_health(self) -> dict:"""检查需求文档索引健康度""" count = self.store.postgres.query_one("SELECT COUNT(*) as cnt FROM knowledge_chunks ""WHERE knowledge_type = 'requirement'" )return {"chunk_count": count["cnt"]}def_check_design_index_health(self) -> dict:"""检查技术文档索引健康度""" count = self.store.postgres.query_one("SELECT COUNT(*) as cnt FROM knowledge_chunks ""WHERE knowledge_type = 'design'" )return {"chunk_count": count["cnt"]}def_check_graph_health(self) -> dict:"""检查知识图谱健康度""" result = self.store.neo4j.run("MATCH (n:Knowledge) RETURN ""count(n) as nodes, ""count([(n)-[r]->() | 1]) as edges" )if result:return {"nodes": result[0]["nodes"],"edges": result[0]["edges"], }return {"nodes": 0, "edges": 0}def_check_drifts(self) -> int:"""检查漂移数量""" detector = DriftDetectionEngine(self.store, None) drifts = detector.detect_all_drifts()returnlen(drifts)8.2 索引性能指标
9. 知识检索在Agent中的应用
9.1 全链路检索示例
classKnowledgeRetrievalService:"""知识检索服务——供所有Agent阶段调用"""def__init__( self, store: UnifiedKnowledgeStore, embedder, traceability: TraceabilityBuilder,):self.store = storeself.embedder = embedderself.traceability = traceabilitydefsearch_related( self, query: str, context: dict = None, top_k: int = 10,) -> dict:"""全链路关联检索"""# 生成查询embedding query_emb = self.embedder.embed(query)# 混合检索 results = self.store.search( query=query, query_embedding=query_emb, top_k=top_k, )# 扩展关联 enhanced = []for result in results[:5]:# 查询追溯链路 forward = self.traceability.query_trace( result.get("id", ""), "forward" ) backward = self.traceability.query_trace( result.get("id", ""), "backward" ) enhanced.append({ **result,"traceability": {"forward": forward[:3], # 需求→代码"backward": backward[:3], # 代码→需求 }, })return {"query": query,"results": enhanced,"total": len(results), }9.2 各阶段的检索场景
10. 本篇小结
核心观点回顾
知识向量化索引化是全生命周期Agent的"大脑"——没有它,Agent只能理解当前上下文;有了它,Agent能看到整个项目的所有知识
三类知识需要向量化——代码仓库(函数级/类级分块)、需求文档(章节级分块)、技术文档(章节级分块),每类有不同的解析和索引策略
混合存储方案——Milvus向量库(语义检索)+ Neo4j知识图谱(关联关系)+ PostgreSQL元数据(结构化查询)+ Elasticsearch全文索引(精确匹配)
增量索引保证实时性——Git Webhook触发增量更新,一致性管理器检测落后状态并自动修复
需求-代码双向追溯——通过知识图谱的IMPLEMENTED_BY关系,支持从需求查代码、从代码查需求的双向追溯
文档-代码版本漂移检测——自动检测设计文档中定义的接口/数据模型是否在代码中实现,产出漂移报告
跨语言语义对齐——通过LLM将不同语言的代码块规范化为语言无关的功能描述,提升跨语言检索召回率
记住:知识向量化索引化不是"建个向量库就完了"那么简单。一个好的知识索引系统需要解决三个工程难题:增量索引的一致性(不能检索到过期内容)、跨语言代码的语义对齐(不同语言的同名逻辑要能互相检索到)、文档与代码的版本漂移(设计文档改了代码没改要能检测到)。这三个问题解决了,Agent才能真正"看到"整个项目的知识。