ARTICLE · 1245232
DIA-NN 引擎源码考古 · 1.7.12 · 第二回 · 数据进门先报到,名单出炉再下锅 ~
书接上文,针对 DIA-NN 1.7.12 版的引擎,上一回 《DIA-NN 引擎源码考古 · 1.7.12 · 第一回 · 先把引擎的 「地层」看个全貌 ~》 给各位观众老爷立了个全貌,也把往后的续写分了三段:怎么找、怎么判、怎么出定量结果。这一回咱们一起顺着这个框架一步步来,先开始第一段(怎么找)(至于这一串考古的缘起,见更早那篇 《DIA-NN 最新源码里能看到什么、能学到什么:一份公开仓库的观察报告》)。
这一段对应的是前文中九步工序的前三步。
装载:把五花八门的原始数据归成一张排好队的谱图清单,数据进门先报到。
候选装配:把 “该查哪些肽段” 的清单备出来 —— 有现成谱库就递单,没有就把 FASTA 里的一串串氨基酸炼成清单,名单出炉再下锅(FASTA 是一本蛋白质的 “花名册”,里面装的就是氨基酸序列,一个蛋白一条,每条还带一个蛋白 ID 和描述;可质谱仪只认肽段、不认整条蛋白,所以这本花名册得按酶切规则剪开才能用。这份文件怎么从 UniProt 薅到手、该薅哪种,早前那篇 《Uniprot 薅 .fasta 文件指南:蛋白质组分析第一步,小白入门不懵圈!》 专讲这事)。
分批:清单备齐后先装进这次运行,按本次采集的 MS2 窗口过一道可检测性闸,再切成小批,分批下锅。
原料报到:格式几路,账本一本
咱们先看头一桩,数据怎么进门报到。
质谱仪吐出来的原始数据,格式五花八门 —— 每家仪器厂商都有一套自家的私有格式,Thermo、Sciex、Bruker 之外,Waters、Agilent 这些大厂也各有各的规矩,彼此互不买账。要跨厂商流转,常得靠开放格式中转:社区维护的开放标准,转过来谁都能读。
不过私有格式能不能转过去,本身也不是百分百的事 —— 得靠 ProteoWizard 这类转换工具,它们对各家私有格式的支持有全有缺,有的还得先装上厂商自家的接口才认账。
这套转换怎么批量跑起来,小编早前在 《八元小灶 · 第一弹 · Windows 下 MSCovert 一键 「开工」策略(.bat 版)》 给过一份开箱即用的做法。
具体到 DIA-NN 1.7.12 的引擎,它实际识别四种:Thermo 的 .raw、Sciex 的 .wiff、Bruker timsTOF 的 .tdf(数据存在 .d 文件夹里),还有开放格式 .mzML —— 甭管来的是哪家的货,进门都需要归成同一张谱图清单。
怎么归?Run::load 拿到文件先看扩展名,按图索骥分派读取器(L8825 起):.wiff 从随包的 DIA-NN.Wiff.dll 里临时唤出一个读取器(L8837–L8844);.tdf 走专门的多线程读取器(L8889–L8892);.raw 和 .mzML 则交给随包的 mstoolkit 全家桶(L8923 起,多线程 load_raw)。
不过在 1.7.12 那阵子,这些私有格式都不是引擎天生会读的,各有各的 “翻译官”。其中两位要用户自备:.raw 得先装 Thermo 家的 MS File Reader,README 还特意嘱咐认准 3.0 SP3 那一版(README:45);.wiff 得先装 ProteoWizard,选带 vendor files 的 64 位版。
.wiff 这一位还有个容易读反的讲究,而且是 1.7.12 这一版 README 的硬要求:装 DIA-NN 那一步会选安装目录,这里不能按默认的 Program Files\DIA-NN 走,得把 ProteoWizard 的目录填成 DIA-NN 的安装目录 —— 原话是 “specify the ProteoWizard directory … as the installation directory”,给的示例是 C:\Program Files (x86)\ProteoWizard\ProteoWizard\3.0.11537(README:40)。说白了,不是两家各装各的、再让 DIA-NN 记住 ProteoWizard 在哪,而是让 DIA-NN 直接装进 ProteoWizard 的文件夹里,跟它挤在同一个目录下。
这条规矩在 1.7.15 换了个做法:不再让你改安装目录,改成装完之后,把 ProteoWizard 目录里名字带 Clearcore 或 Sciex 的 DLL 拷进 DIA-NN 的安装目录(1.7.15 README:42);再往后 1.8、1.8.1、1.9.2 直到 2.0,README 写的还是这一套。本文讲的是 1.7.12,按老规矩来;版本差异只点到为止,不展开。
.tdf 的那位则是随包自带的 —— Bruker 家的 timsdata.dll,安装包里就带着,装载时直接调它打开 .d 文件夹(L85、L8672)。
这里头 .tdf 还有一层值得说 —— timsTOF 的招牌离子淌度。1.7.12 的处置是先收着、不使唤:装载时淌度随峰数据一起收进来,为了省空间,还把它编码进强度值里一起打包(L670、L8757–L8794);每条鉴定的 1/K0 也解出来记在结果上(L7852)。可打分、过滤一概不看它,注释自己就写着 “Ion mobility information is currently not used”,留给未来版本改进(L8884)。
再说 diaPASEF:这项支持当时还只是 “alpha-stage” 的实验品(L8883–L8886),在 1.7.12 明显还处在先收货、后开发的阶段。不管走哪条通道,最后全汇进同一种账本。
账本的每一页是一张谱图的 “报到单”:采集时间(RT)、这张谱覆盖的质荷比窗口(window_low / window_high,SWATH 分段窗口就记在这里)、还有峰数据本身 —— 峰的质荷比和峰高,一对一对地填进去(字段定义见 Scan 结构 L2598–L2601,装配现场 L8857–L8860)。MS1、MS2 各归各的队,整本账按采集时间排好,等后面的工序随取随用。
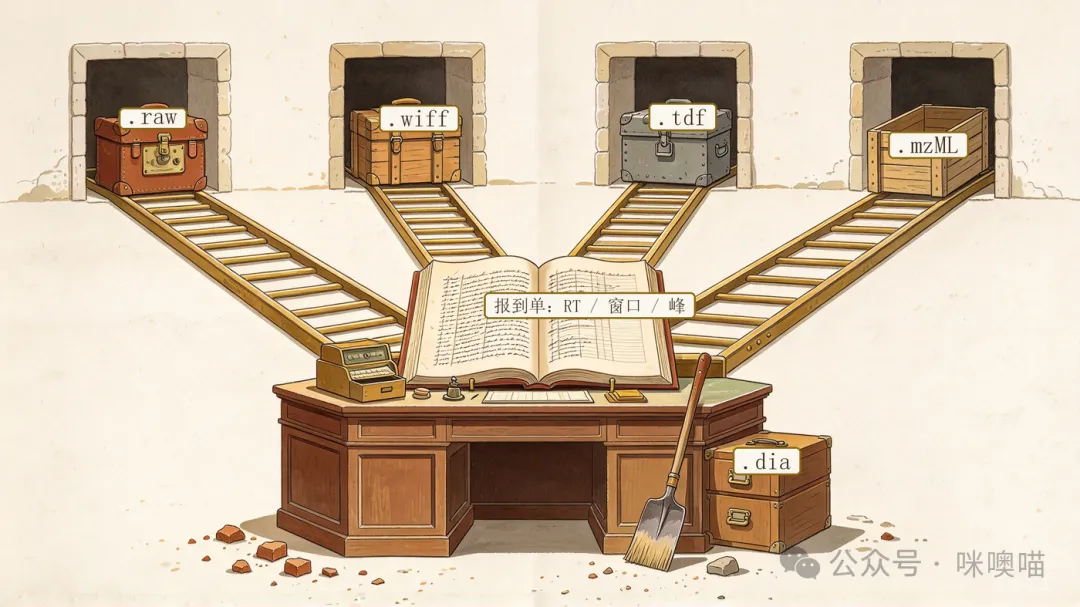
还有一种 DIA-NN 自家的 .dia,不跟这四种排队 —— 它不是仪器吐出来的货色,是引擎攒下的存档,作用有点像转换过程的中间检查点。跑一遍 --convert,甭管进来的是哪种格式,引擎都把读进内存的谱图原样存成这种存档,转换完就退出,不干别的(L10922–L10931);往后再分析,它就作为输入直接进场,秒级加载(README 的说法)。数据量大的工程,解析一趟不容易 —— 先固化成 .dia 存着,往后改参数反复跑,都不用再解析一遍。
小编碎碎念:这份账本里有两个 “口口相传” 的约定,装在函数注释里:谱必须按采集时间有序(L8825,注释原文 “Spectra in the file should be ordered by the acquisition time”),格式扩展名清单必须按字母序排(L660,注释原文 “extensions must be ordered alphabetically here”)。这两条约定上一回在 “工程风貌” 的 “约定即接口” 里已经领教过,这里按下不表 —— 只提一句:考古就有这点好,同一份源码,换个地层挖,同样的约定还会再撞见。
名单出炉:谱库递单,FASTA 炼单
原始数据报完到,还差另一半原料:该查哪些肽段的清单。这清单有两条来路,对应 DIA-NN 的两种工作模式。一种是 Library-based(谱库模式):把现成的谱库递进来(--lib),该查哪些都由谱库定。另一种是 Library-free(无库模式):不递谱库,开 --fasta-search(L1794,日志原文 “Library-free search enabled”),引擎自己把 FASTA 炼成清单。
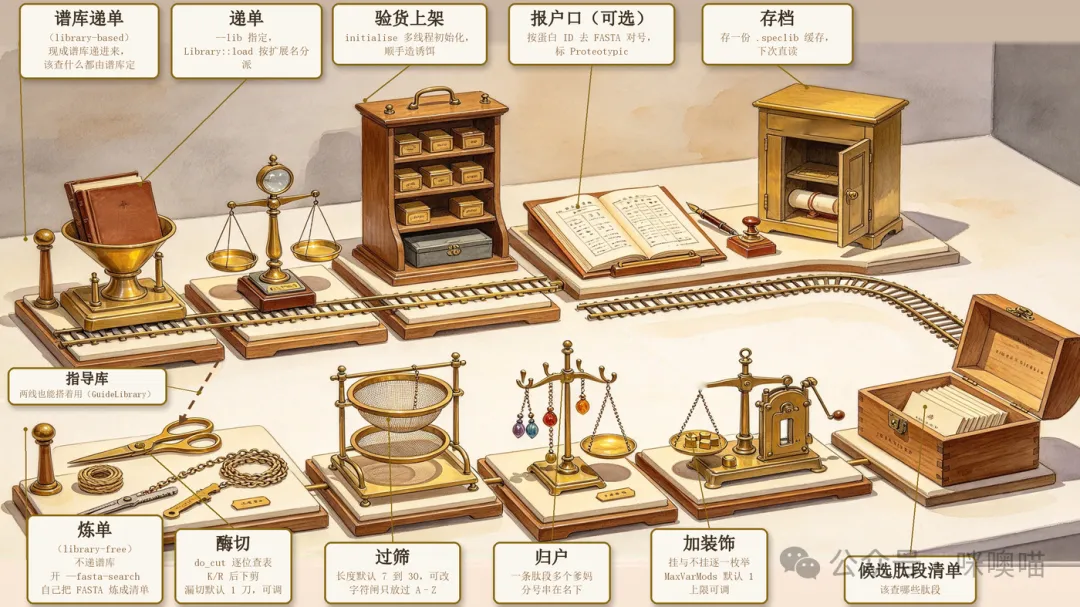
递单:Library-based 的流程
论文那个年代,DIA-NN 干活主要走这个模式;到 1.7.12 也没变 —— Library-free 是后来补上的第二条路,不是那时的主力。
这不是凭印象,源码和文档都摆着:模式开关 FastaSearch 默认是关的(L260);GUI(图形用户界面,也就是在 Windows 上打开 DIA-NN 后看到的那个操作窗口)的 Library-free 复选框出厂也没勾(Form1.Designer.cs L731–L737),手里没谱库又不开 --fasta-search,引擎会提示 “no spectral library provided, FASTA digest not enabled: nothing to do”(L2242)。
README 介绍功能时的口气也露了底:“DIA-NN now also supports library-free search ……”(README:6),示例命令走的也都是 --lib(README:66、100、110)。这条线的流程走起来是四步:
第一步,递单
--lib 指定谱库文件,Library::load 按扩展名分派(L4641 起):自家紧凑格式 .speclib 二进制直读(L4647–L4656);SpectraST/NIST 的 .sptxt/.msp 走实验性通道,加载时就提醒 “experimental”(L4671–L4673,警告原文 L4486);还有一路是表格 —— .tsv/.csv 逐行解析,表头列名模糊匹配(L4726–L4732),列名对上号就认账,各家导出的谱库表头五花八门也能对上。
第二步,验货上架
initialise 多线程初始化整个库(L5192–L5215),顺手把诱饵序列造出来(generate_decoy,L5184;开关 gen_decoys 默认开,L3553;GUI 没给这个开关,默认只能由引擎定) —— Target-Decoy 里的 “Decoy” 就是在这儿生成的。顺带提一嘴:DIA-NN 造 Decoy 的路数跟常规的 “序列反转/打乱” 不是同一种造法,具体怎么造、怎么用,等讲到打分、定可信度的时候再细说。
第三步,报户口(可选)
给了 --fasta,FASTA 就出力,力度看情况。默认干的是轻活:按蛋白 ID 去 FASTA 里对号,把蛋白名、基因名、描述这些标签换成 FASTA 的版本,条目顺手打个 Proteotypic 独苗标记 —— 归属够得着 “独” 才算数,“独” 到哪一层分三层:Isoform ID、蛋白名、基因(L338),默认按基因水平(L337);这标记管着蛋白 FDR 的计算,也管着 “只用独苗肽段算蛋白定量” 那个开关(L10063、L5379)。谱库原有的归属不动。
小编碎碎念:Proteotypic 望文生义,好些人会读成 Unique peptide —— 只此一家、别无分号的唯一肽段。差别在卡哪一层:教科书的 Unique peptide 卡蛋白层,只归一个蛋白才算;DIA-NN 默认卡基因层,同一基因几个 Isoform 共享的肽段,不归任何单独一个蛋白,照样打独苗标。要做 Isoform 分辨,得把
--pg-level设成 0,回到蛋白水平,两者才完全对等。默认偏基因层是有讲究的:报告把基因当定量实体(README 所谓 “improved protein grouping”),Isoform 之分对多数分析反而是噪声;只是查报告用数前,先想清楚按哪套规则数。
对号的过程很安静:ID 一字不差才换,对不上的原样保留,不换、不报错、不吭声(L6241–L6242) —— 所以两头 ID 长得不一样(谱库是长号、FASTA 是短号之类),注释就静默失效,这个坑得记着。
要动归属得开 --reannotate,推倒重来:旧归属全部清空,拿肽段序列反查 FASTA,归哪些蛋白重新定一遍(L10985–L10992、L4899 起);谱库压根没带蛋白信息的,走的也是这条重建的路。不给 FASTA,这步整个免谈。
第四步,存档
谱库解析过一遍(原装 .speclib 直读进来的除外),引擎顺手存一份 .speclib 缓存(L11001);下次把 --lib 指到这份缓存,就是二进制直读 —— 跟 .dia 是同一个思路:固化下来,省得每回重来。
炼单:Library-free 的理论流水线
另一条来路,是自己从 FASTA 攒清单。它的位置前面已经交代过,这里直接看流水线。Fasta::load(L3248–L3454)名字叫 load,干的却不只是读文件:FASTA 的序列读进来之后,理论酶切、过筛、归户、修饰枚举都在它肚子里一口气做完。所谓 “组合限量” 并不是单独一道工序,而是修饰枚举内部的一道上限(MaxVarMods,L3380)在管。下面按四道来看。
理论计算说明
本节 “四道” 不取样、不加酶、不开仪器;“切” “挂” 都是对序列和组合的操作,不涉及任何湿实验。
第一道:理论酶切
拿酶的 “剪刀规则” 在序列字符串上比划,把长序列切成短肽。do_cut(L1408–L1433)对着每对相邻氨基酸查规则表:切点表(Cut)说剪就剪,禁切表(NoCut)说停就停。
规则编成双字节整数,规则表里 * 可以占位,“只看前一位”((aa<<8)|'*')、“只看后一位”(('*'<<8)|next)、“两位同看”((aa<<8)|next)三种问法依次问一遍(L1410–L1417);NoCut 那一侧照猫画虎,可第一问写成了 ('*'<<8)|next,跟第二问重复,“只看前一位” 那一路就漏了(L1420–L1430)—— 想用 “K 后不剪” 这种只卡前一位的禁切规则,这套查询找不到它。
默认的切点表只写了两条:赖氨酸后(K)、精氨酸(R)后(L302);禁切表默认是空的。GUI 的酶下拉默认停在 “Trypsin/P”(0 号,Form1.Designer.cs L434–L440),下发的正是 --cut K*,R*(Form1.cs L379)—— 它不做 “后跟脯氨酸不剪” 那条经典豁免(名字里的 “/P”,指的正是 “P 挡不住切点”:K/R 后面跟着 P 也照切,这个标注不理清楚,容易理解反了)。
想恢复这条经典豁免,GUI 里把酶换成 “Trypsin”(1 号,下发 --cut K*,R*,!*P,Form1.cs L380);命令行则自己往 --cut 里写:每条规则是两个字符 —— 前一位写切点前的残基,后一位写切点后的残基,* 当通配;规则前面加 !(或 ~)就表示这条进禁切表(NoCut),比如 !*P 读作 “后一位是 P 就不剪”(L1977–L2009)。
要注意 --cut 是整张表替换,不是在默认规则上追加:代码一进来先把切点表 Cut 和禁切表 NoCut 都清空(L1980),再按你给的清单重建。只写 --cut !*P,默认的 K*、R* 也一并被清掉,等于没有切点;要留着胰蛋白酶切法,就得写全 —— --cut K*,R*,!*P。
剪完还留了余地:允许一定程度的 “没剪断” —— 漏切,默认最多漏 1 刀(L304);每个蛋白按 0 到 1 刀的各种切法摊开(L3315–L3319),切点本身由 do_cut 逐位判定(L3300–L3305)。
第二道:清单过筛
切出来的肽段长短不一,先按长度设一道闸:默认只留 7 到 30 个氨基酸的(默认值 MinPeptideLength / MaxPeptideLength,L305–L306;闸口 L3321)。
这不是写死的硬线 —— 命令行 --min-pep-len / --max-pep-len 可以改(L2011–L2014),GUI 的 “Peptide length range” 两个数字框也直接对应这两个参数(Form1.Designer.cs L910–L948,下发见 Form1.cs L387–L388)。
另一道闸查字符:序列里只要出现大写 A–Z 以外的字符 —— 小写字母、*、数字 —— 整条肽段直接跳过(L3324–L3325,注释写明是处理 SGD FASTA 里的未定义氨基酸)。大写 A–Z 都能过,过闸之后才轮到质量表:二十种标准残基之外,U(硒代半胱氨酸)、X(未定义残基)在质量表里有单独条目(L1399–L1400)—— 但 X 那格没有明确含义。
补充:X 那一格是从 MaxQuant 整表搬来的
196.995499(Da)不是 DIA-NN 定的:
init_all()(L1369–L1405)整张质量表与 MaxQuant 的MqUtil/Data/MsUtil.cs(L420–L457)逐行相同——AAs、二十种残基、U/X 两行、AA_index映射全对得上,可查到的版本里仍是这个数。这个值对应什么,MaxQuant 没说明,公开资料也查不到,只能存疑。
U 有明确残基,X 没有;X 过字符闸照常进清单,质量按该值累加(L2353–L2362),不能当可靠定义依赖。
B、J、O、Z 这类模糊代码也照样进清单,不会被字符闸跳过,可质量表没给它们留数值,只能沿用初始值 0(L1373)—— 在质量这一关等于被跳过;理论谱(按序列推算出来的碎片谱,不是仪器测的)按位累加(L2353–L2362),这几位不贡献质量。
想给这类字母补质量,官方没有专门的残基质量参数;只能借固定修饰把质量差挂上去:--fixed-mod 名字,质量,字母(L1938–L1953)会按位贴到指定残基上(L3362–L3376)。这类字母的基准质量本来是 0,挂多少就按多少算,质量能凑上。
可理论谱要算的不只有质量:碎片强度由 y_scores / y_ratio 的线性模型给(L1451–L1469),保留时间另有 RT 模型(L1488–L1496),两套模型都拿 AA_index 取系数。这张索引表把 20 种残基编成 0–19 号(字母表 L1369、映射 L1403),U、X 分别按 C 号、M 号取(L1404–L1405);B、J、O、Z 没有映射,才落到 0 号,也就是 G。
对 B、J、O、Z 来说,质量能靠固定修饰凑上,强度与 RT 却仍按 G 算,模型系数也没有参数入口可补。这算不上可用的替代方案:DIA-NN 1.7.12 实际上不支持自定义残基,FASTA 里遇到 B、J、O、Z,正路是换成标准残基或直接剔除。
还能加一份 “只查这些” 的限定名单:--fasta-filter 指向的文本一行一条肽段,先读进 filters(L1878、L3257–L3270);切出来的肽段过了前面两道闸,才拿还没挂修饰的裸序列去这份名单里做精确查找(二分,L3326–L3330),名单里找不到就丢掉。它是筛子,不是注入口 —— 名单里的肽段若没被酶切出来,也不会凭空多出来;长度、字符两道闸照样先过。
第三道:记账归户
同一条肽段可能出自好几个蛋白 —— 清单里只留一份,但把 “爹妈” 都记上(L3332–L3337):几个蛋白 ID、蛋白名、基因名,用分号一串串挂在这条肽段名下。这份血缘账后面蛋白推断要用,这里先记下。
另外,序列开头的甲硫氨酸(M)常在生物体里被剪掉。GUI 的 “N-term M excision” 出厂就是勾上的(Form1.Designer.cs L395):只要填了 FASTA,GUI 就自动补上 --met-excision(Form1.cs L376)。此时 N 端是 M(或未定义氨基酸 X)的肽段,原样版先入清单,切除首位后的版本也一并补入(L3332、L3339–L3343)—— 两条并存,不是二选一。
纯命令行跑引擎时,这个开关默认是关的(L307),清单里只留带首 M 的原样肽段;要开得显式写上 --met-excision(L2047)。
第四道:修饰枚举
清单里还要给肽段枚举 “装饰” —— 修饰。GUI 默认就给半胱氨酸挂上烷基化(“C carbamidomethylation” 出厂勾选,Form1.Designer.cs L408;下发 --unimod4,Form1.cs L392),甲硫氨酸氧化则要自己勾(--unimod35,L2039–L2044)。
装饰分两种:固定修饰(Fixed modification)当成每条都挂,直接把质量差写进序列字符串(L3362–L3376);可变修饰(Variable modification)有的人挂、有的人不挂,得逐一枚举挂与不挂的组合,展开成多条候选(L3379–L3450)。
可变修饰一展开就是乘法:一条肽段上能挂修饰的位点可能好几处,每处挂不挂、挂哪种,全展开就是成倍地涨;再乘上漏切花样和电荷态(同一段肽段可能带 2 个、3 个电荷,每个都要单独算),清单能瞬间爆仓。
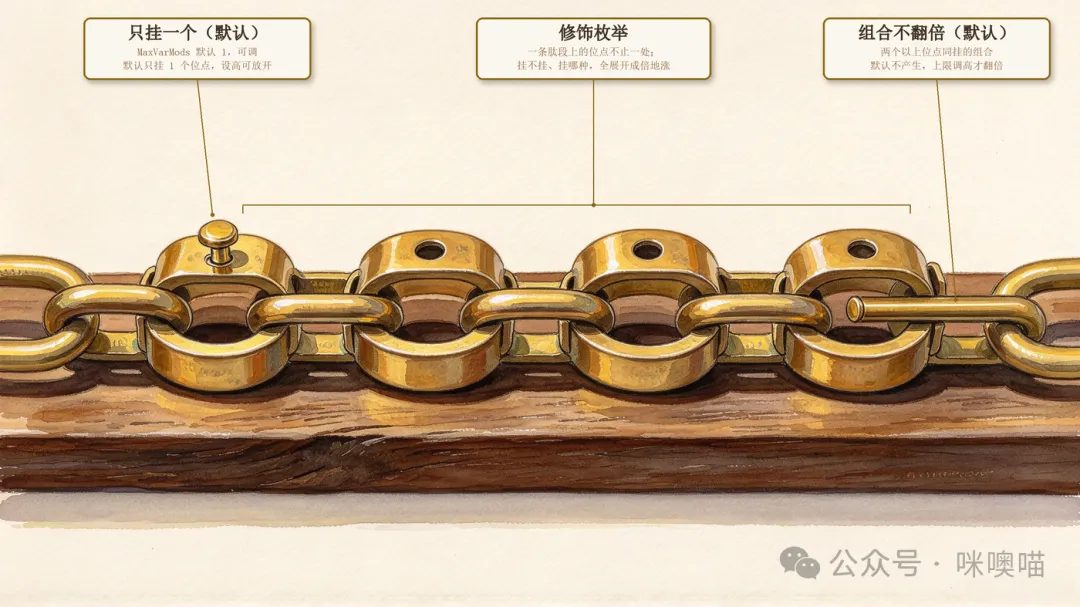
DIA-NN 的刹车就踩在这层枚举里:可变修饰默认一条都不挂 —— GUI 的 “M oxidation” 没勾、“Max variable mods” 停在 0(Form1.Designer.cs L518–L527、L740–L750),命令行不点名也一样。
一旦点名,默认一条肽段最多枚举 1 个位点(MaxVarMods 默认 1,L310;代码里它就是枚举循环的上限,m = Min(MaxVarMods, l),L3380),GUI 勾上氧化后也会把上限自动提到 1(Form1.cs L668–L672)。
要说明白的是:1 是默认值,不是天花板 —— GUI 的 “Max variable mods” 数字框下发的正是 --var-mods(Form1.cs L393–L395),引擎照这个值放开,下限 1(L2045–L2046、L2217);调高之后,两个以上位点同挂的组合才会进枚举。
小编碎碎念:这套刹车思路,往深了说就是 “宁可清单窄一点,也要每一条都查得动”。毕竟清单每长一分,后面的检索打分就多一分活儿。搜库引擎的候选清单从来不是越全越好,是越准越好 —— 把爆炸摁死在装配间,是给后面每一道工序减负。
可变修饰不在代码里预置,得自己点名 —— 名字、质量差、位点残基一起写,比如甲硫氨酸氧化 --var-mod UniMod:35,15.994915,M(L1954–L1969),嫌长也有 --unimod35 这种简写(L2042–L2044);种类还有天花板,最多认 31 种,写死(L2216–L2220),多了不候。
再配上长度 7 到 30、字符 A–Z、漏切至多 1 刀这些限制,乘法的每一维都被摁住,清单才收得住。展开本身也做得经济:每位点可挂的修饰记成一个位图,只对 “有修饰可挂” 的位点做组合(L3390–L3412),再逐位选挂哪一种(L3413–L3447)。
清单装好之后:装库先摊电荷,理论谱留给检索
四道走完,候选清单就算炼成了。清单得装进谱库条目才能被检索;装库时先干两件粗活,登记条目时顺手带上 RT 坐标,最后按肽段归组。
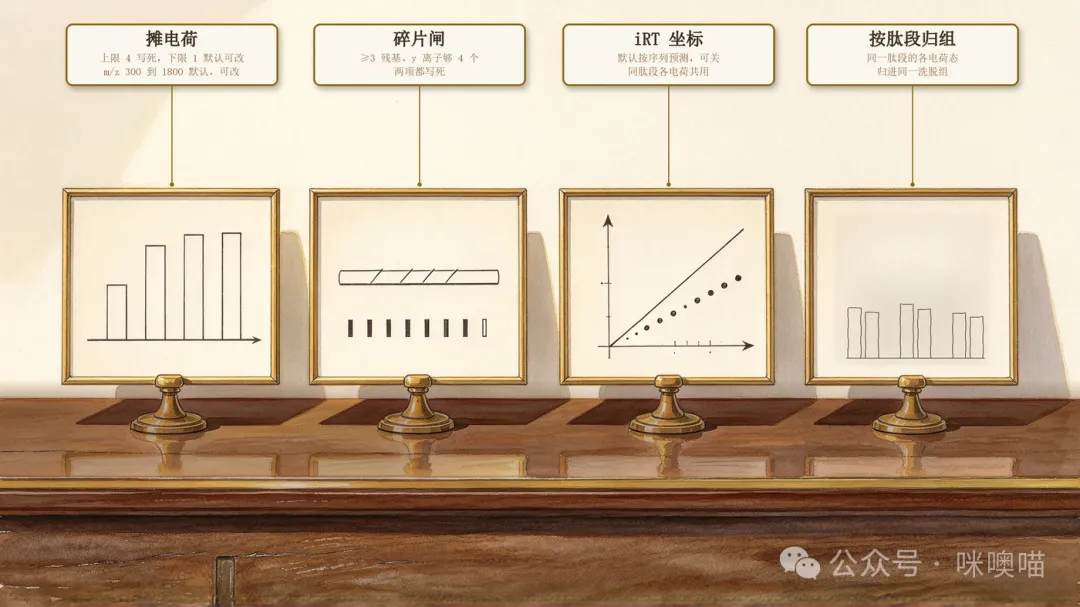
头一件,按质量把可能的电荷态摊开,每个电荷态单独登记一条(Library::load(Fasta&),L4962–L4998;电荷区间 L4975–L4982)。电荷从下限 1 摊到上限 4 —— 上限 4 写死(const int MaxGenCharge = 4,L324),把 --max-pr-charge 调高也顶不破它(L4976 取两者较小);下限默认 1,可用 --min-pr-charge 改(L319、L2027),GUI 没给这个口子。
质量还会把两头收窄 —— 肽段太轻,m/z 够不上下限,能摊的电荷自然少;太重,m/z 会超过上限,最低电荷得往上抬;最终 m/z 落在区间外的会被跳过(L4982)。区间本身不是硬线:默认 300–1800(L313),--min-pr-mz / --max-pr-mz 可改(L2019–L2022),GUI 也留了两个对应输入框(Form1.cs L389–L390)。
第二件,粗算一遍碎片,只为过 “最少碎片数” 这道闸(L4972、L4986–L4989):按单电荷把碎片质量列出来,数一数有多少个 y 离子(从肽段 C 端那头切出来的碎片)落在碎片窗口内(默认 200–1800,--min-fr-mz / --max-fr-mz 可改,L312、L2023–L2026),且每个至少覆盖 3 个残基(MinFrAAs,L311);够 4 个(MinGenFrNum,L321)才把这个 “肽段 + 电荷态” 登记成条目,不够就丢 —— b 离子虽然也一并生成,但不参与这道计数。
挡的是碎片太少、真实谱里根本认不出来的条目。这几项里,只有窗口两头能调;3 和 4 是代码里的普通常量,没有参数入口,GUI 也没留开关。
为什么只数 y 离子?
常规蛋白质组用胰蛋白酶,切点在 K、R 的 C 端,切完的肽段 C 端末位通常是 K 或 R。这两种是碱性氨基酸,最容易抓住质子;质谱采正离子模式,电荷往往就留在 C 端这头。y 离子正好保留 C 端,等于把碱性残基和电荷一起带走,信号通常比 b 离子强、也更容易连成串;b 离子常又短又弱,系列也常常残缺。这是典型胰酶肽段的普遍倾向,不是铁律 —— 乙酰化、ETD 碎裂或特殊序列都能把 b 离子抬起来。1.7.12 一路贯彻这个选择:后面生成理论谱,同样只收 y。
每条肽段还带一个保留时间坐标(iRT):默认用线性模型按序列预测(predict_irt,L1726–L1748;InSilicoRTPrediction 默认开,L276),不启用预测时取现有区间的中点(L4967)。同一条肽段的各电荷态共用这个坐标,登记时一并写入(L4977、L4983)。
最后按肽段归组:同一肽段的不同电荷虽各占一条,却归进同一个洗脱组(elution group),后面按共洗脱一起打分。这一步并非炼单独有 —— 递来的谱库一样要归组:.speclib 里已经存好就直接读,没存就现组(L4663);.sptxt/.msp 一进来就组(L4673);表格形式的谱库直接读表里的 eg_id(L4839–L4848)。炼来的清单没有现成的组,在装库末尾现组(assemble_elution_groups,L4997;分组键 to_eg,L1640)。
真正的理论谱 —— 每个碎片落在哪、强度多高 —— 留到检索时按电荷态现场补。
炼单这条路上还有个变体:仍然做 Library-free,只是额外再递一份谱库当参考,引擎称之为 “指导库”(GuideLibrary)—— 先用库里的谱图训练打分,再拿训练结果去搜 FASTA 肽段(L10955–L10961)。它影响的是检索与训练阶段,本系列后续文章会再介绍。
合流装锅:清单进运行,过闸再分批
递单也好,炼单也好,清单到这儿汇成一份,下一步就是送进检索。清单动辄成千上万条,引擎在检索前会先把它装进这次运行(load_library,L8965 起)。
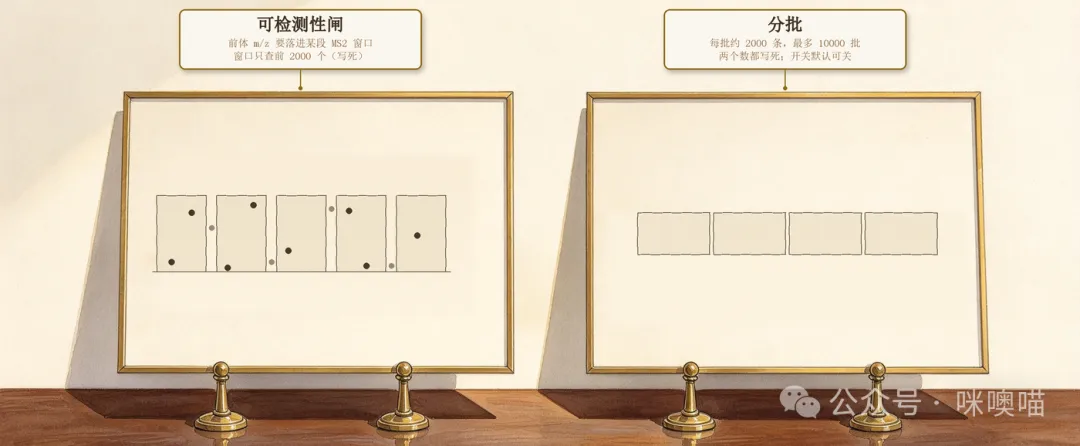
装的时候先过一道可检测性关:前体 m/z 须落在本次采集的某个 MS2 窗口里(Scan::has,L2609;只抽查前 2000 个窗口,MaxCycleLength 写死,L153、L8972);FASTA 条目还要按实际采集的 MS2 范围重新数一遍碎片,凑够同一个 “最少碎片数” 才留下(L8977–L8982;这一道不分 y、b,全部碎片都算)。过不了的不进清单 —— 日志里 “N library precursors are potentially detectable” 说的就是这一步(L8987)。
过了这一关,才给每条候选打批次号(L9000–L9013):批数先按每批约 2000 条估,再封在 10000 批以内(MinBatch、MaxBatches,L136–L139)。
GUI 上这个开关的提示说得直白:把候选随机摊进各批,为的是提速、降内存,对鉴定性能的影响可以忽略(Form1.Designer.cs L267–L269)。批大小和批数上限都写死在引擎里,界面和命令行只给了 “Process in batches” 勾选框与 --no-batch-mode 一个总开关,默认开着(L136;GUI 出厂勾选)。
“最多 10000 批” 容易被误读成处理量的天花板,其实不是:批号按取模分配,每条候选都有批号,最后都会进检索;10000 批 × 2000 条 = 2000 万条,候选超过这个数,批数不再增加,只是每批装得更多。它限制的是 “切多细”,不是 “能装多少”。至于为什么定在 1 万,源码没写注释,能确认的只是这个硬编码的批数上限;从使用规模看,按这个公式,百万级的谱库批数只有几百到几千,离上限还远,真越过去,代价是每批变大、分批的收益变弱,而不是数据被拒之门外。
到这儿,怎么找这条路就走完了:数据进门报了到,名单出炉备了料,批次也分好了。
写在后面
回头看这三步,最见功夫的不是什么花哨算法,而是拦住组合爆炸的那几道闸(限修饰、限漏切、限长度),和展开时算的那点经济账 —— 都是这套引擎里扎实的常规功夫,不算独家,但做得到位。
名单已经进了锅,后面的文章里,咱们跟着它进数据里去捞证据:检索打分、学权重、q 值、校准,看引擎怎么在万千峰里把真信号挑出来。
如果这篇对各位观众老爷有用,请伸出您尊贵的小手点个赞,小编也有更多的动力接着往下写 ~
相关文章
DIA-NN 往期文章,按发表顺序:
• 《DIA-NN 输出文件 「地图册」:从 log 到 report,告别信息 「迷茫」,关键内容一查就有 ~》 • 《GUI 能摸的 DIA-NN 参数有限?让咱们来一起看看 Windows 命令行下有没有 「隐藏宝箱」线索 ~》 • 《想让 DIA-NN 融入蛋白质组数据分析 Pipeline?试试给它搭个 Linux 「移动小屋」?》 • 《DIA-NN 最新源码里能看到什么、能学到什么:一份公开仓库的观察报告》 • 《DIA-NN 引擎源码考古 · 1.7.12 · 第一回 · 先把引擎的 「地层」看个全貌 ~》 —— 引擎地层总览,本篇的上一回。
另有一篇 Target-Decoy 与 FDR 的科普:《质谱鉴定的 「打假办」,FDR:我来算算这伙里面骗子占多少!》,感兴趣可以翻翻。
如果对质谱技术和蛋白质组学的基础概念还想打个底,可以看这篇 PPT 分享:《「中古」泡泡糖:质谱技术与蛋白质组学 | 2020 版》 —— 从质谱技术怎么一路发展过来,到肽段碎裂、碎片离子这些概念,都是科普向的讲法。