ARTICLE · 1250927
AI互连(五):Scale-Across,如何跨越数据中心共同计算?
此前,我们介绍了Scale-Up和Scale-Out。前者通过高速互连让多颗GPU形成紧密协同的计算系统,后者则通过网络将更多服务器和GPU组织成大规模计算集群。
2025年,Google在Gemini 2.5技术报告中披露,其模型使用分布在多个数据中心的TPUv5p计算集群,通过同步数据并行方式共同完成训练。
这种跨越数据中心边界的计算扩展,可以称为Scale-Across。
这一篇,我们就来介绍Scale-Across,从跨数据中心计算的需求出发,理解计算系统发生的变化、Scale-Across的实现原理及其技术边界。
一、AI计算为什么需要跨越数据中心?
AI计算任务所需的计算资源,主要取决于任务的计算量、存储需求和完成时间。
以大模型预训练为例。模型需要处理大量训练数据,通过反复计算更新模型参数。模型规模、训练数据量和训练方法,共同决定了完成训练所需的计算量。
对于一项计算量庞大的训练任务,可以使用较少GPU运行更长时间,也可以增加GPU数量,让更多计算同时进行,从而缩短训练时间。
因此,AI训练对GPU数量的需求,既来自模型参数和训练状态的存储容量要求,也来自完成训练的时间要求。
如果仅考虑计算量和完成时间,并假设计算任务能够有效并行,可以建立一个简化关系:
所需GPU数量≈总计算量÷(单GPU计算速度×目标训练时间)
但实际增加GPU后,还需要考虑不同GPU之间的数据交换和等待,计算效率不一定随GPU数量同比例增长。
随着训练规模扩大,一项任务可能需要成千上万甚至更多GPU共同参与计算。最直接的办法,是在一个数据中心内部不断增加GPU。
但数据中心的物理规模受到约束。
首先是电力。GPU运行需要持续供电,配套的服务器、网络和冷却系统同样消耗电力。当一座数据中心的供电容量达到上限时,即使还有资金购买GPU,也无法立即将更多设备投入运行。
其次是散热。GPU消耗的电能大部分最终转化为热量。随着计算设备数量和功率密度不断提高,数据中心需要配套更大规模的冷却系统。
此外,土地、机房空间、建设周期和电网接入条件,也会限制单个数据中心的扩张速度。
这些约束决定了计算资源不能无限、即时地集中到同一个地点。
当单个数据中心无法及时提供足够的GPU,而其他数据中心拥有可用计算资源时,企业就可能将同一项训练任务分配到不同地点,让多个数据中心共同完成计算。
这便产生了跨数据中心联合计算的需求。
二、跨数据中心计算带来了哪些变化?
在原有的Scale-Up和Scale-Out系统中,计算软件已经能够将同一任务分配给不同GPU执行,并组织GPU之间的数据交换、协调计算进度。
跨数据中心之后,GPU执行计算的基本方式没有改变,但计算资源的位置、数据交换路径和计算协调条件发生了变化。
1. 计算资源的位置发生了变化
在单个数据中心的计算集群中,参与同一任务的GPU集中在一个地点;跨数据中心之后,它们分布在不同地点。
因此,软件在分配计算任务时,需要更加重视GPU所在的位置,以及不同地点之间的通信成本。
2. 数据交换的路径发生了变化
原来,GPU之间可以通过数据中心内部网络交换数据。
现在,如果GPU位于不同数据中心,数据就需要经过本地网络、跨数据中心网络,再进入远端数据中心。
传输距离增加,数据交换可能需要更长时间,并受到跨中心网络带宽和拥塞的限制。
3. 计算协调的条件发生了变化
假设A数据中心完成一部分计算,B数据中心的下一步计算必须使用A产生的结果。如果数据尚未到达,B就无法继续执行这部分计算。
这种等待在原有Scale-Out系统中已经存在,但跨数据中心之后,更长的传播距离和网络传输时间的波动,可能进一步延长等待,降低整体计算效率。
此外,不同数据中心拥有相对独立的电力、网络和设备运行环境。一座数据中心出现故障,也可能影响共同执行的计算任务。
三、Scale-Across如何实现跨数据中心计算?
Scale-Across需要解决的基本问题,是让原本位于不同数据中心的GPU集群,在远距离通信成本可以接受的情况下,共同推进一个计算任务。
它并不是一种单独的光纤或交换机技术,而是计算软件、通信机制与跨数据中心网络共同形成的系统能力。
1. 建立跨数据中心的高性能网络
每个数据中心内部,GPU已经通过Scale-Up和Scale-Out网络连接起来。要实现跨数据中心计算,还需要利用光纤、交换机、路由器及光传输设备,将不同数据中心的GPU集群连接起来。
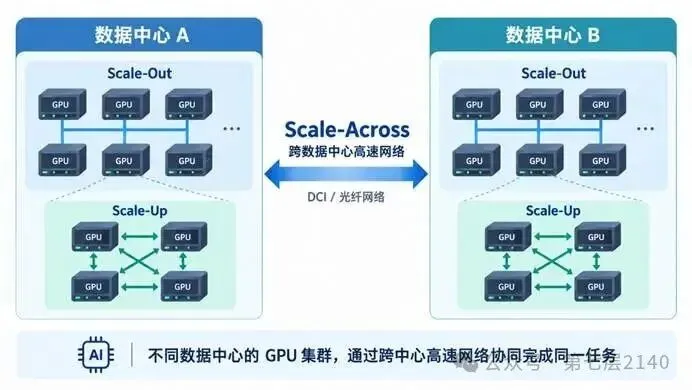
数据传输路径大致为:
GPU → 本地网卡 → 数据中心内部网络 → 跨数据中心网络 → 远端内部网络 → 远端网卡 → GPU。
这类连接属于DCI(Data Center Interconnect,数据中心互连)。传统云计算早已使用DCI进行数据复制、业务连接和跨区域资源调度。
但跨数据中心联合计算时,部分数据交换会直接影响后续计算的进度,因此对通信延迟、带宽和稳定性提出了更高要求。
例如,跨数据中心距离增加,会延长网络拥塞反馈的时间。发送端可能在收到反馈前继续发送大量数据,造成网络积压和传输延迟增加。
因此,跨中心网络需要更有效的拥塞控制和路径调度机制。
2025年,NVIDIA发布Spectrum-XGS Ethernet,在原有Spectrum-X网络基础上,引入距离感知拥塞控制、自适应路由和网络遥测等技术,提高跨数据中心的数据传输效率。
2. 重新组织计算任务与数据交换
即使跨数据中心网络的性能得到改善,远距离通信仍然需要付出额外成本。因此,计算软件还需要优化任务分配和数据交换方式。
首先是任务分配。
软件需要根据GPU的位置和计算任务之间的数据依赖关系,合理安排计算。
例如,需要频繁交换中间结果的计算,可以尽量放在同一个数据中心;相对独立、只需要在特定阶段交换结果的计算,则可以分配到不同数据中心。
其次是数据交换。
软件可以调整数据交换方式,尽量利用数据中心内部的高速网络。
例如,A、B两个数据中心共同训练一个模型,可以先在各自内部汇总计算结果,再通过跨中心网络交换必要信息,完成全局合并。
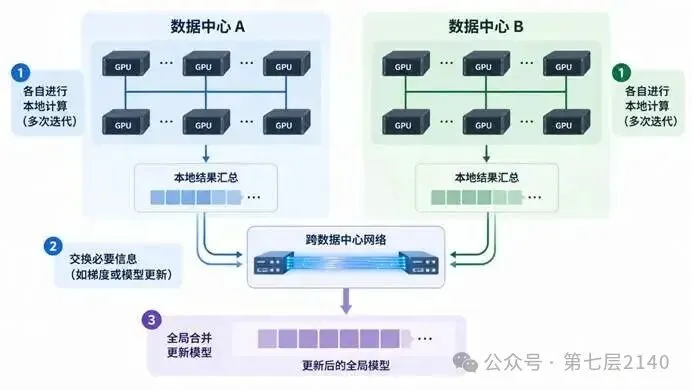
不过,全局计算仍然需要跨中心交换必要的数据。因此,软件还需要识别不同数据中心之间的网络边界,优化通信路径,避免不必要的重复传输或通信集中在少数网络出口。
NVIDIA的NCCL Cross-DC技术就是这一机制的实际应用。
NCCL(NVIDIA Collective Communications Library)是一套组织多GPU数据交换的软件库。其跨中心通信能力可以识别网络拓扑,调整Ring(环形)和Tree(树形)等通信结构,让跨数据中心交换通过更合理的路径和网络连接完成。
软件还可以让部分通信与计算同时进行,减少GPU等待远端结果的时间。
此外,跨数据中心计算还需要通过训练状态保存、故障恢复和资源重新调度等机制,降低网络中断或站点故障的影响。
四、Scale-Across能够扩展到多远?
跨数据中心联合计算已经进入实际应用。
Google在Gemini Ultra和前文提到的Gemini 2.5技术报告中,均披露了跨数据中心联合训练的真实案例。不过,Google并未公开站点间距离以及跨中心通信带来的具体效率损失。
NVIDIA披露,在相距10公里的跨中心NCCL AllReduce测试中,Spectrum-XGS相比普通商用以太网方案,获得最高1.9倍的通信带宽表现。
但这一结果仅代表特定测试条件下的数据交换性能,并不等于模型训练速度提高1.9倍。
虽然跨数据中心计算已经成为现实,但随着数据中心之间的距离增加,信号传播时间也会增加,而这一物理约束无法通过网络优化消除。
1. 光传播速度决定了远距离通信的最低延迟
光在真空中的传播速度约为每秒30万公里,在传统石英光纤中则约为每秒20万公里,即每公里需要约5微秒。
假设两个数据中心之间的实际光纤长度为100公里,光信号单程传播需要约0.5毫秒,往返则需要约1毫秒。
这些时间还不包括数据发送、设备处理及网络排队。
如果计算任务需要频繁等待远端结果,而且通信无法与其他计算同时进行,传播时间就可能反复累积,降低整体计算效率。
因此,提高网络带宽可以缩短数据传输时间,却无法消除信号传播所需的时间。
2. 空芯光纤进一步降低远距离通信的传播延迟
虽然无法突破真空光速,但现有光纤中的传播速度仍有改进空间。
传统光纤主要让光在玻璃纤芯中传播,而空芯光纤(Hollow-Core Fiber,HCF)采用特殊微结构,让光主要在空气纤芯中传播。由于光在空气中的传播速度更接近真空光速,空芯光纤能够降低传播延迟。
Microsoft披露,其空芯光纤技术相比传统单模光纤,光传播速度最高提高约47%,相应传播延迟降低约33%。自2023年以来,Microsoft已在多个Azure区域部署空芯光纤链路。
以100公里的光路为例,传统石英光纤的单程传播时间约为0.50毫秒,空芯光纤可缩短至约0.34毫秒,已经接近真空光速下0.33毫秒的理论下限。
因此,在相同的传播时间预算下,空芯光纤能够支持更长距离的数据传输。
此外,空芯光纤的大规模应用还需要考虑制造、部署、可靠性和成本。
3. 扩展边界还取决于计算方式
除了缩短通信时间,还可以通过改变计算方式,减少对远距离实时通信的依赖。
例如,如果两个数据中心每完成一步计算就必须交换结果,那么距离增加就容易影响计算效率。但如果它们能够各自计算较长时间,只在特定阶段交换结果,即使相距更远,也可能实现有效协同。
DiLoCo等低通信训练方法就是这一思路的实际探索。它允许不同计算集群先进行多次本地更新,再交换模型信息,从而降低跨中心同步频率。
不过,这可能改变模型的训练过程,需要重新验证收敛效率和模型质量,并非所有任务都适用。
因此,扩大跨数据中心计算的适用范围,主要有两条技术路径:
一是改善通信网络,缩短必要的数据传输时间;二是优化计算方式,减少必须等待远端结果的次数。
前者受到物理传播速度的限制,后者则受到计算任务依赖关系和训练算法的约束。
不同任务的数据交换量、同步频率和可容忍的等待时间不同,因此Scale-Across不存在一个适用于所有任务的固定最大距离。
此外,技术上能够联合计算,并不代表经济上一定值得采用。企业还需要比较跨中心联合计算带来的训练时间收益,与新增网络、运维、故障恢复及计算资源机会成本之间的关系。
Scale-Across扩展的是一个计算任务能够有效利用的计算资源范围,而不是简单地将不同数据中心的GPU数量相加。