ARTICLE · 1253996
AIOps for FDE 速成课 - Day2
Day 2 可观测性 Observability:AIOps 的数据地基
PART I · FOUNDATION· 优先路径必读
一句话概括 AI 的上限由数据决定:客户有哪些遥测数据、存在哪些工具里、能不能拿得到?
学习目标 · LEARNING GOALS
三大支柱:Metrics、Logs、Traces 分别回答“系统怎么样 / 发生了什么 / 问题在哪”。(→ 2.1) Monitoring vs Observability:已知问题的监控,与面向未知问题的可观测性。(→ 2.2) 看什么指标:Golden Signals、RED、USE 三种方法论及其适用对象。(→ 2.3) OpenTelemetry 与工具版图:统一的采集标准;客户提到某个工具时意味着什么。(→ 2.4 · 2.5)
本章路线 · ROUTE
2.1 三大支柱:Metrics、Logs、Traces 2.2 Monitoring vs Observability 2.3 三种“看什么指标”的方法论 2.4 OpenTelemetry:统一的采集标准 2.5 工具版图:客户提到时意味着什么 ✓ Checkpoint · Day 2
AI 的上限由数据决定。AIOps 的“数据”主要来自可观测性(Observability)体系。今天你要能回答:客户有哪些遥测数据(Telemetry)?存在哪些工具里?能不能拿得到?
2.1 三大支柱:Metrics、Logs、Traces
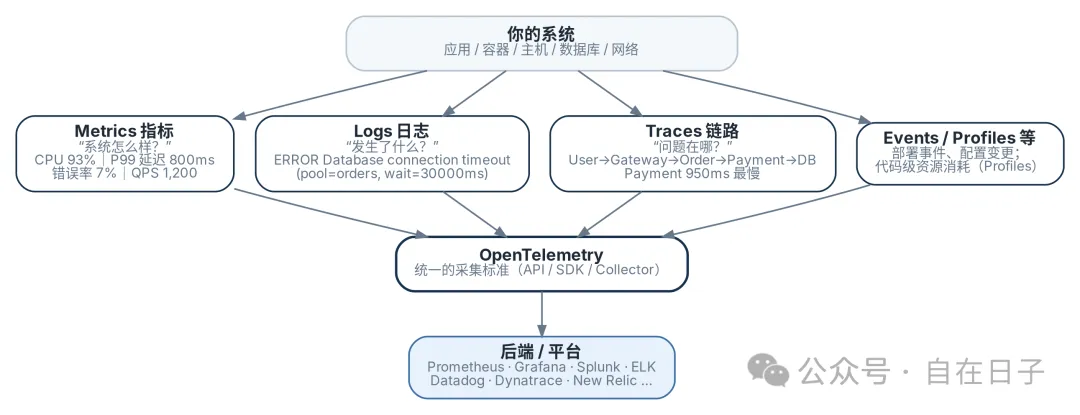
图 2-1 可观测性信号与 OpenTelemetryMetrics、Logs、Traces 与 Events / Profiles 经 OpenTelemetry 统一采集,再进入各类后端平台。
Metrics(指标)——“系统怎么样?”
Metrics 是随时间变化的数值型时间序列,体积小、便宜、适合告警和趋势分析。典型例子:
要点:Metrics 告诉你“哪里不对劲”,但很少告诉你“为什么”。另一个需要理解的概念是基数(Cardinality):如果给指标加上 user_id 这类取值极多的标签,时间序列数量会爆炸,成本和性能都会出问题。
Logs(日志)——“发生了什么?”
Logs 是带时间戳的离散事件记录,信息最丰富,也最昂贵。例如:
WORKED EXAMPLE · 日志样例
2026-09-18T10:02:13.482Z ERROR [payment-svc-7d9f] c.x.pay.DbClient -Database connection timeout: pool=orders-db, active=10/10, waited=30000mstrace_id=4bf92f3577b34da6a3ce929d0e0e4736
日志可以是非结构化文本,也可以是结构化的 JSON(推荐)。日志的挑战是量巨大(每天 TB 级很常见)、格式五花八门、保留期有限(很多企业只保留 7–30 天热数据)。这对 LLM 的上下文窗口是直接挑战(见 Day 5)。
Traces(链路追踪)——“问题在哪?”
Trace 记录一个请求穿过分布式系统的完整路径,由多个Span(每一跳的操作)组成,通过trace_id串联。下面这个请求总耗时约 1.06 秒,一眼就能看出瓶颈在 Payment:
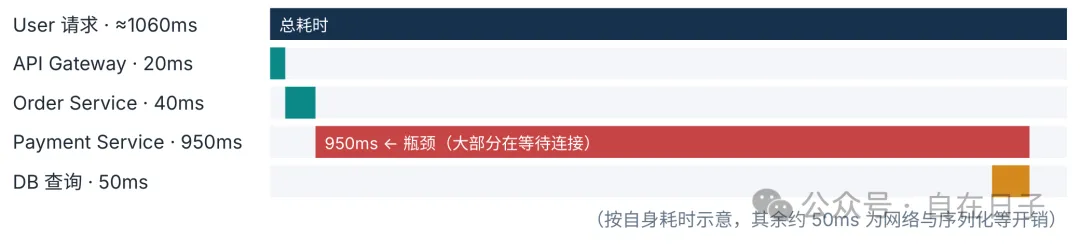
(按自身耗时示意,其余约 50ms 为网络与序列化等开销)
说明:DB 查询本身只有 50ms,但 Payment 的 950ms 中有大量时间花在“等待获取数据库连接”上——这与上面的日志 waited=30000ms 以及连接池配置错误相互印证。单一信号往往不够,三种信号关联起来才能定位根因。
★ 必须掌握的一句话Metrics = 系统怎么样;Logs = 发生了什么;Traces = 问题在哪。三者通过时间戳、服务名、trace_id 关联起来,才是完整的可观测性。
其他信号:Events、Profiles、Baggage
Events:部署、配置变更、扩缩容、功能开关切换等离散事件。在 OpenTelemetry 中,Events 被定义为一种特殊的日志(截至本手册撰写时仍在发展中)。变更事件对 RCA 极其重要。 Profiles(持续性能剖析):代码级资源消耗记录(哪个函数吃 CPU/内存),OpenTelemetry 将其列为发展中的信号。 Baggage:在信号之间传递的上下文信息(如租户 ID),OpenTelemetry 当前支持的信号之一。
2.2 Monitoring vs Observability
简言之:Monitoring 回答“已知的未知”,Observability 帮你应对“未知的未知”。监控是可观测性的子集,两者不是替代关系。
2.3 三种“看什么指标”的方法论
FDE 视角 · 怎么用 服务层看 RED/黄金信号(用户是否受影响),资源层看 USE(哪个资源撑不住)。本书示例中:Payment 延迟升高是 RED 层症状,连接池饱和(10/10)是 USE 层原因。
2.4 OpenTelemetry:统一的采集标准
OpenTelemetry(OTel)是 CNCF 的开源项目,提供厂商中立的 API、SDK 和Collector,用于生成、采集和导出 Traces、Metrics、Logs。它的意义在于:采集一次,可以发往任何后端(Prometheus、Jaeger、Splunk、Datadog、Dynatrace 等都支持 OTel 数据)。OTel 还定义了语义约定(Semantic Conventions),统一了 service.name、http.response.status_code 等字段命名——这对 AI 跨系统关联数据非常有帮助。
客户这么说时
客户原话:“我们正在推 OpenTelemetry。” 你该如何理解:客户的遥测数据正在标准化,trace_id 贯通的可能性高;也意味着他们可能在考虑摆脱单一厂商锁定。 可能的切入点:数据接入会更容易。
2.5 工具版图:客户提到时意味着什么
注:表中“云上/互联网”“大型企业”“成本敏感”等描述为典型场景,仅作为快速识别线索,不代表产品边界;实际客户画像以现场了解为准。
FDE 视角 · 数据可得性比工具名更重要 记下工具名后立刻追问三件事:(1) 有没有 API 可以读?(2) 数据保留多久?(3) 谁能审批我们访问?很多 POC 死在“拿不到数据”这一步,而不是模型不行。
✓ Checkpoint · Day 2
1. 分别用一句话说明 Metrics、Logs、Traces 各自回答什么问题。 2. 一个请求总耗时 1 秒,Trace 显示 Payment Span 占 950ms,但它下游的 DB Span 只有 50ms。你会怀疑什么? 3. Monitoring 与 Observability 的核心区别是什么? 4. RED 和 USE 方法分别适合观察什么对象? 5. 客户说“我们用 Dynatrace”,对你设计 AI 方案有什么启示? 得分 ____ / 5 · ≥4/5 Ready · 3/5 Review · 0–2/5 Revisit ·