ARTICLE · 1255923
让机器真正"读懂"文档:中科逸视智能文档抽取技术拆解
让机器真正"读懂"文档:中科逸视智能文档抽取技术拆解你有没有过这样的经历——手里攥着一沓合同、发票、申请表,翻来覆去只为找到某个关键数字?或者见过窗口工作人员对着扫描件,一个字一个字地往系统里敲? 在 AI 已经能写诗作画的今天,我们对付文档的方式,很多时候依然停留在"肉眼阅读 + 手工录入"。据统计,企业里超过 80% 的数据以非结构化形式存在——合同、扫描件、PDF、照片里的表格……这些文档像一座座上了锁的宝库,明明藏着宝藏,却怎么也打不开。 中科逸视(北京)科技有限公司的智能文档抽取系统,就是想当那把开锁的钥匙。 先搞清楚:OCR 和"智能文档抽取"差在哪 很多人以为 AI 读文档就是文字识别(OCR),其实差得远。 传统 OCR 说白了是个"文字搬运工"——它能把图片里的字搬成可编辑的文本,但搬完之后,它并不知道这些字是什么意思。比如它能认出纸上写着"合同总价款五百万元",却未必知道这串数字就是这份协议的核心金额字段;它能认出"甲方"和"乙方"两个词,却分不清谁出钱、谁收钱。 中科逸视的智能文档抽取系统,做的不是"看见",而是"读懂"。它的核心技术架构可以概括为八个字:OCR 做眼睛,大模型当大脑。下面一层层拆开看。 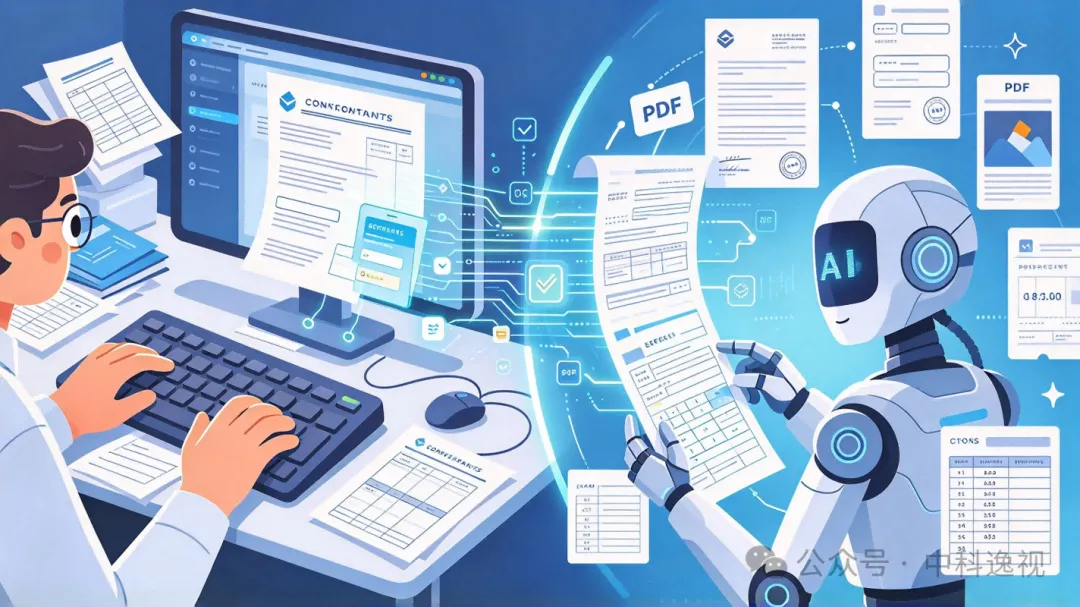
技术原理:三步走,从图像到数据 第一步:高精度 OCR——给文档拍一张"X 光片" 文档进来的第一关,是 OCR 视觉引擎。企业真实场景里的文件五花八门:扫描复印的旧合同、拍照的传真件、盖章盖住部分文字的协议、光线昏暗的手机照片、带手写批注的单据……传统识别工具碰到这类文件很容易"翻车"。 中科逸视采用的是基于 CNN-Transformer 混合架构的深度学习 OCR 模型。说人话就是:它既能像"老中医"一样整体把握,又能像"福尔摩斯"一样抠细节。 在图像预处理阶段,系统集成了自适应二值化、透视校正、去噪增强等算法。翻译一下:文档拍歪了?帮你扶正。光线太暗?帮你调亮。有印章遮挡?帮你"透视"修复。印刷体识别准确率可达 99.5% 以上——比人工录入还靠谱。 更关键的一点:这个 OCR 不只是输出一堆零散文字,它还同步记录每个字的坐标位置、字体大小、段落关系、表格布局等"空间线索"。通俗讲,它不光知道写了什么字,还记住标题在哪、表格在哪、哪一段是付款条款——整篇文档的"版面骨架"被完整保留下来,为下一步的语义理解打下基础。 第二步:大模型语义理解——给机器装上"大脑" 拿到 OCR 输出的文字和版面信息后,就轮到大语言模型上场了。 这颗"大脑"不是随便拿来就用的,而是经过了精心调教,分两步走: 经过这番调教,模型不再是机械匹配关键词,而是基于对全文语义的理解来抽取:自动分辨哪一家是甲方、哪一家是乙方;区分"甲方付款"还是"乙方付款";在跨页表格和分散附件里,把金额、履约期限、违约责任、交付条件一一拎出来。哪怕"统一社会信用代码"出现在营业执照的左上角、右上角还是表格里,它都能认出来。 第三步:深度融合——OCR 和大模型"打配合" 最精彩的部分来了:这两个模块不是简单的流水线关系,而是深度耦合、互相补台。 举个例子:当 OCR 对某个区域的识别不太确定(比如把"有限责任公司"误读成"有限贡任公司"),这个信息会传给大模型。大模型一看上下文——"哦,这里应该是个公司类型"——立刻结合语义完成纠错。反过来,印章位置、签名区域、表格排布逻辑这些视觉信息,也会辅助大模型判断字段归属,规避纯文字理解的误差。 整套流程——文档上传 → 图像修复识别 → 版面解析 → 语义抽取 → 校验 → 结构化输出——端到端打通,最终输出 JSON、Excel 等标准化数据,直接对接企业的 ERP、OA 或合同管理平台。 功能特点:四个"黑科技"亮点 版式无关,一套模型通吃 少样本启动,不用"教" 复杂结构轻松拿捏 不止是文字 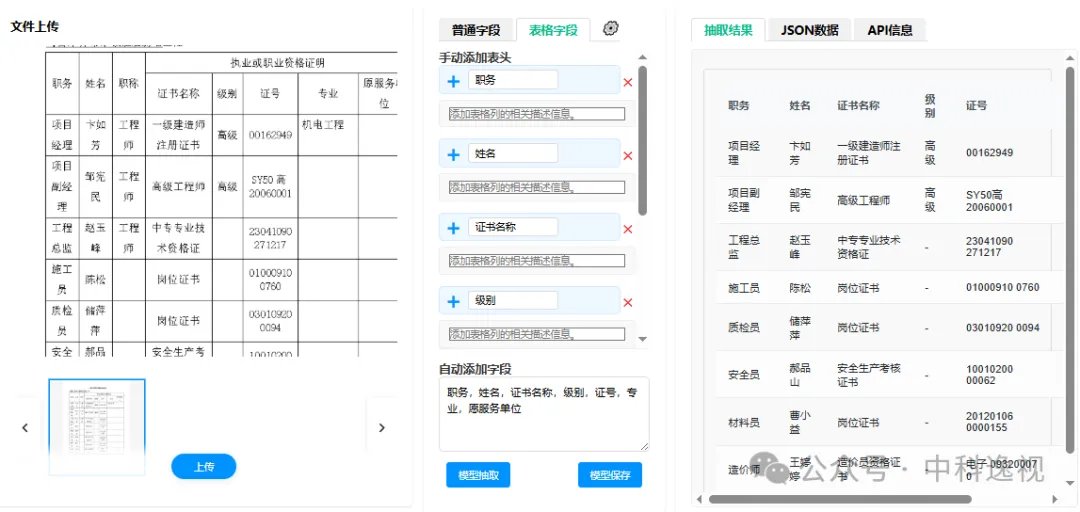
应用领域:无处不在的"隐形助手" 文档抽取技术的落地面其实非常广: 写在最后 中科逸视的智能文档抽取技术,本质上是在做一件事:让机器真正理解文档。 传统的数字化是把纸变成电子版——相当于把一本书从书架搬到电脑里,但你还是得自己一页页翻。而这套系统做的,是给这本书自动生成目录、摘要和索引——你问什么,它直接告诉你答案。 它不是要替代法务、财务这些专业岗位,而是把人从海量摘抄、录入的机械劳动里解放出来:AI 做信息搬运,人专注判断与决策。在非结构化数据占企业数据总量超过 80% 的今天,让沉睡在合同、票据、证照里的数据真正"活"起来——这或许就是 AI 最迷人的地方。
领域自适应预训练:让模型"吞下"海量政务文书、合同文本、行业报告等真实业务文档,先熟悉特定行业的术语、句式和逻辑——好比医学生先啃完所有医学教材。 指令微调:系统采用 LoRA 轻量化参数微调技术,只需要 2-5 份典型文档样本做简单标注,就能教会模型一个关键技能——从杂乱的文本中精准定位你想要的信息。你说"把签约金额找出来",它就能做到。
打个比方:OCR 相当于把一本纸质书扫描成电子文字;大模型则像一位熟读各类合同的法务助理,读完自动摘出签约双方、金额、时间、风险要点,整理成一条条清晰条目。
PDF、扫描件、手机拍照、网页截图……无论版式多"任性",都不用重新训练或配模板。它靠"视觉 + 语义"双管齐下自动理解版面,真正做到"一模型适配千种版式"。
不需要准备成百上千份标注样本,更不用写一堆正则规则。只要提供几份典型样本、告诉系统"我要提取合同金额",它立刻就能干活——开箱即用,省掉 90% 的准备工作。
跨页表格、合并单元格、多栏混排、图文混排——这些让传统 OCR 头大的场景,系统都能从容应对,甚至能自动识别跨页表格的连续性,保证数据完整。手写签名和批注也做增强识别,改过的关键内容不会被漏掉。
表格、公式、签章信息一体化抽取,既能抓取纯文本字段,也能还原多层嵌套表格结构,实现"文-表-图"一体化解析。
政务服务:政务大厅每天要处理海量申请表单。窗口人员扫描材料后,系统几秒内完成关键信息提取并预填入业务系统,工作人员从重复录入中解放出来。 金融保险:银行流水分析、电子保单处理、理赔报案录入——系统瞬间提取保单号、车主信息、出险时间等关键信息,自动完成案件创建,大幅缩短审批流程。 合同管理与合规审核:自动建合同台账,批量抽取合同编号、签约主体、金额、有效期等字段;多轮谈判产生多个版本后,自动比对关键条款差异,帮法务揪出隐蔽的修改;定向筛查违约责任、保密义务等风险条款,给合规兜底。 医疗健康:病历、处方、检验报告自动提取患者病史、用药记录、诊断结果,辅助构建电子健康档案。 物流行业:运单、发票、装箱单、报关单这些曾压垮效率的"纸山",可以秒级完成信息录入。